 峤咚笔记
M606丨一键批量生成100条自己的专属口播数字人视频
短视频数字人工具相信大家都多多少少接触过,但缺点是你每次都需要繁琐的在网页或者软件上填入各种信息。
如下数字人合成界面,至少需要7-8步才能完成一个口播视频的生成,当然对于99%的用户来讲已经足够方便,但对于我这种矩阵型选手,从来思考的都是:有没有一键批量的方式
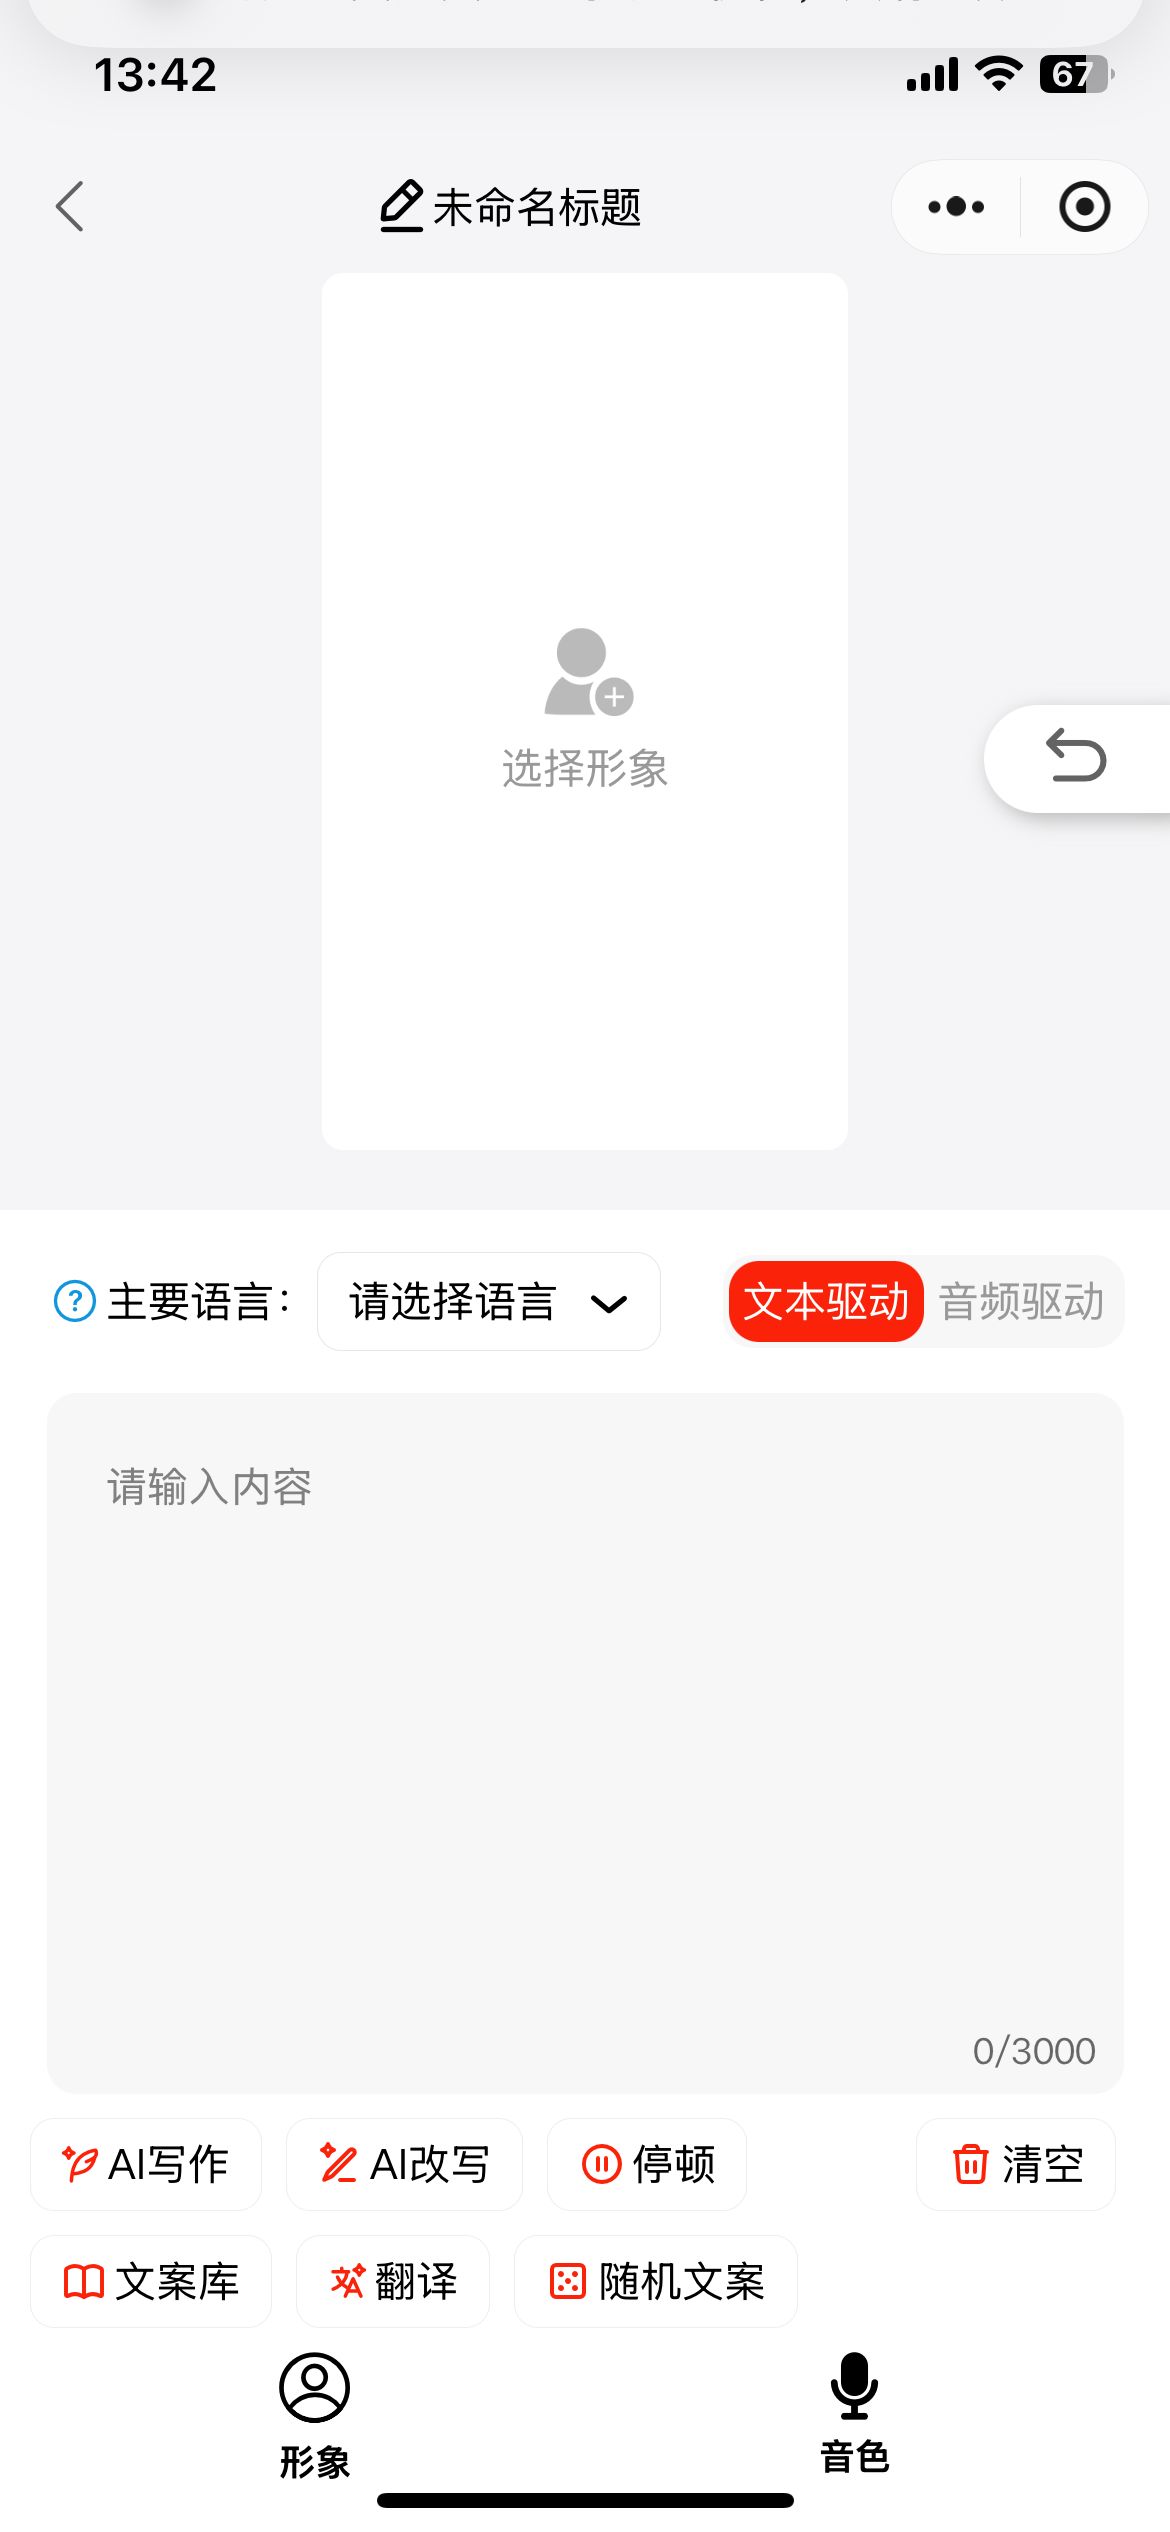
要实现一键批量,其实有两个选择
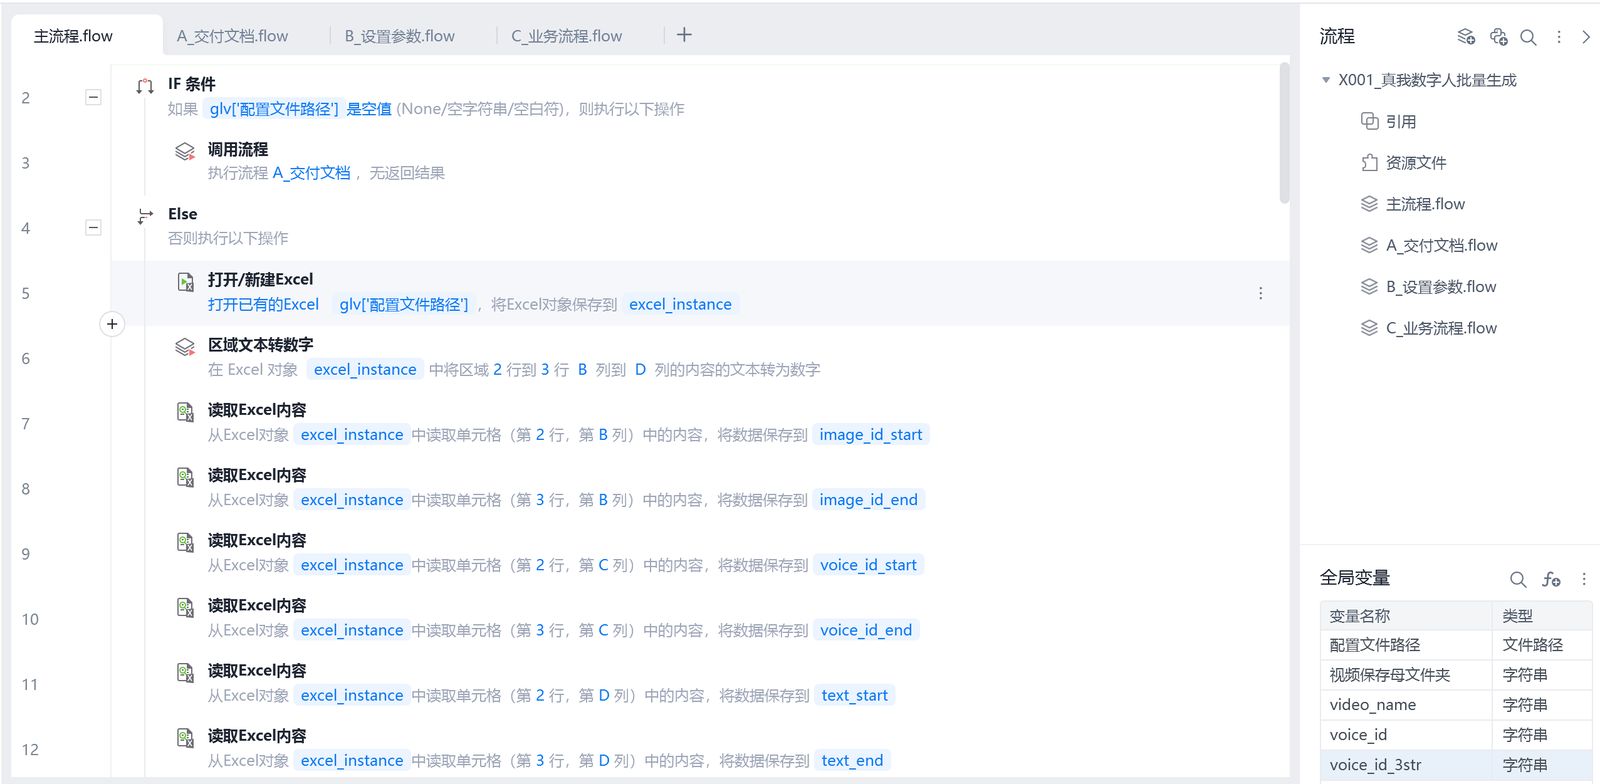
RPA,设置好相关参数,让影刀去帮你在网页操作
工作流,开发出相关接口,利用工作流批量执行
我首先尝试了RPA方案,效果也是ok,但就是运行的时候电脑放在那里不能动,对于我这种常年在外出差只带一部笔记本的人来说还是太不方便了。
不得已我又要求技术把数字人的API接口开发出来。
利用API我制作了coze插件,并且用coze搭建一个一键生成自己形象的数字人智能体,最终实现一键批量生成100个自己专属形象和声音的数字人视频。
可实现功能
克隆自己的专属音色
文本转语言(使用克隆音色或公共音色)
克隆自己的形象,支持动态场景
生成对口型数字人(支持克隆形象和公共形象)
批量提取多条链接文案,二创后生成数字人
查询音色id和形象id(7/2新增)
目录
零、搭建思路
一、语音克隆工作流
二、形象克隆工作流
三、获取音色和形象id工作流
四、数字人视频工作流
五、一键批量工作流(案例)
其他一件批量思路
本文较长,但入手难度不高,以下正文,enjoy~
如何创建Coze智能体和创建工作流的方法不再赘述,有不清楚的可以参考如下教程
零、制作插件
这次的工作流极度依赖基于API开发的数字人插件,因此要理清工作流的思路,必须要搞懂插件可实现的功能和应用。
API文档(必须使用电脑浏览器查看):https://dhm.jinhuaclub.com/#/consoleDesk/document?doc_id=6
下面是利用API文档去搭建数字人插件的思路
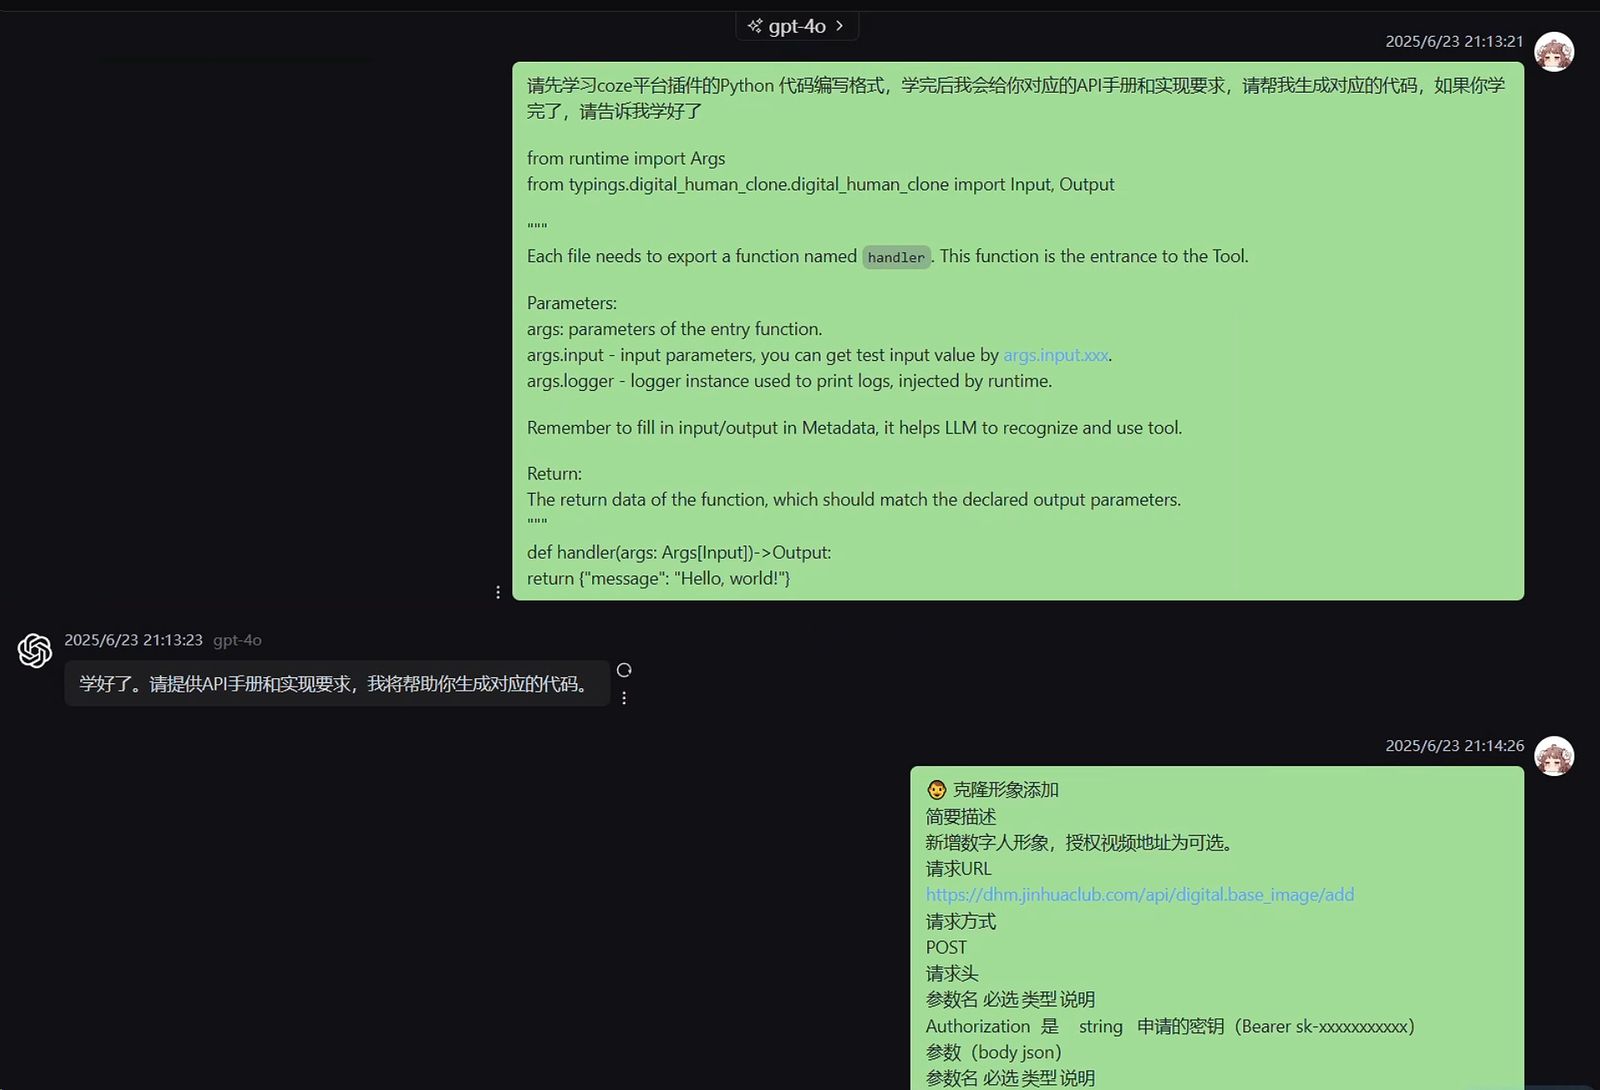
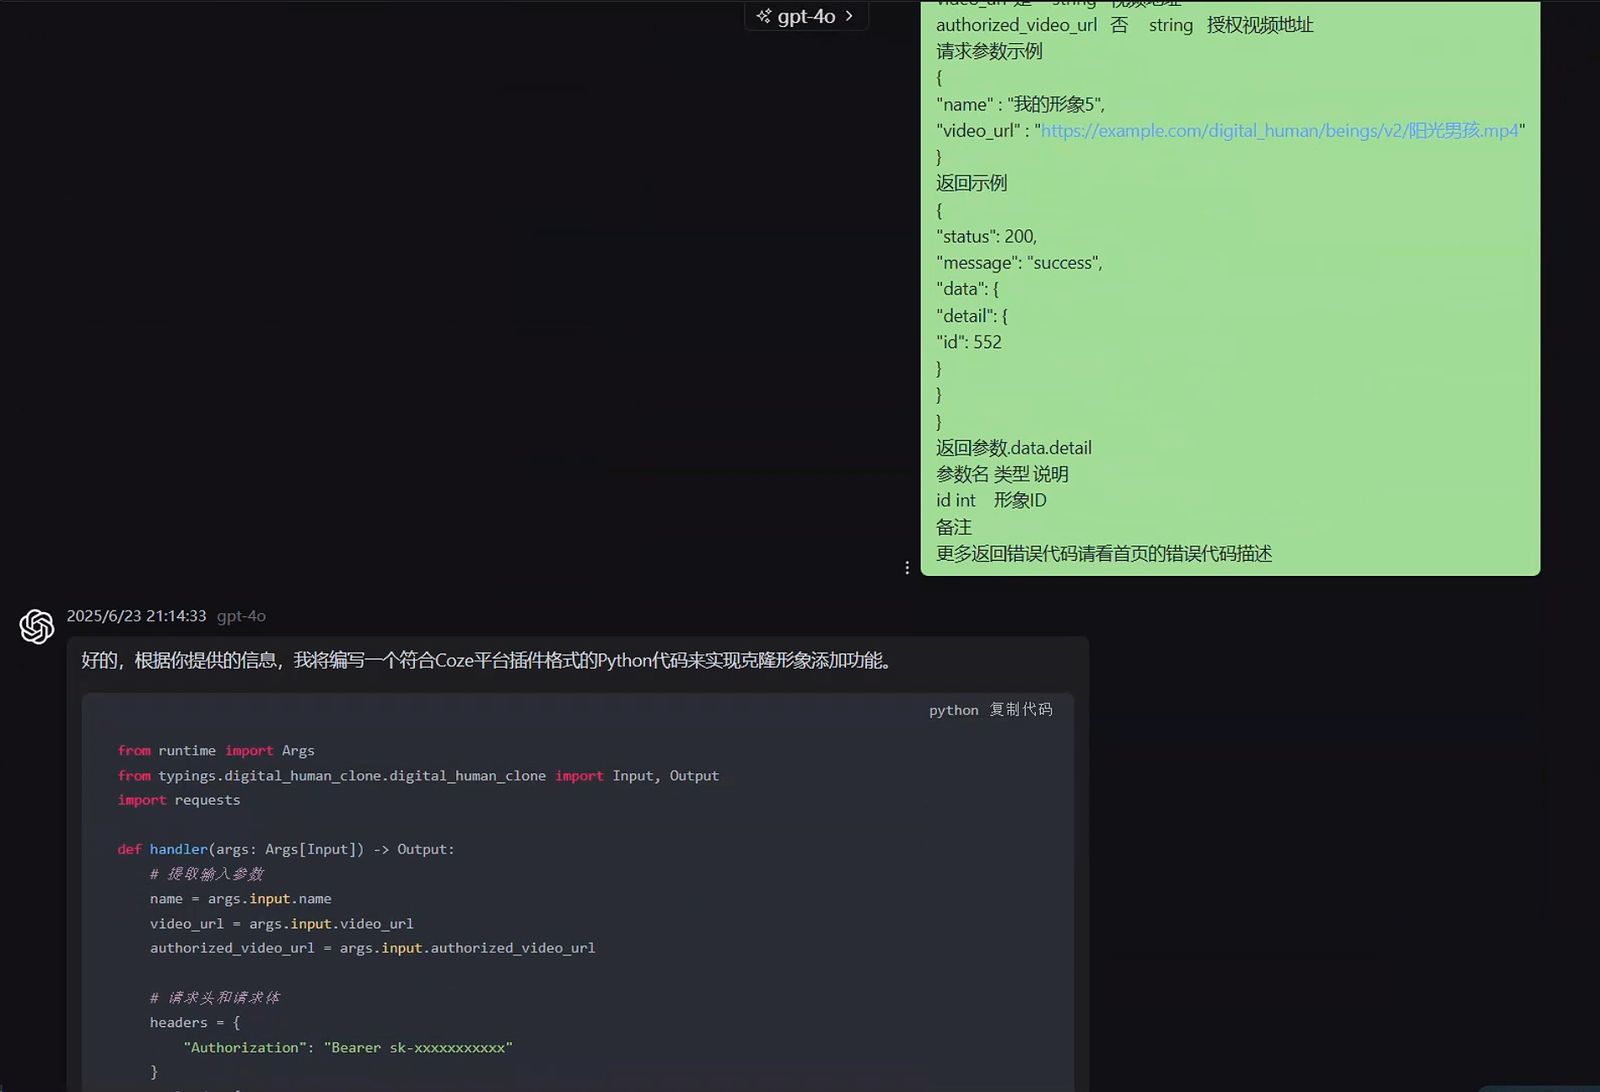
第一步:把coze插件的示例代码发给GPT-4o,让他学习规则
第二步:把API文档发给GPT-4o,让他输出代码
第三步:把代码复制到coze中,创建插件
一定要善于利用AI帮我们解决智能体搭建路上的问题,我本身没有任何编程基础,所有插件和函数的搭建全部都是由deepseek-r1和chatgpt-4o帮我完成的
为方便大家使用,已把插件上架到Coze商店中(https://www.coze.cn/store/plugin/7519190960996253747),大家无需再自建插件
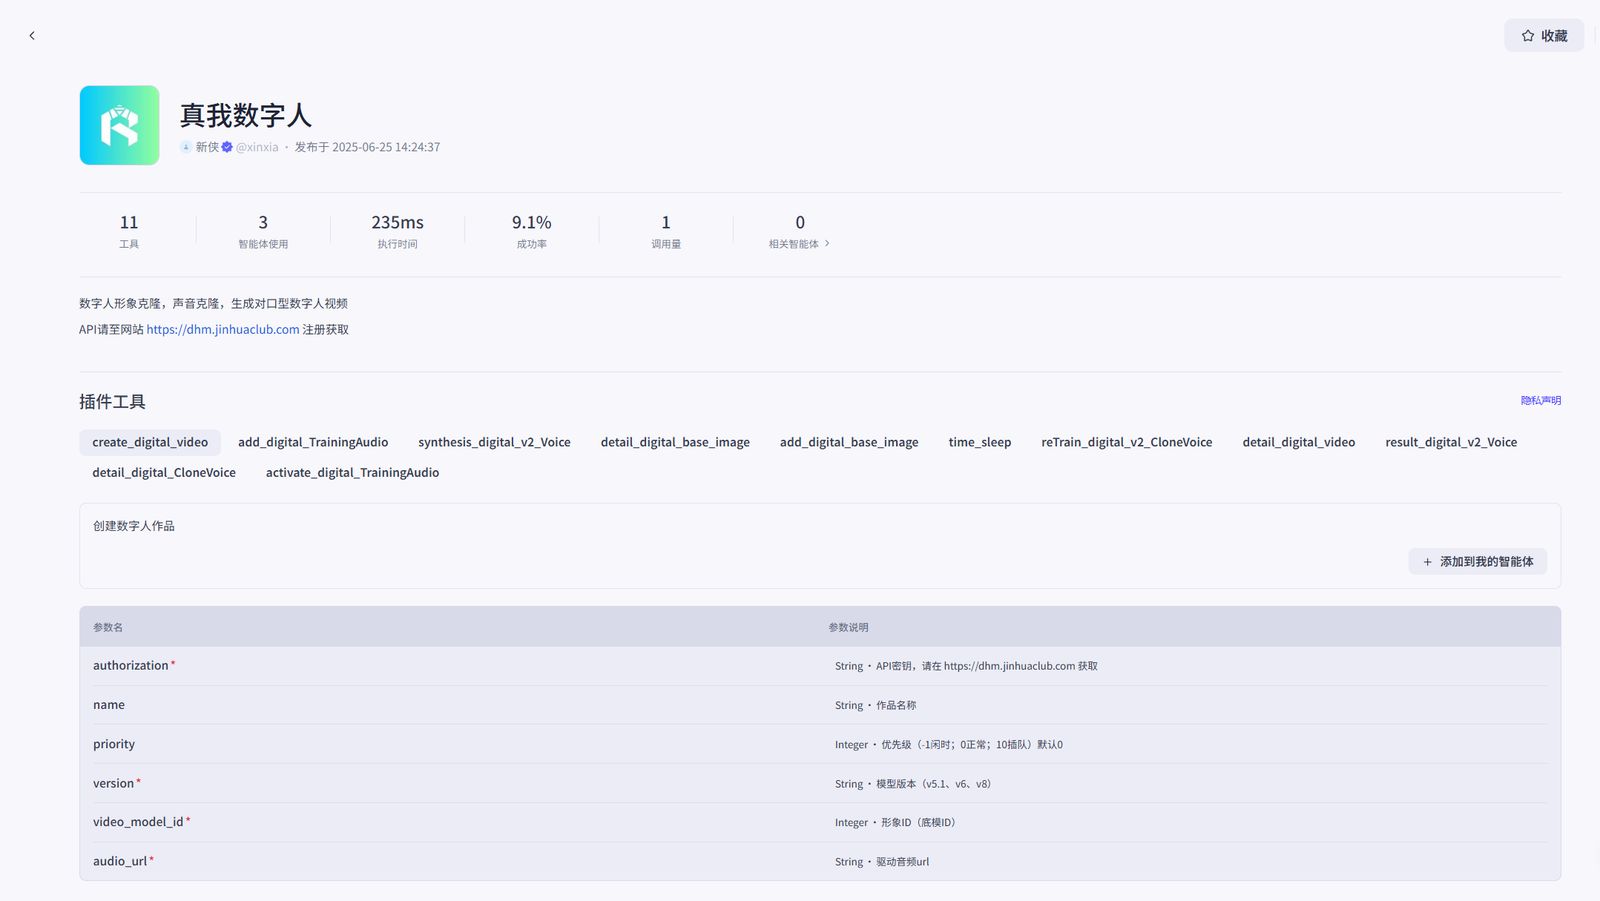
add_digital_TrainingAudio 音色素材添加
activate_digital_TrainingAudio 音色素材激活
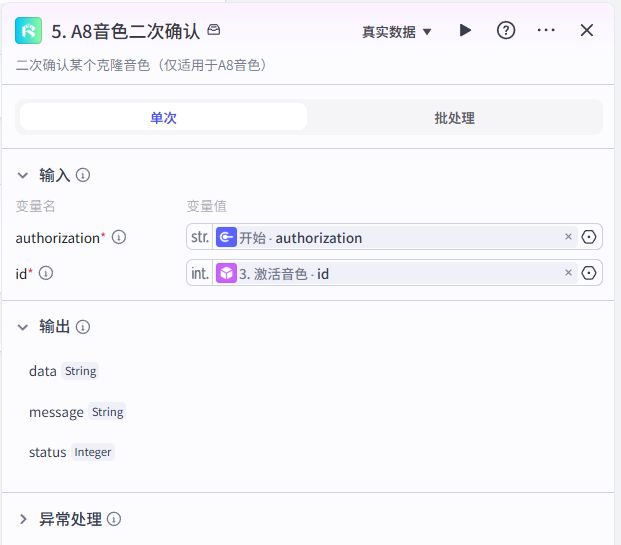
confirm_A8_CloneVoice 二次确认某个克隆音色(仅适用于A8音色)
detail_digital_CloneVoice 克隆音色详情
reTrain_digital_v2_CloneVoice 克隆音色重新训练
list_digital_CloneVoice 获取克隆音色列表(7/2新增)
add_digital_base_image 新增数字人形象
detail_digital_base_image 获取当前用户的某个数字人形象
list_digital_base_image 获取数字人形象列表(底模列表)(7/2新增)
synthesis_digital_v2_Voice 音频任务创建
result_digital_v2_Voice 文本转语音任务结果查询
create_digital_video 创建数字人作品
detail_digital_video 获取当前用户的某个数字人作品
time_sleep 延时
根据插件,我们可以理出工作流的搭建思路
声音克隆
音色素材添加 – 音色素材激活 – 轮询克隆音色详情 – 获取音色id
形象克隆
克隆形象添加 – 轮询克隆形象详情 – 获取形象id
音频合成
创建音频合成任务 – 轮询音频任务详情 – 获取音频url
视频合成
根据音频url创建数字人作品 – 轮询数字人作品详情 – 获取作品url
思路清晰了,咱们就直接来搭建工作流
我在把这篇文章初版写完之后,突然发现对于普通用户来讲仅仅是为了获取形象id和音色id,就要额外搭建两个工作流,这其实是一个大麻烦
于是我又要求技术把id信息直接放在前台中,用户登录PC端即可直接可视化的获取对应的ID信息,技术回复说这个功能要等到大概8月份才能上线
然后我就又逼着他做了两个临时接口,这样就可以前台克隆音色和形象,快捷获取id信息
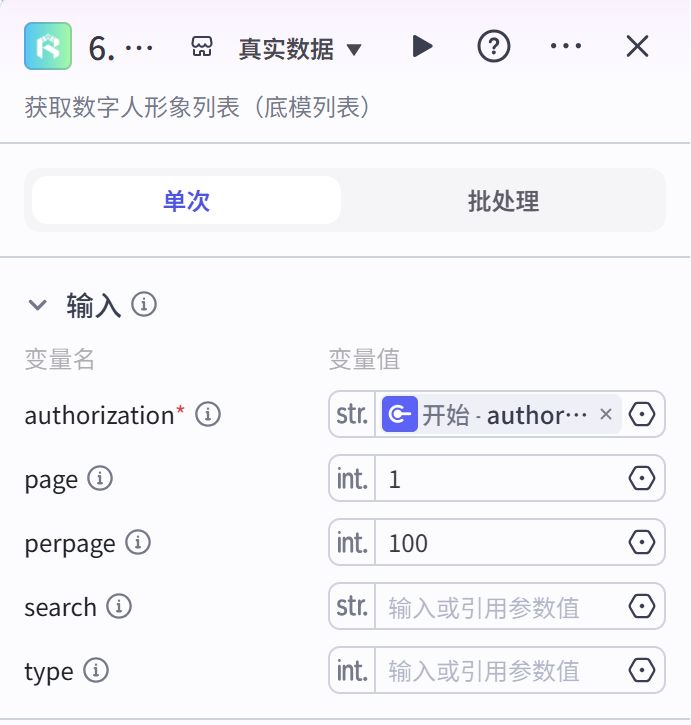
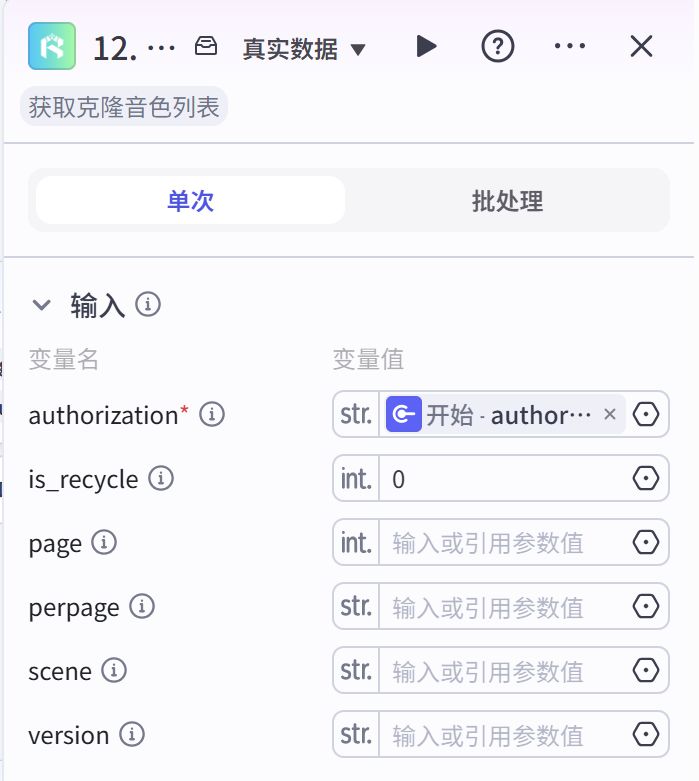
一键获取音色id列表
一键获取形象id列表
PS:目前PC端和工作流的数据进行同步,即你在工作流中创建对应的克隆和作品,PC端同步显示完成
基于以上,章节一(语音克隆工作流)和章节二(语音克隆工作流)大家可以选择跳过不看,直接看章节三(一键获取音色和形象id)
一、语音克隆工作流
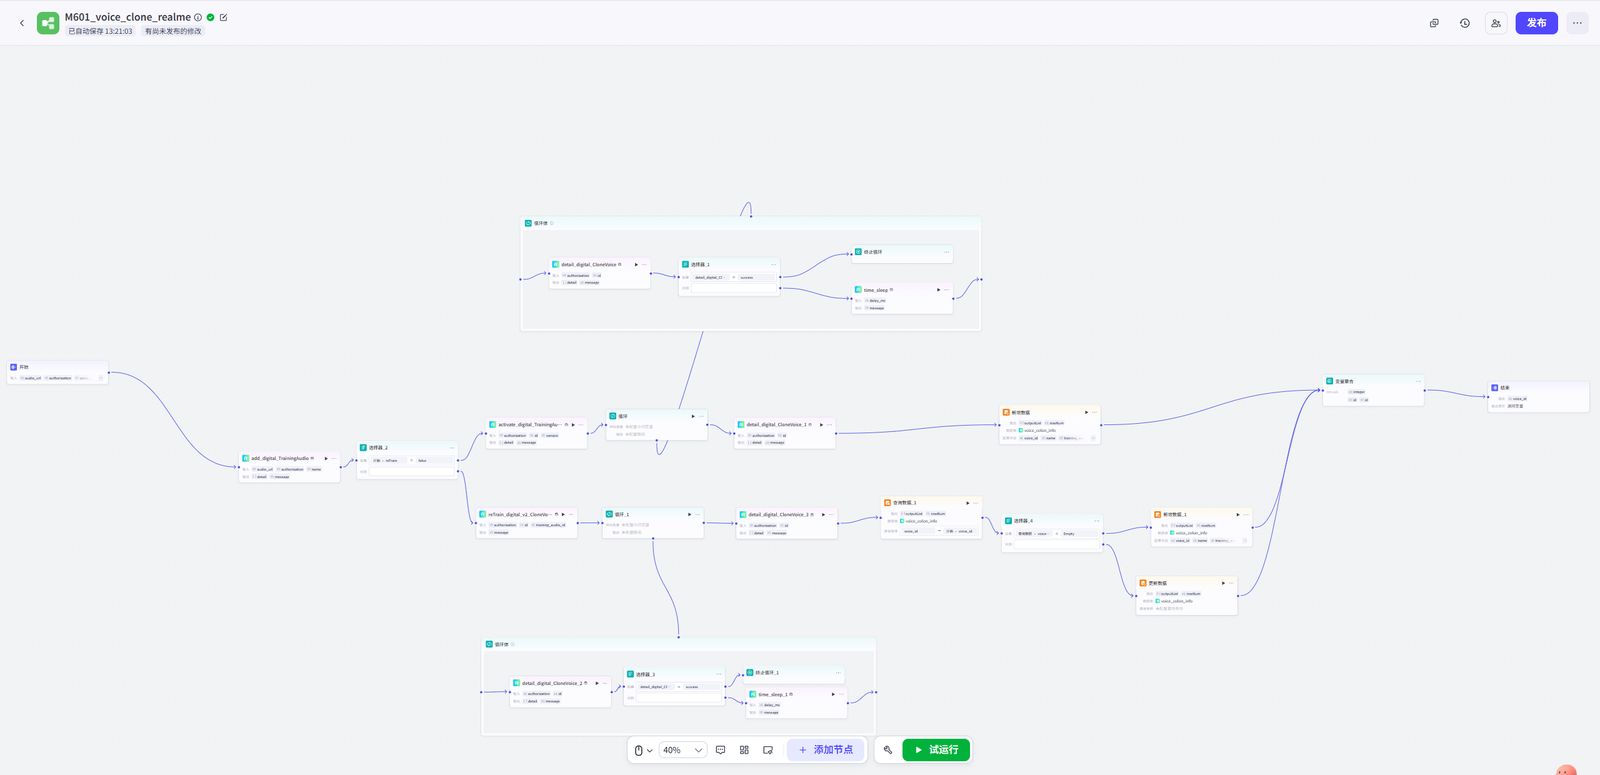
1.1 工作流步骤
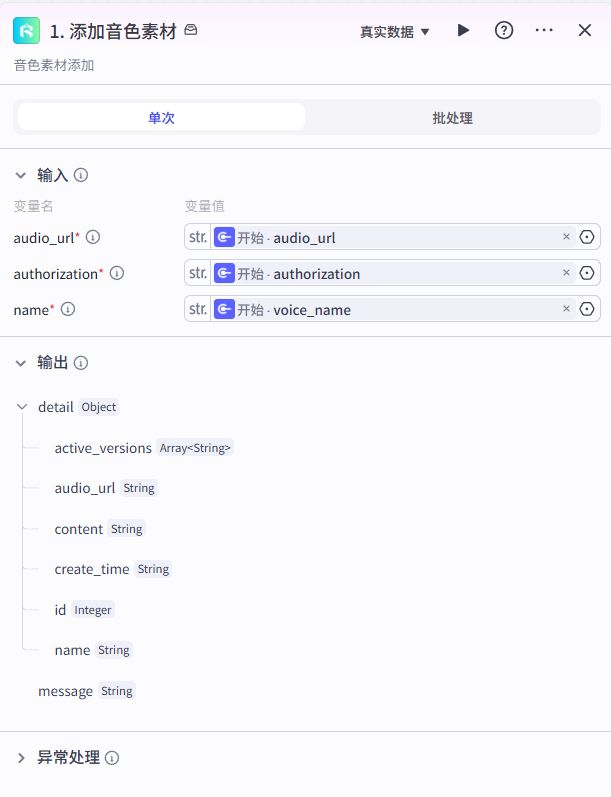
1.输入音色素材
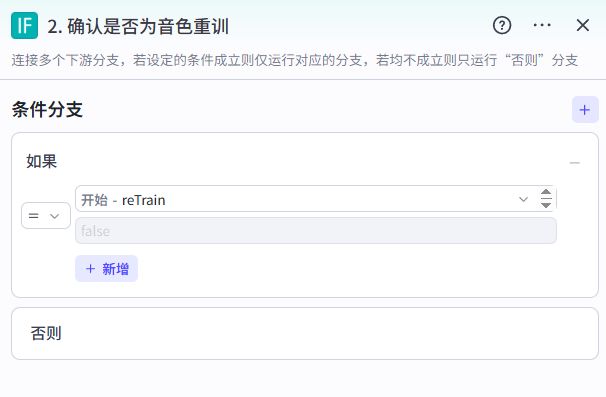
2.确认是重新训练已有音色还是建立新的音色
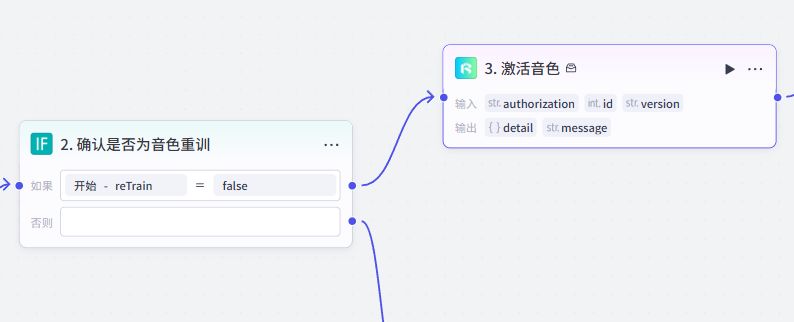
3.选择对应模型激活
4.轮询音色克隆训练结果
5.音色信息写入数据库方便后续调用或查找
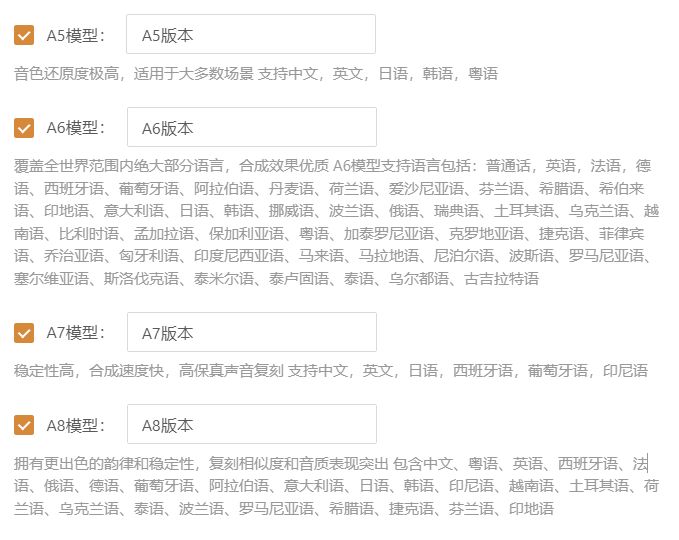
PS:语音训练模型中A5模型为免费模型
A5模型已经足够应对大多数普通使用场景
1.2 搭建流程
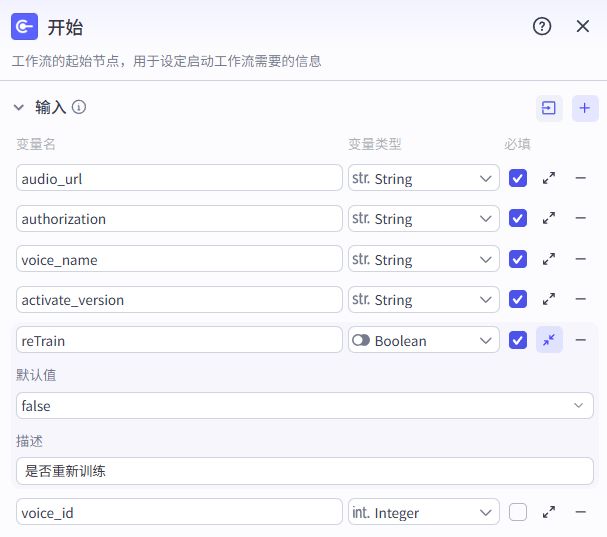
开始节点
PS:
{{reTrain}}参数: TRUE为已有音色重新训练,FALSE为新建音色训练,默认为FALSE
当{{reTrain}}选择为TRUE时,必须填入{{voice_id}}
添加音色素材
确认是否为音色重训
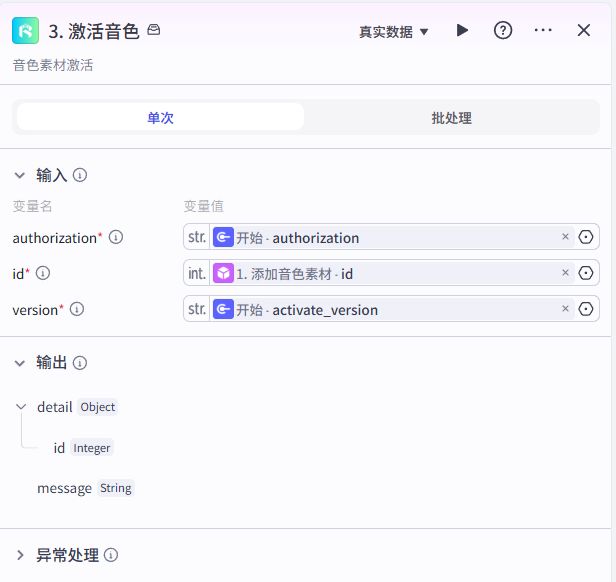
激活音色
如果非音色重训(即条件成立),走此分支
确认是否为A8音色
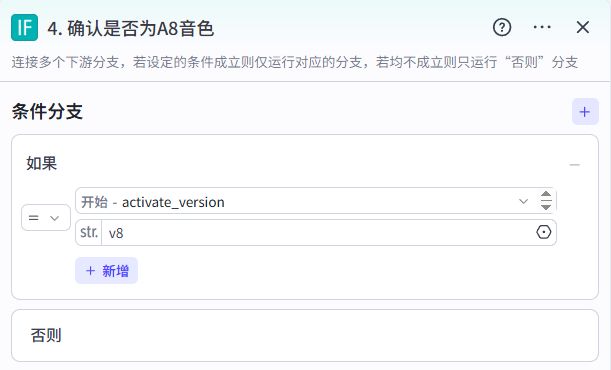
如果是则需二次激活再进入轮询
否则直接进入轮询
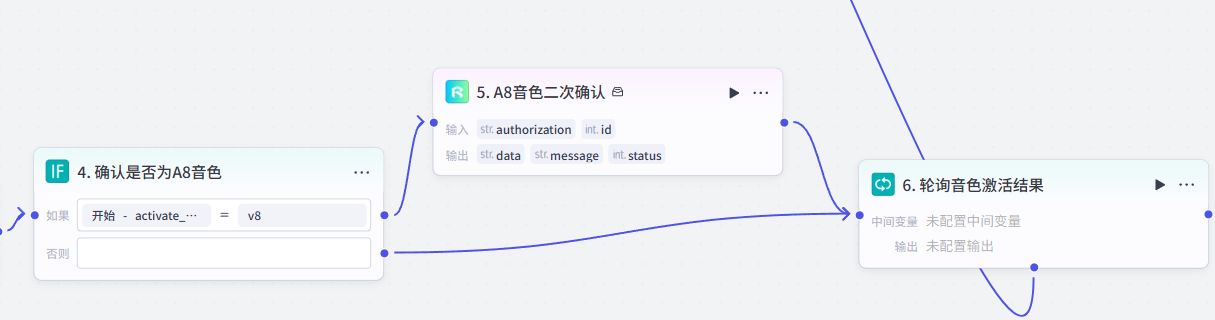
轮询音色激活结果
创建无限循环
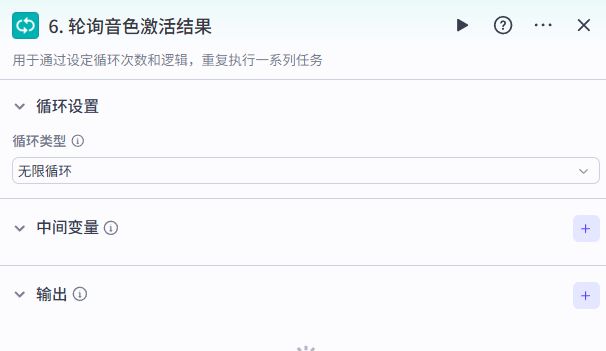
无限循环概览
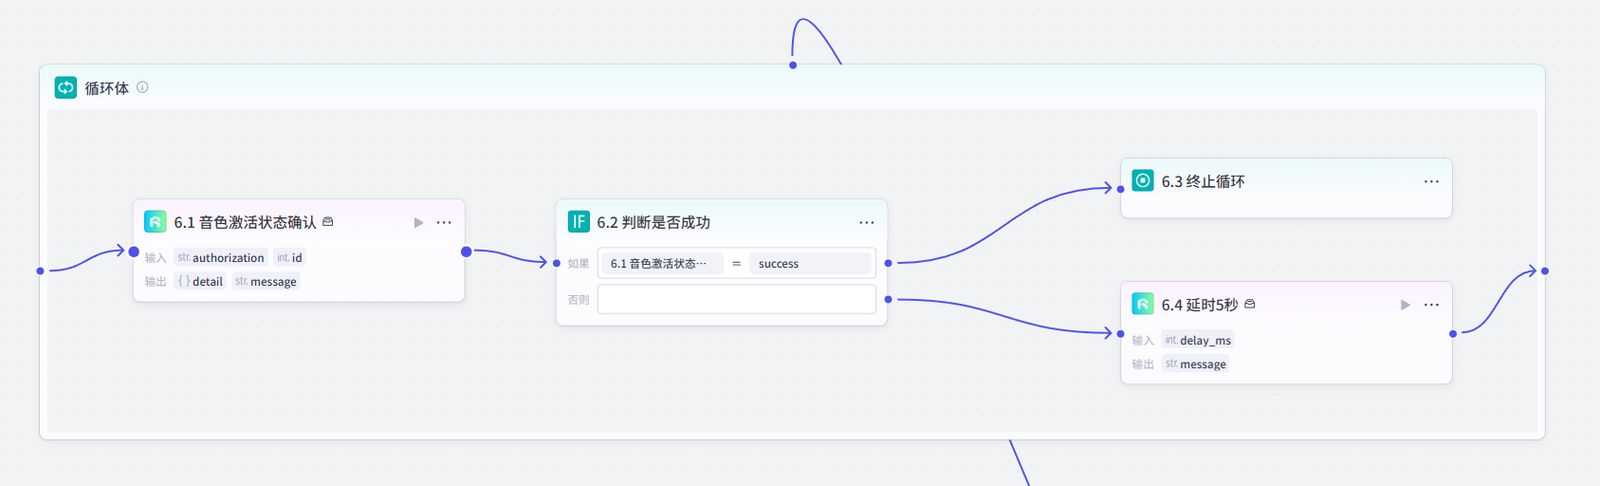
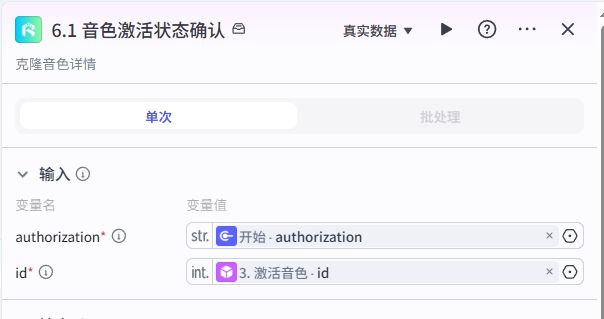
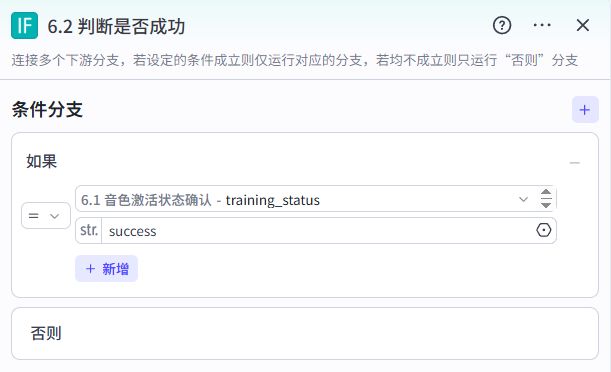
对音色状态做查询,并使用IF节点判断是否状态为“success”
如果状态为success则终止循环
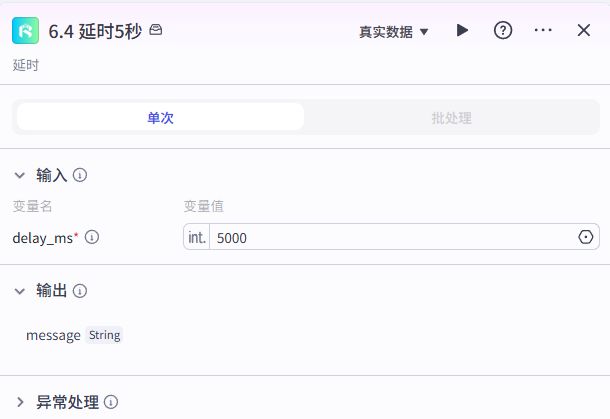
否则延时5秒开始下一轮查询
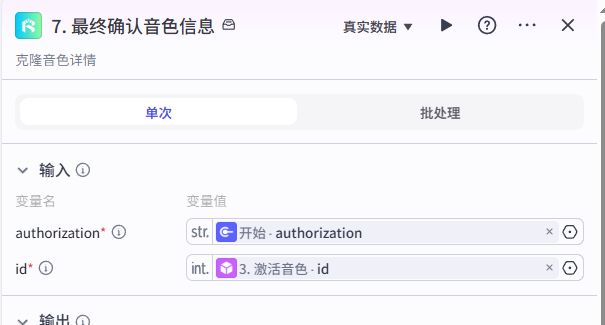
最终确认音色信息
创建数据表
这里要创建一个数据表,目的是为了记录所有的音色id,以便后续使用
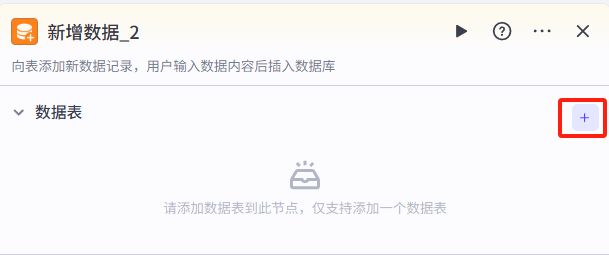
创建一个数据表节点,点击右上方➕号,创建新表
然后创建如下表结构
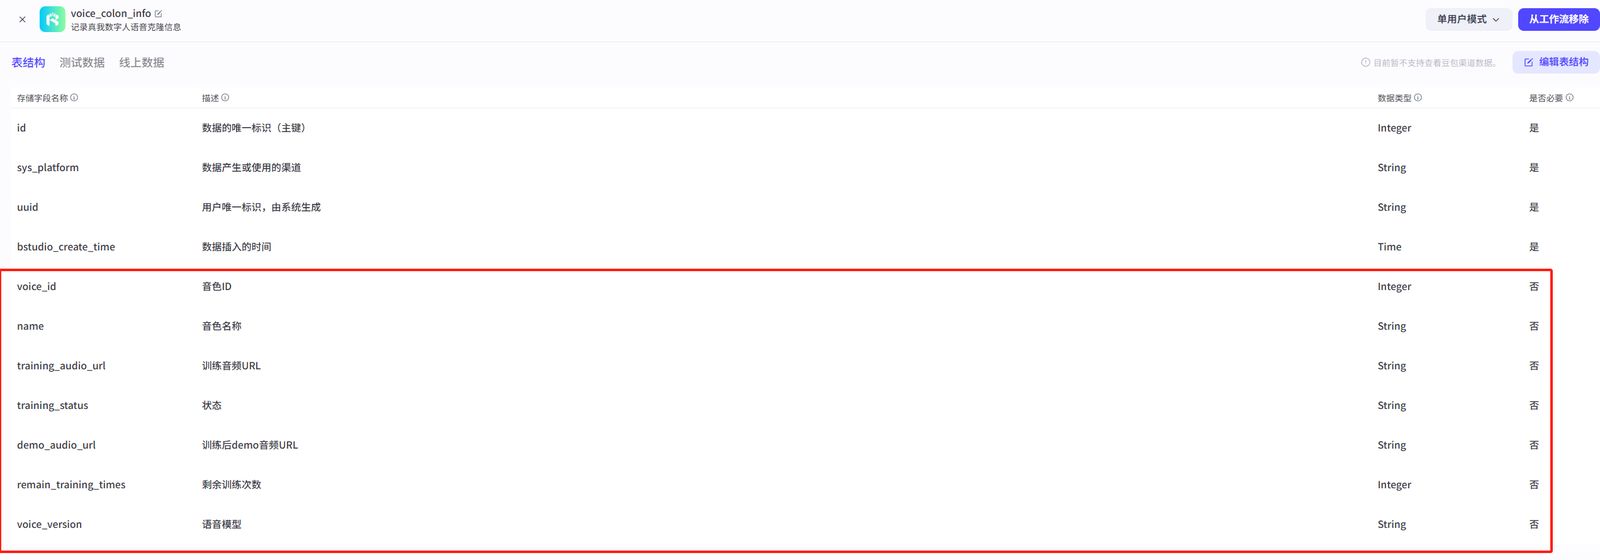
最后把这个数据表添加到节点,并设置映射关系
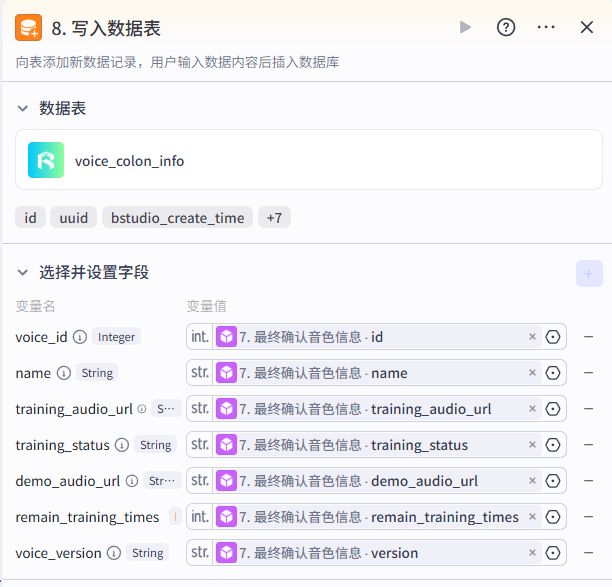
这样这条分支就结束了
音色重训
我们回到节点2的 else分支
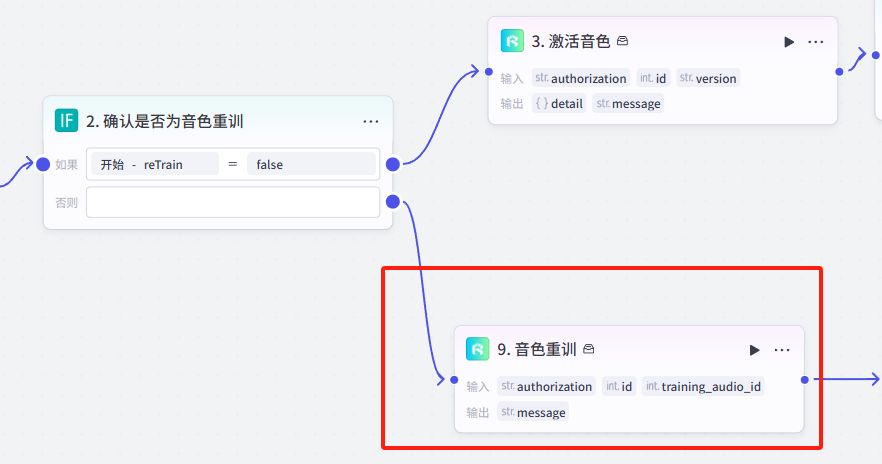
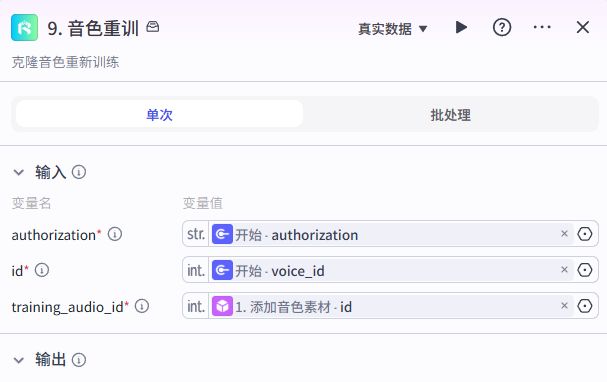
轮询音色重训结果
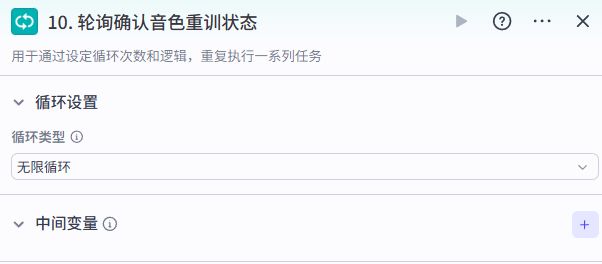
无限循环概览
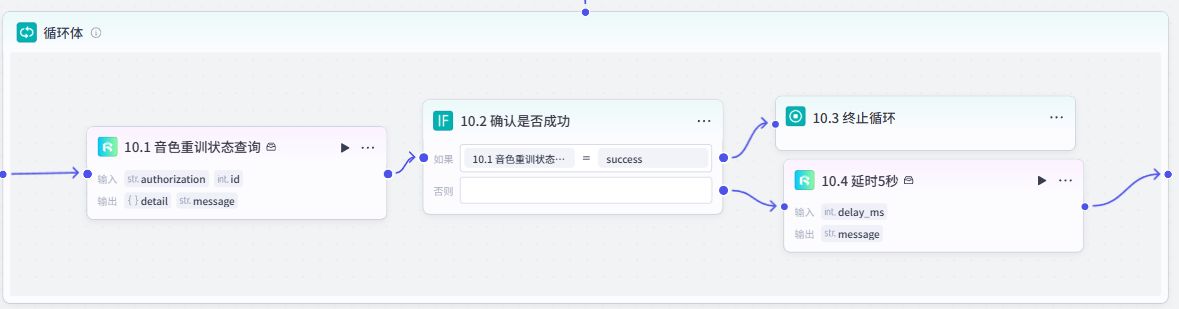
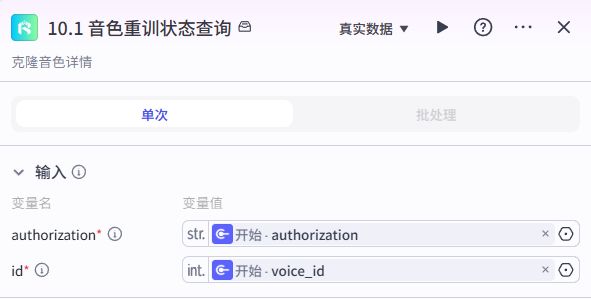
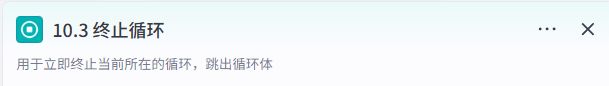
对音色状态做查询,并使用IF节点判断是否状态为“success”
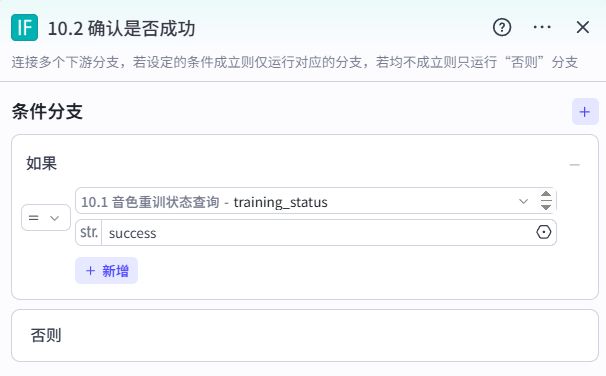
如果状态为success则终止循环
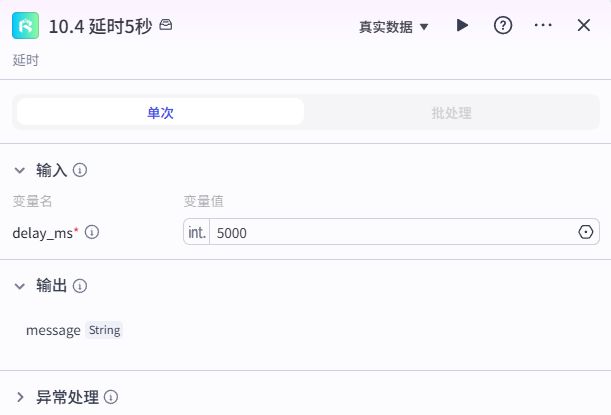
否则延时5秒开始下一轮查询
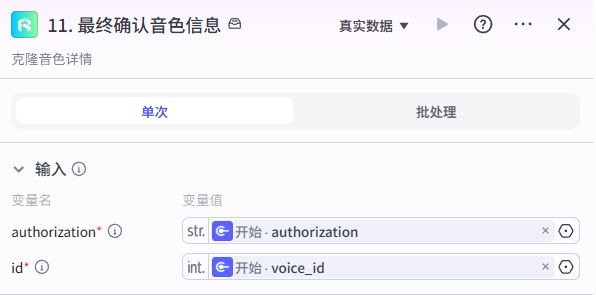
最终确认音色信息
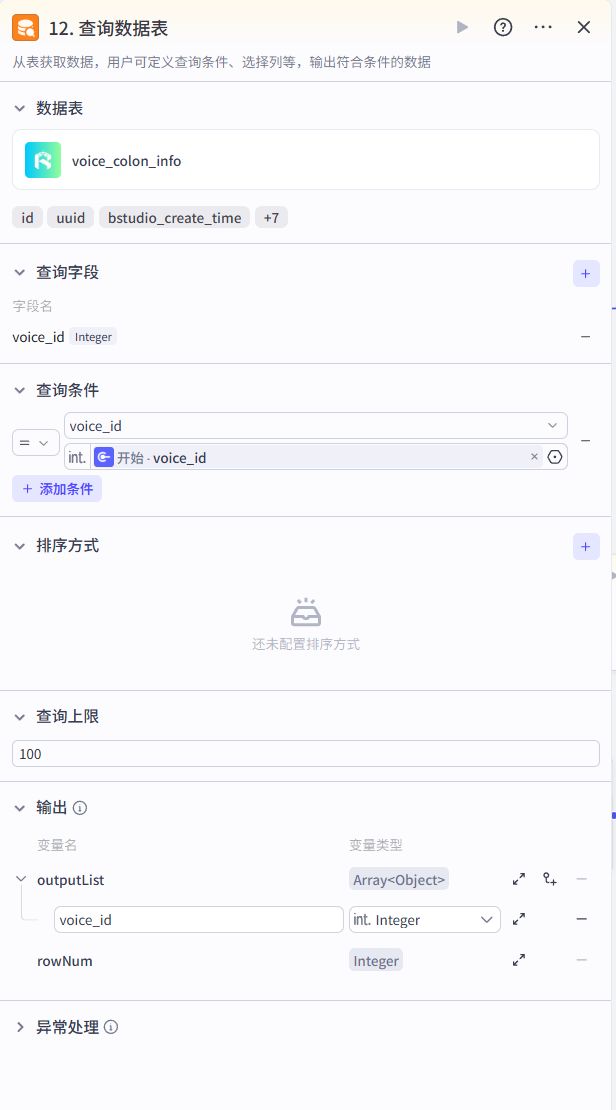
查询数据表中是否有音色id
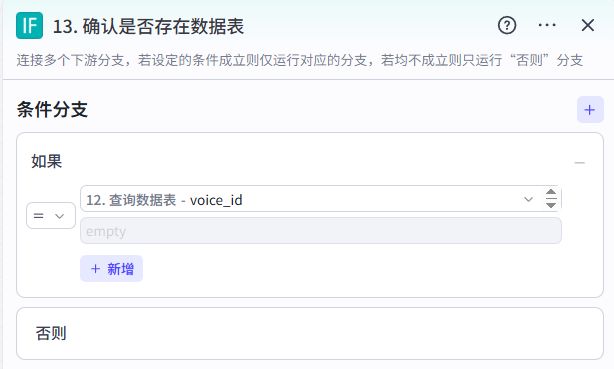
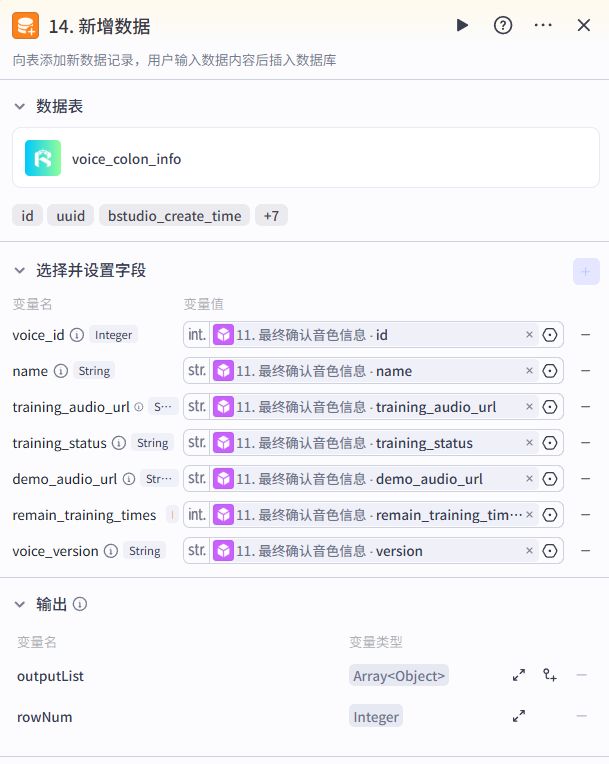
如果没有id信息则新增数据
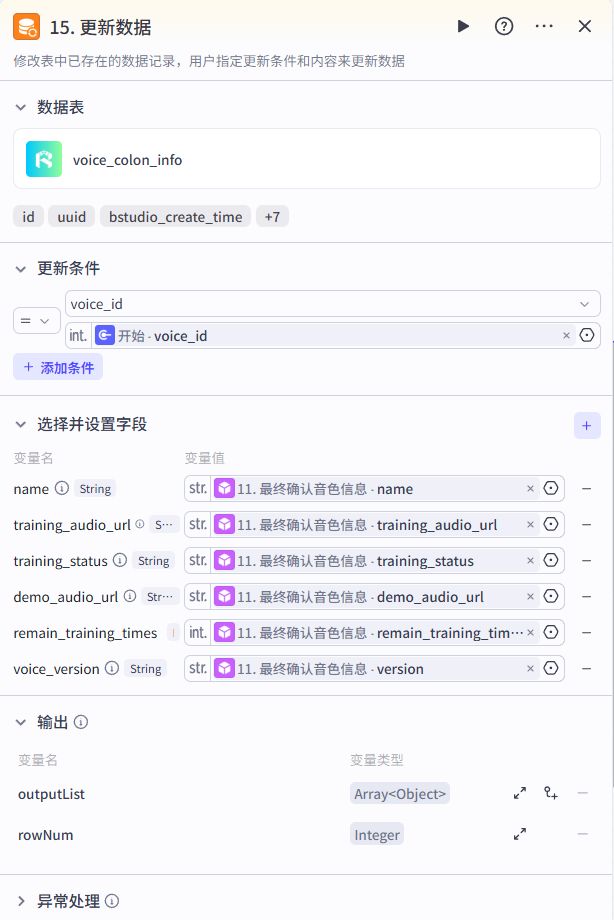
如果存在id信息增更新数据
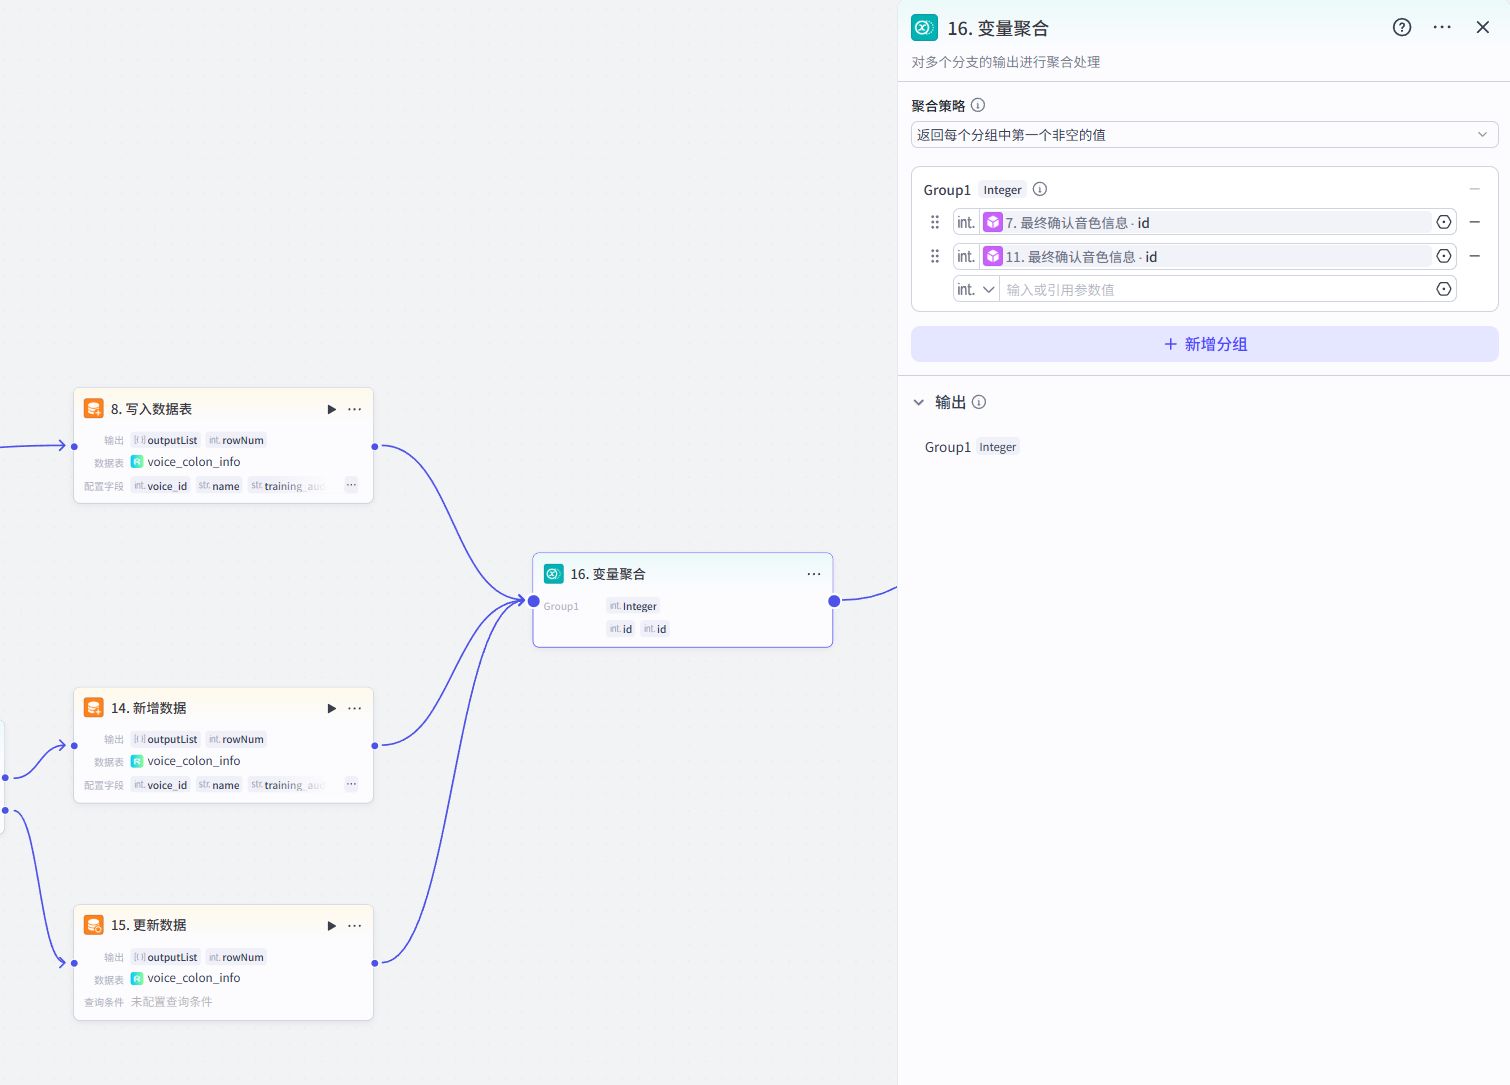
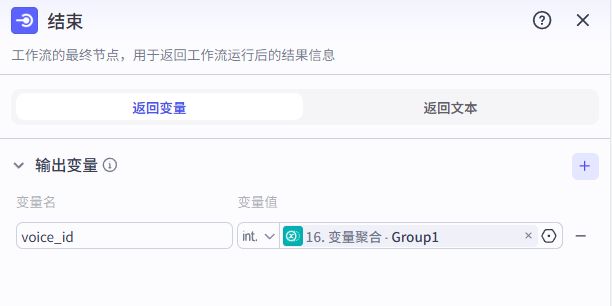
变量聚合
结束节点
二、形象克隆工作流
2.1 工作流步骤
1.输入形象素材
2.轮询克隆训练结果
3.信息写入数据库方便后续调用或查找
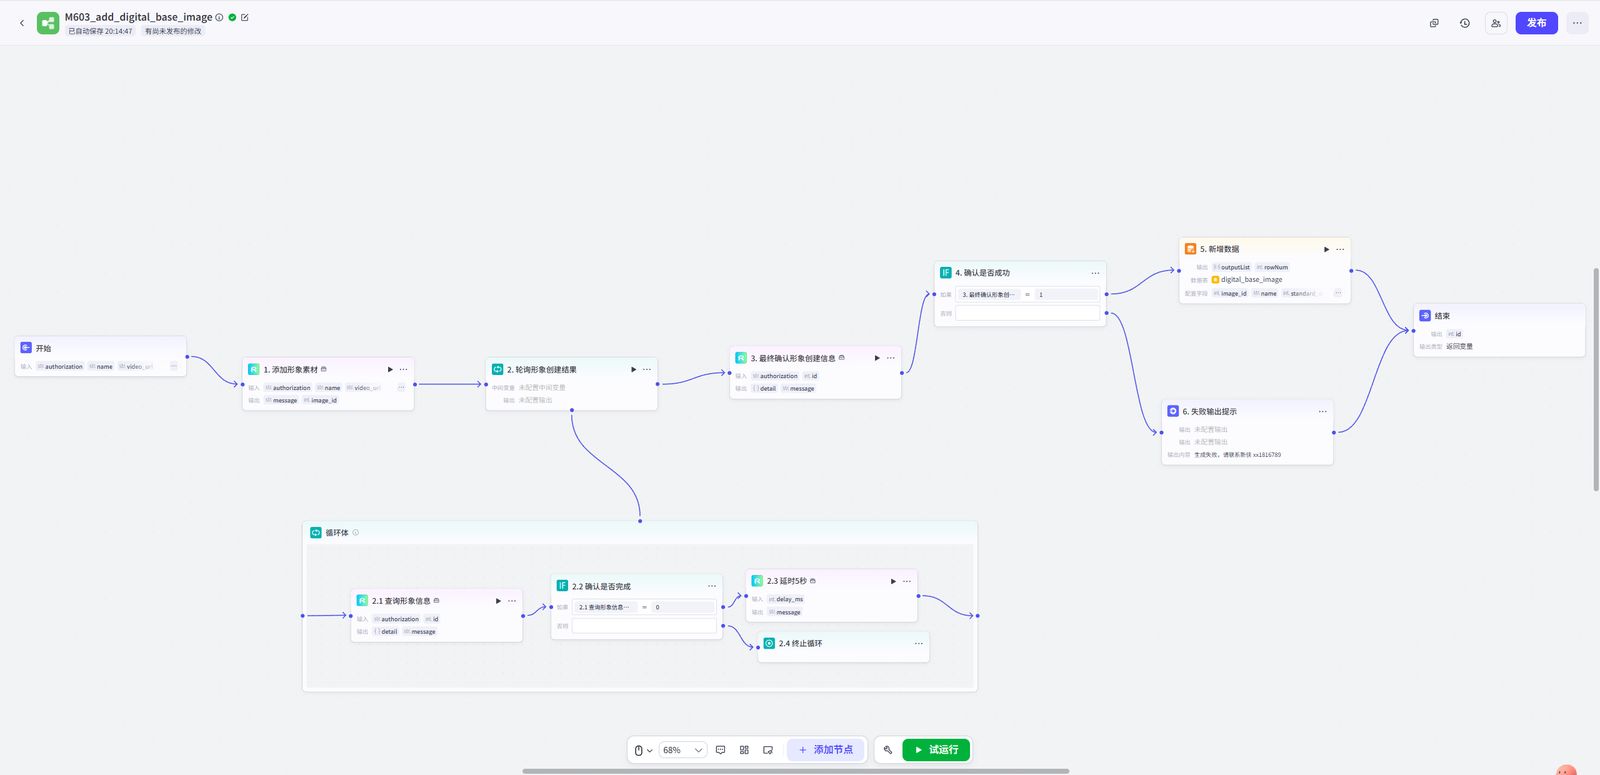
2.2 搭建流程
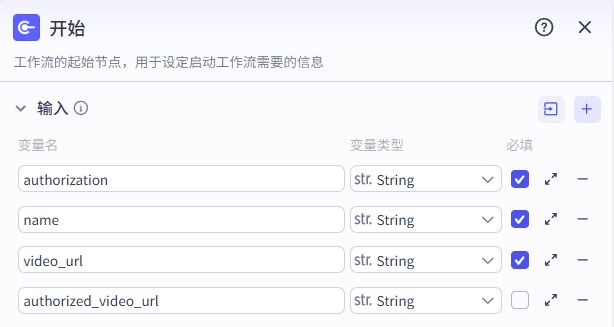
开始节点
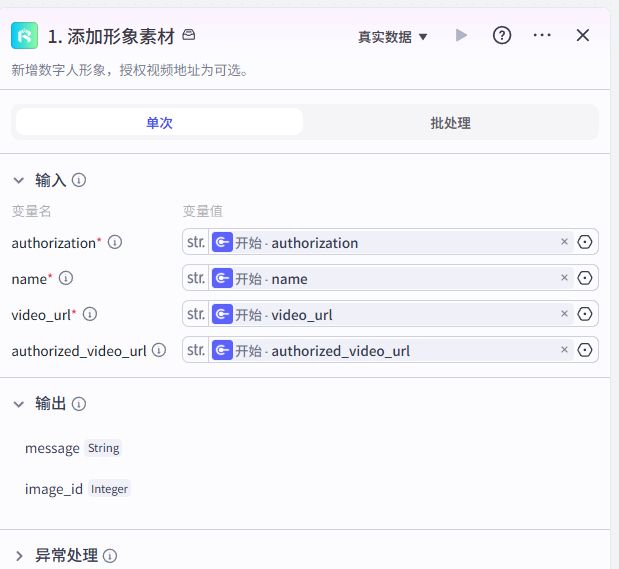
添加数字人形象素材
轮询形象创建结果
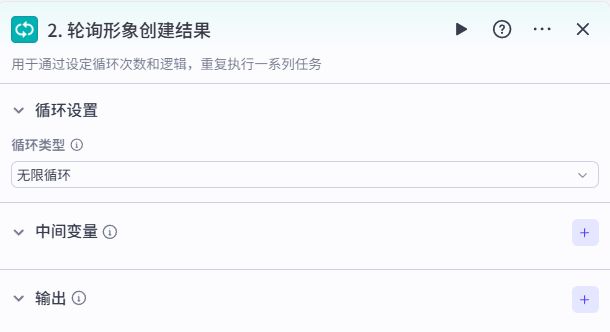
循环体概览
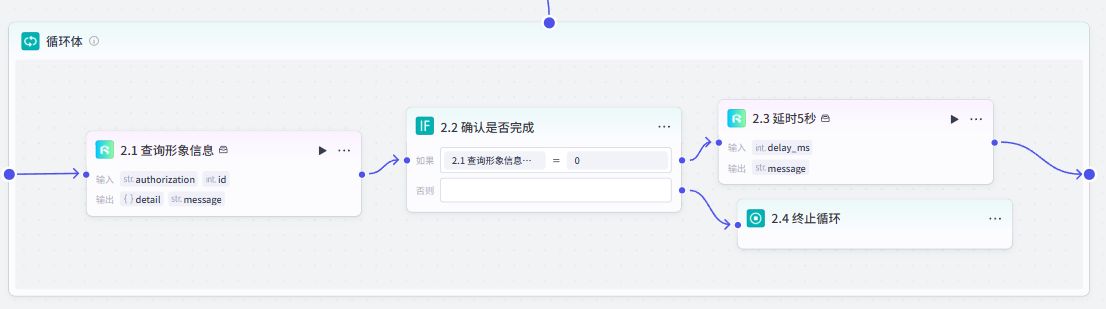
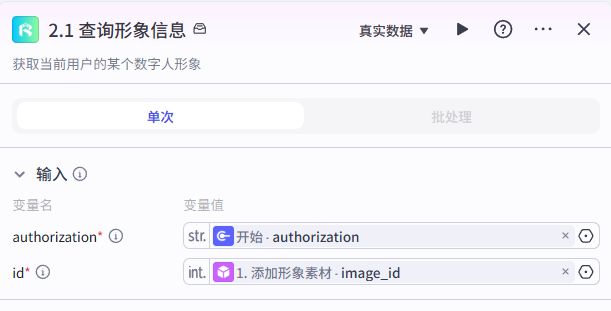
查询信息
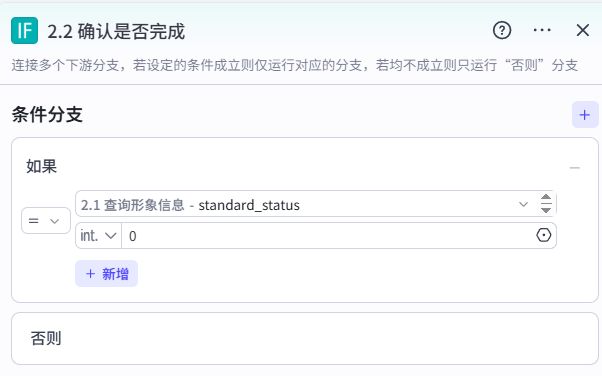
确认是否完成
未完成延时5秒进行下一轮查询
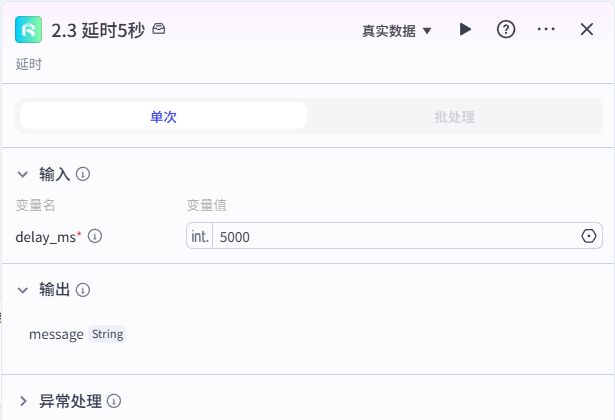
否则终止循环
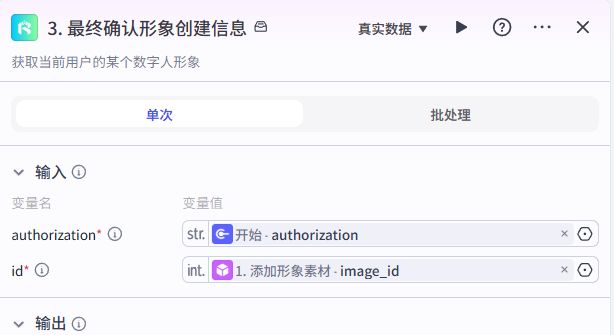
最终确认信息
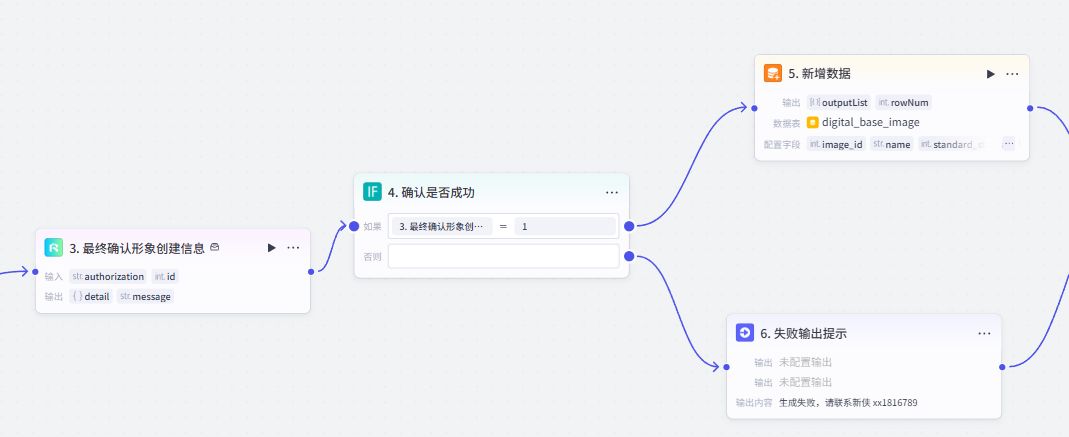
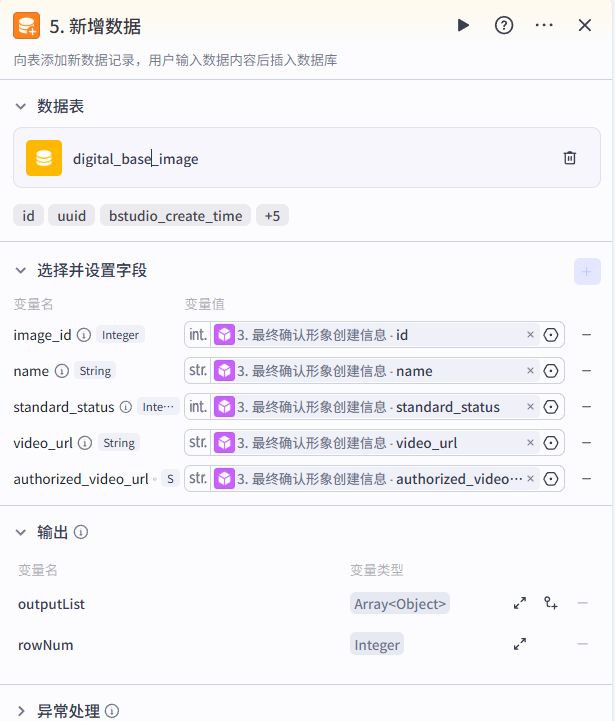
若创建成功则新增数据库数据,否则输出失败提示
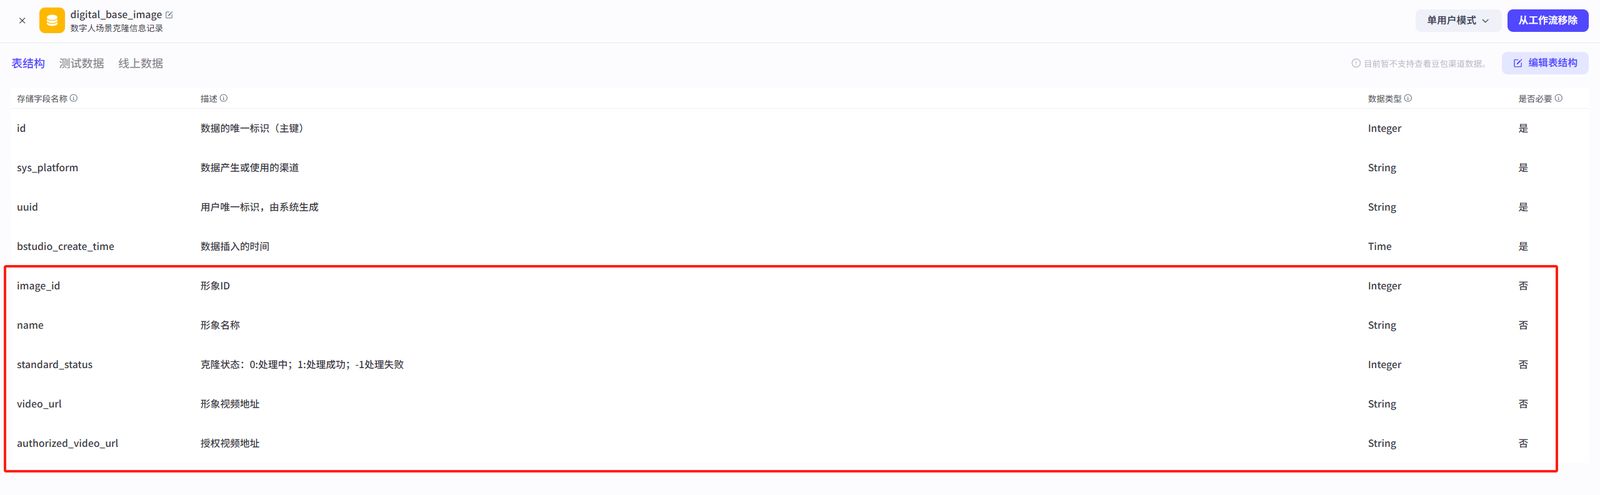
新建一个数据表,并设置数据结构如下
数据表节点参数
失败提示
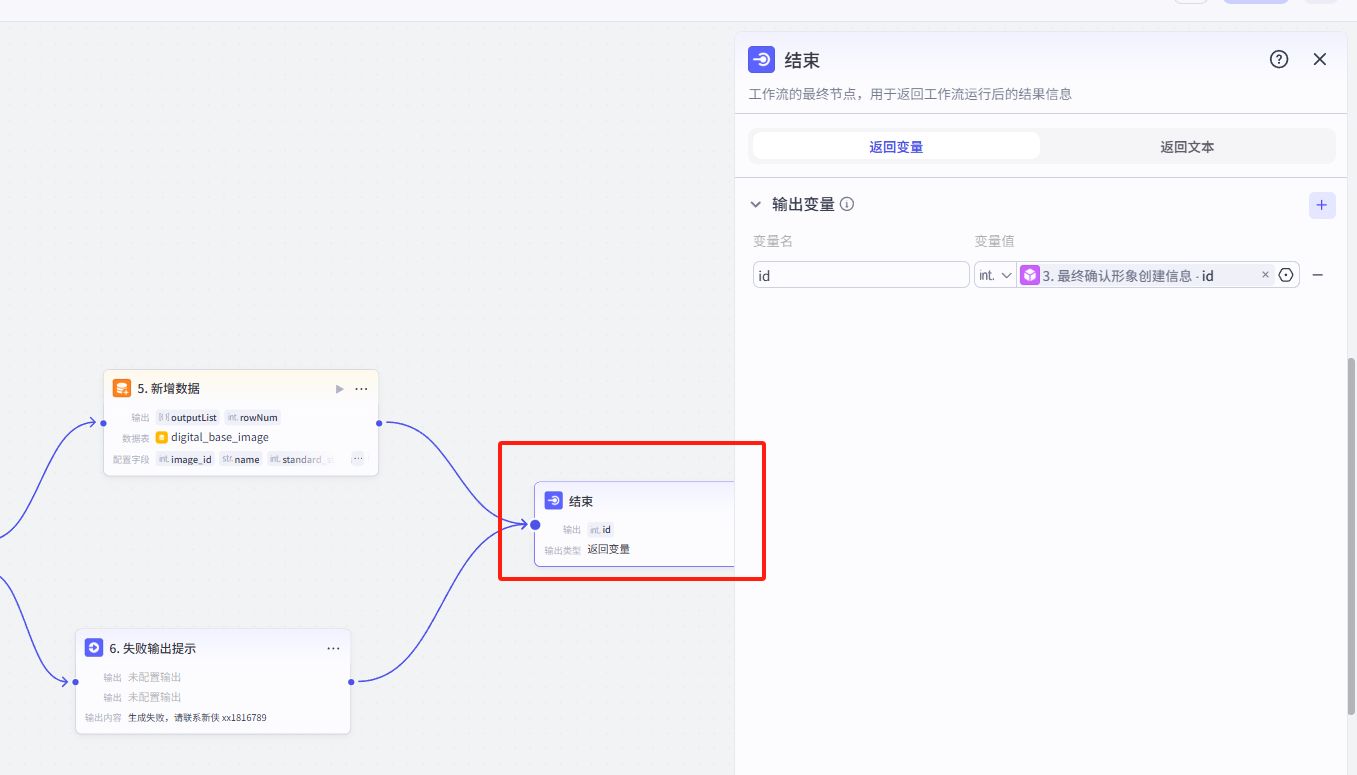
结束节点
输出形象id信息
完成了语音克隆工作流和形象克隆工作流后,我们可以获取音色id和形象id
如果忘了保存可以去数据表中查看记录的信息
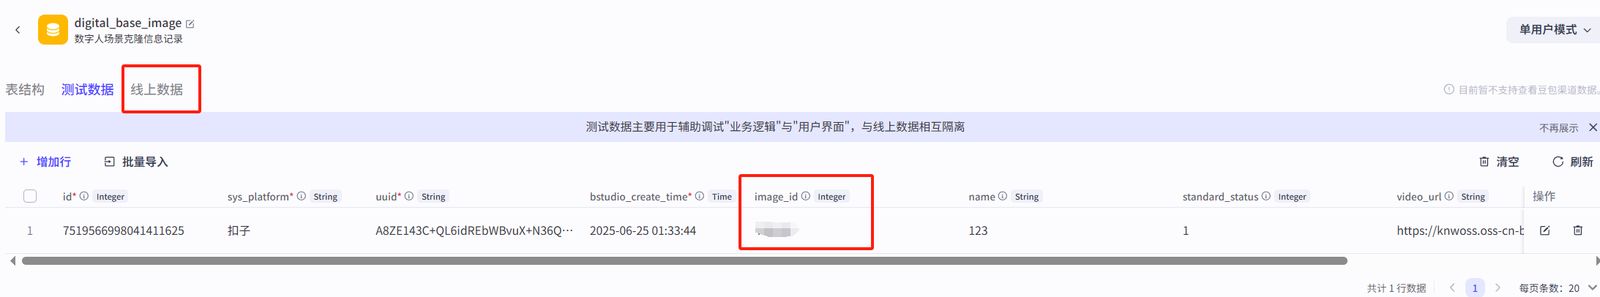
三、获取音色和形象id工作流
如果你没有借助【语音克隆工作流】和【形象克隆工作流】来获取id,则你需要再官网前台手动、可视化的克隆音色和形象
前台克隆音色和形象教程
小程序:
PC端:
🎤 公共音色一览
https://dhm.jinhuaclub.com/#/consoleDesk/document?doc_id=15
👨 公共形象一览
https://dhm.jinhuaclub.com/#/consoleDesk/document?doc_id=16
工作流概览
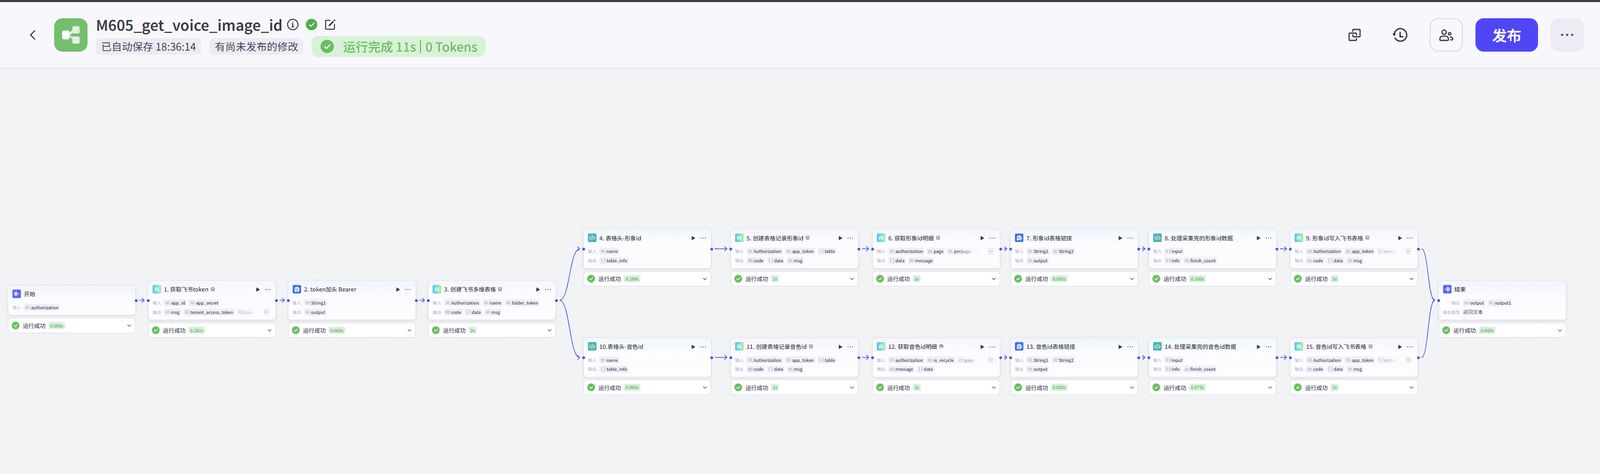
3.1 工作流步骤
创建飞书多维表格 – 获取id信息 – id信息写入飞书表格
3.2 搭建流程
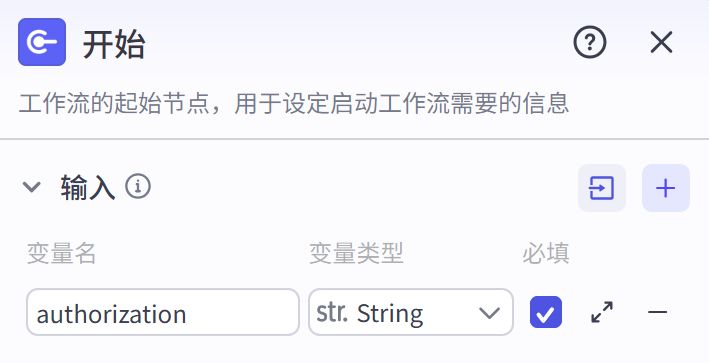
开始节点
参数只有一个authorization
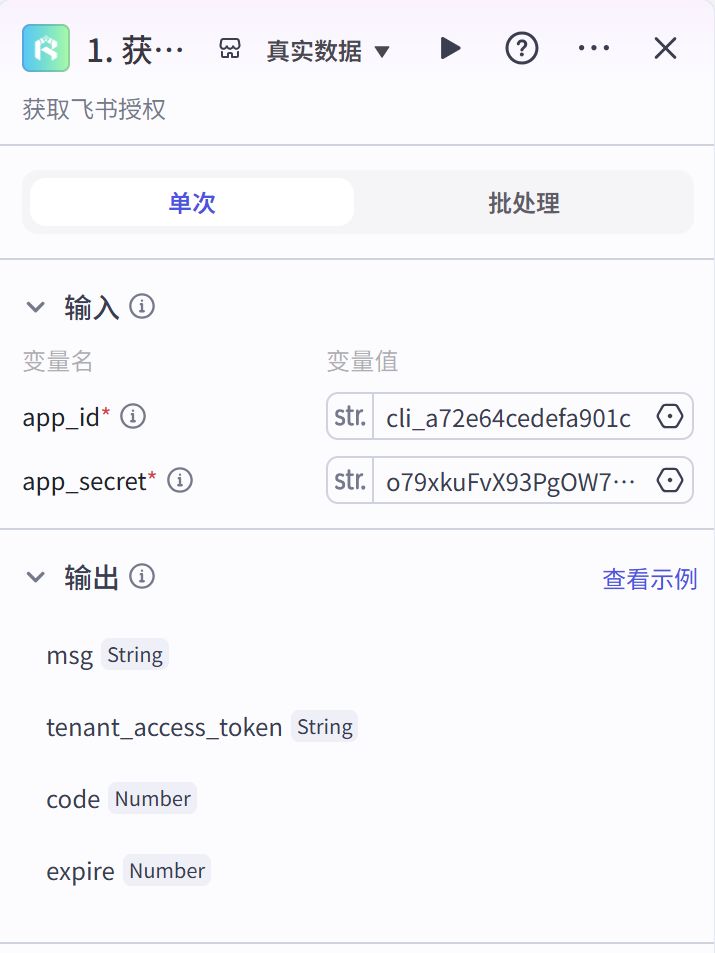
获取飞书token
插件已经上架coze商店中
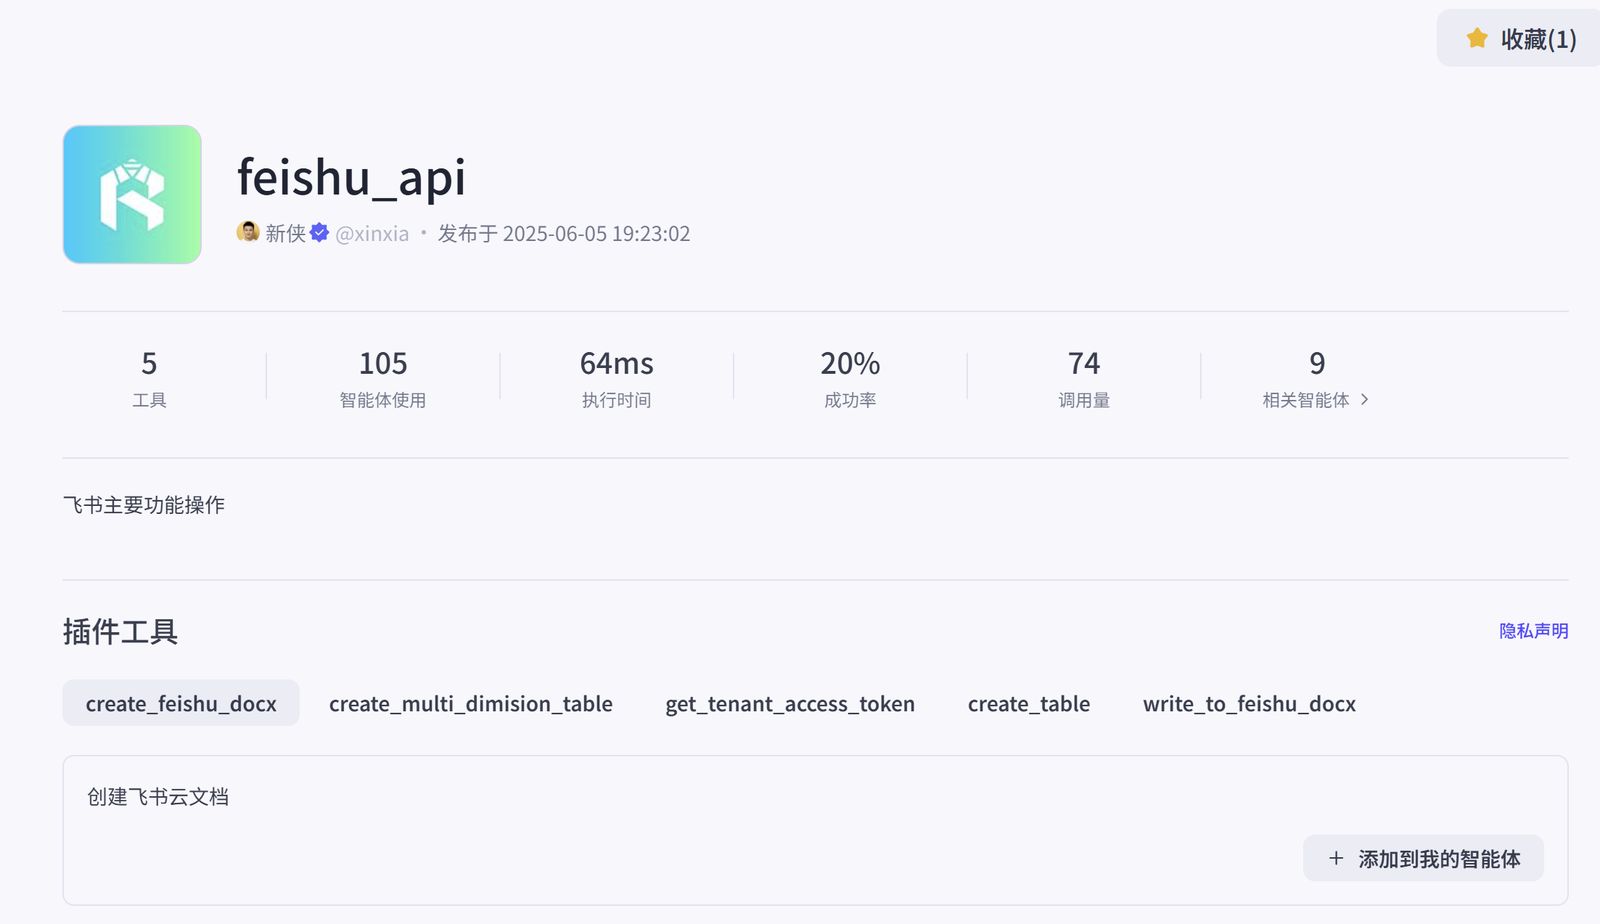
这里插入get_tenant_access_token工具
app_id:cli_a72e64cedefa901c
app_secret:o79xkuFvX93PgOW7LWDpxdtnq7cJIJgk
这里直接提供我的id和secret给大家使用,因为创建飞书机器人并获取授权比较麻烦,后续有空给大家单独出教程
使用我的id和secret,文档保存在我的飞书中,请大家生成后及时转存,不定期删
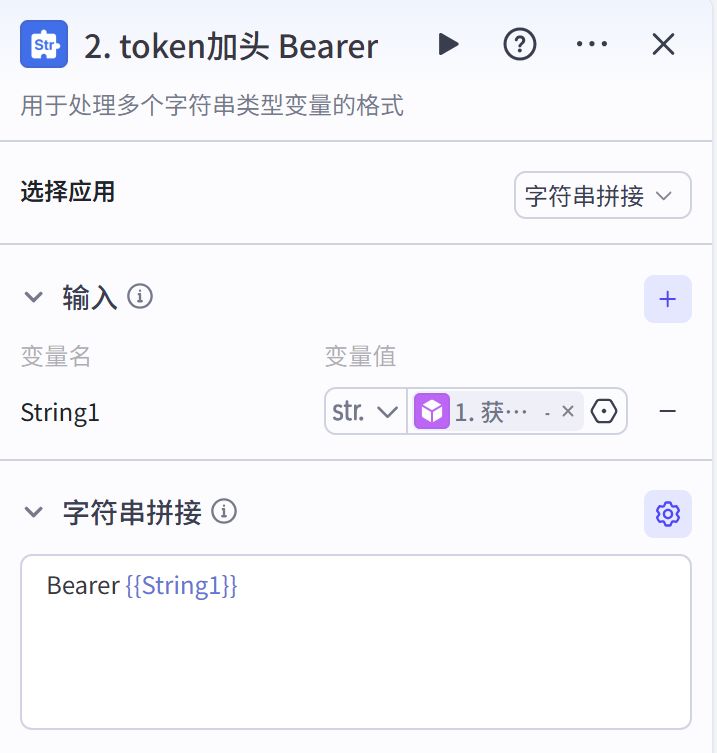
Token加头
飞书的授权token前必须要加上 “Bearer ”才能生效(Bearer后有空格)
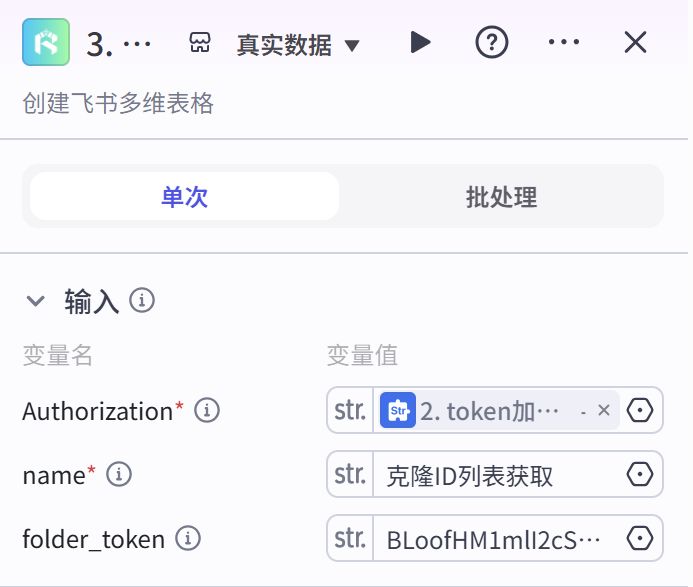
创建飞书多维表格
如果使用我的id和secret,folder_token请务必填写BLoofHM1mlI2cSdBtBhctfqDnxe
因为我有强迫症,看到根目录下有文件我都会直接删除
这里开始分出两条分支并行,一个表记录形象id,一个表记录音色id
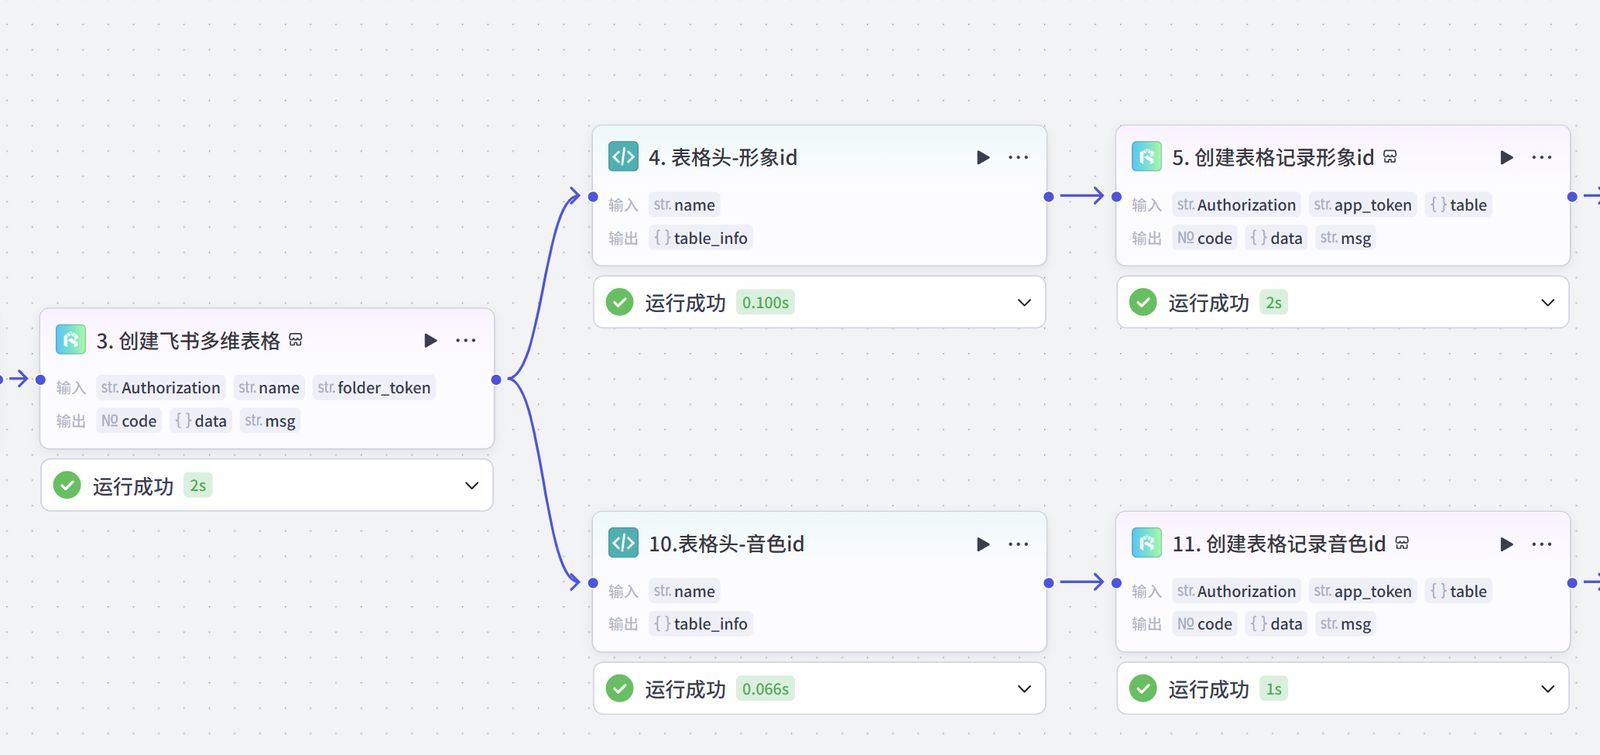
整理表格的标签栏
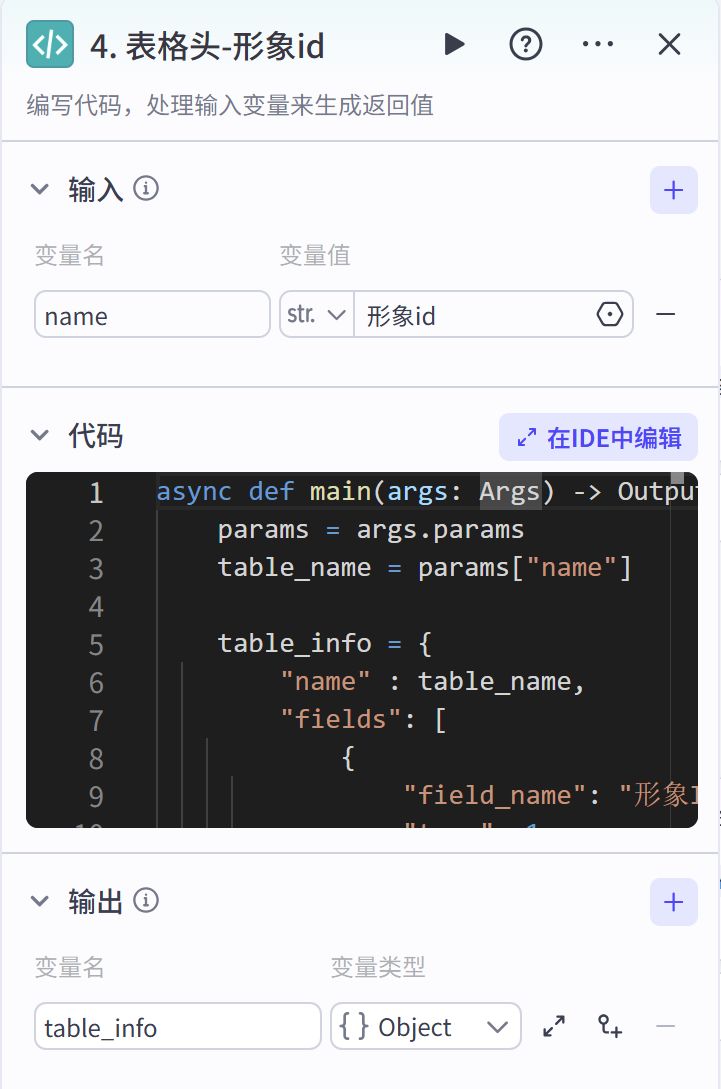
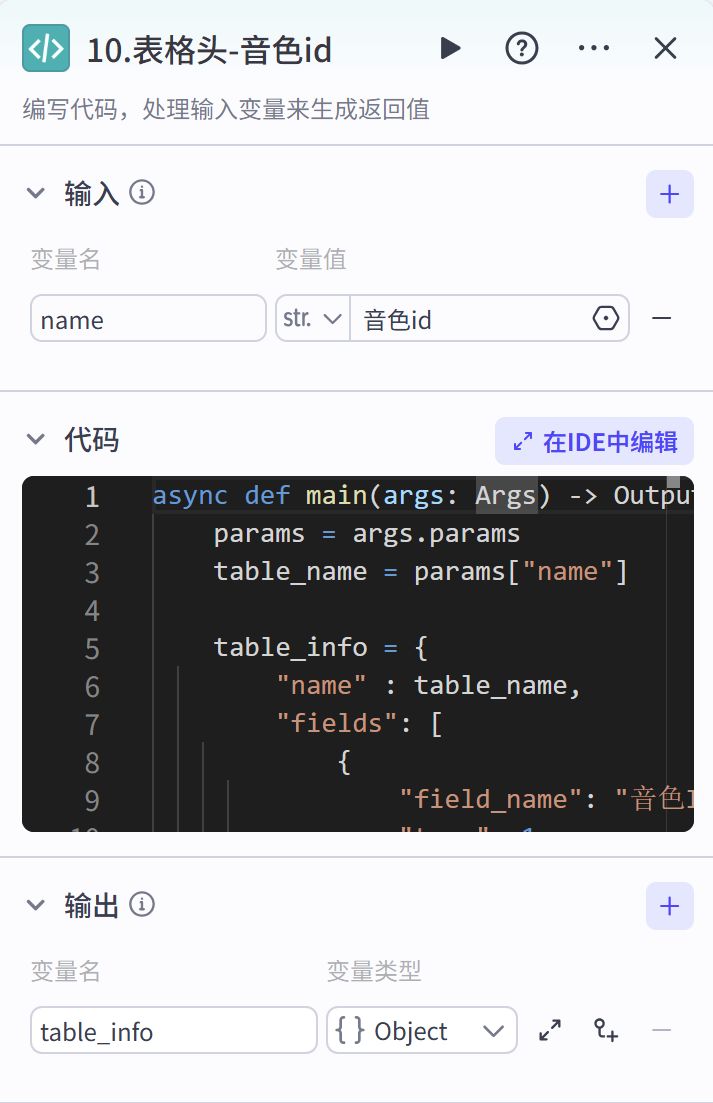
async def main(args: Args) -> Output:
params = args.params
table_name = params["name"]
table_info = {
"name" : table_name,
"fields": [
{
"field_name": "形象ID",
"type": 1
},
{
"field_name": "形象名称",
"type": 1
},
{
"field_name": "形象url",
"type": 1
},
{
"field_name": "标准状态",
"type": 1
},
]
}
ret: Output = {
"table_info" : table_info
}
return ret
async def main(args: Args) -> Output:
params = args.params
table_name = params["name"]
table_info = {
"name" : table_name,
"fields": [
{
"field_name": "音色ID",
"type": 1
},
{
"field_name": "音色名称",
"type": 1
},
{
"field_name": "音色素材url",
"type": 1
},
{
"field_name": "试听url",
"type": 1
},
{
"field_name": "剩余训练次数",
"type": 1
},
{
"field_name": "激活版本",
"type": 1
},
]
}
ret: Output = {
"table_info" : table_info
}
return ret
创建多维表格下子表格
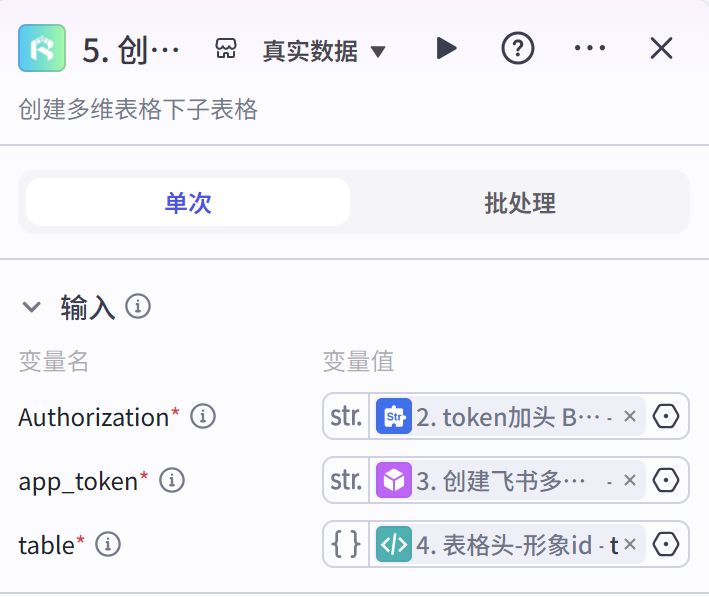
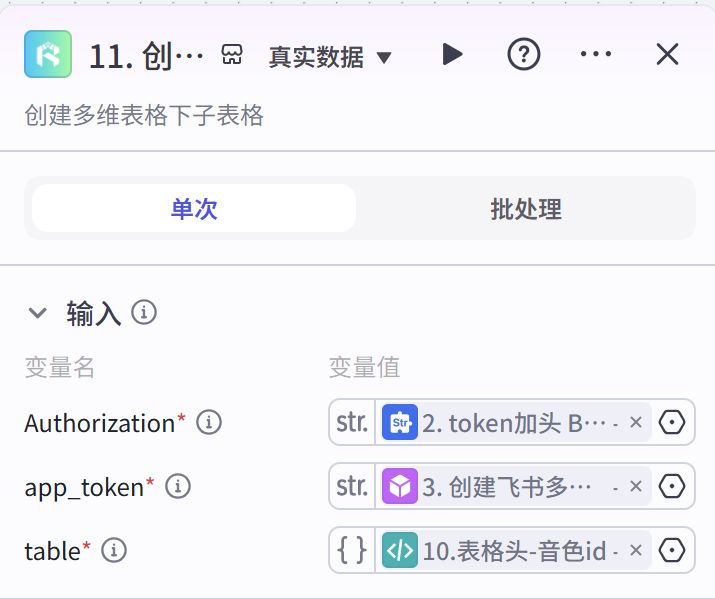
获取音色和形象id列表
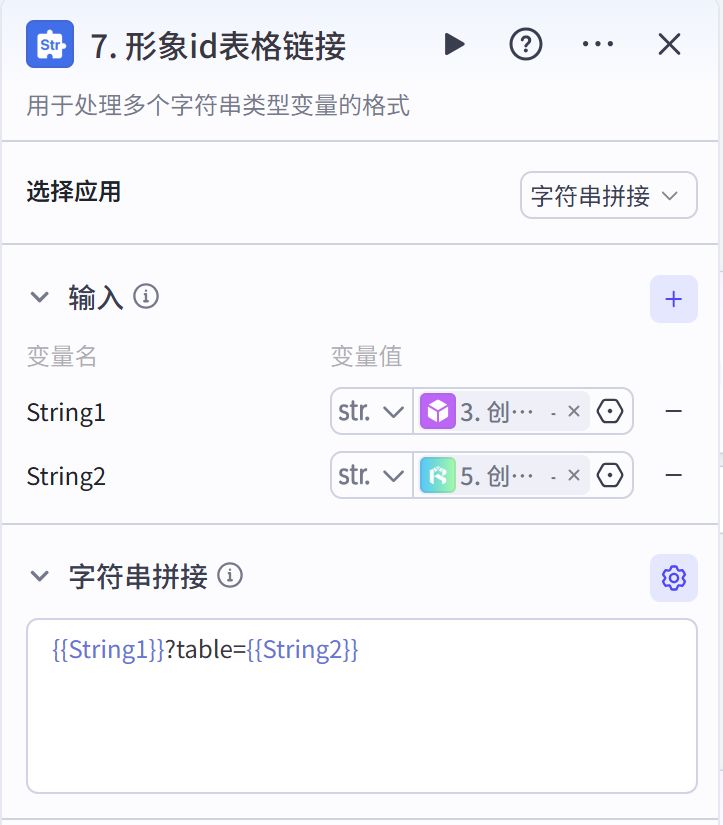
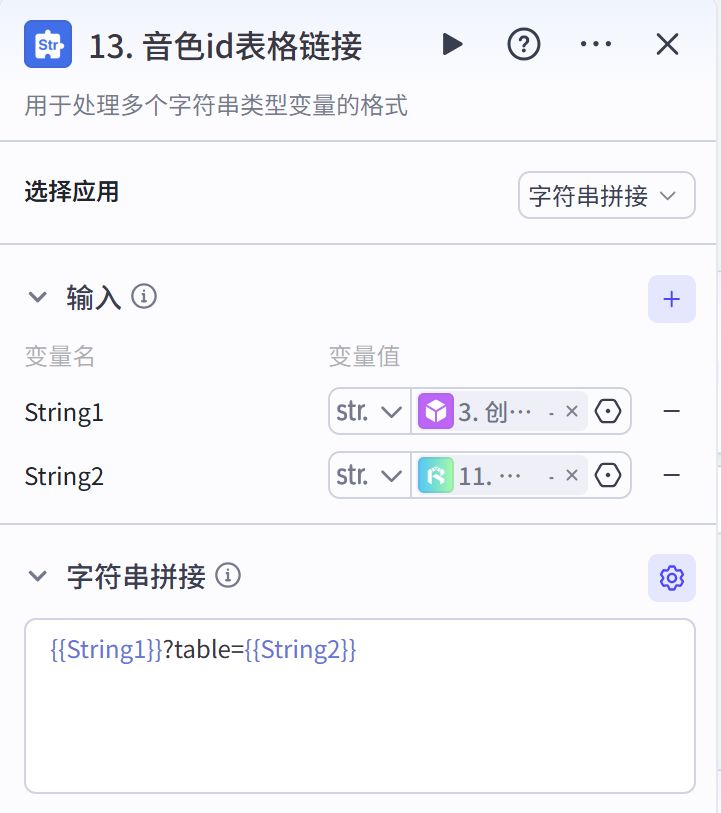
获取飞书表格链接
处理采集完的数据
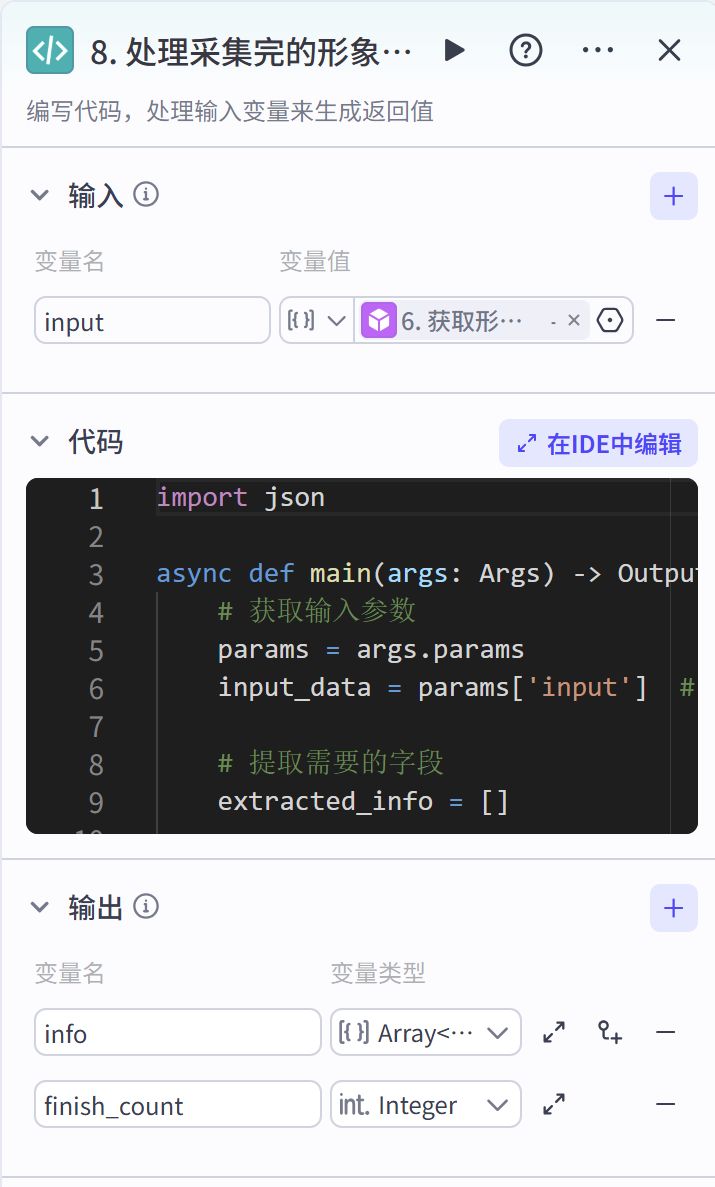
import json
async def main(args: Args) -> Output:
# 获取输入参数
params = args.params
input_data = params[‘input’] # 输入数据是一个列表
# 提取需要的字段
extracted_info = []
for item in input_data:
fields_dict = {
"形象ID": str(item["id"]),
"形象名称": item["name"],
"形象url": item["video_url"],
"标准状态": str(item["standard_status"])
}
# 将字段转成 JSON 字符串
fields_str = json.dumps(fields_dict, ensure_ascii=False)
extracted_info.append({
"fields": fields_str
})
# 构建输出对象
ret = {
"info": extracted_info
}
return ret
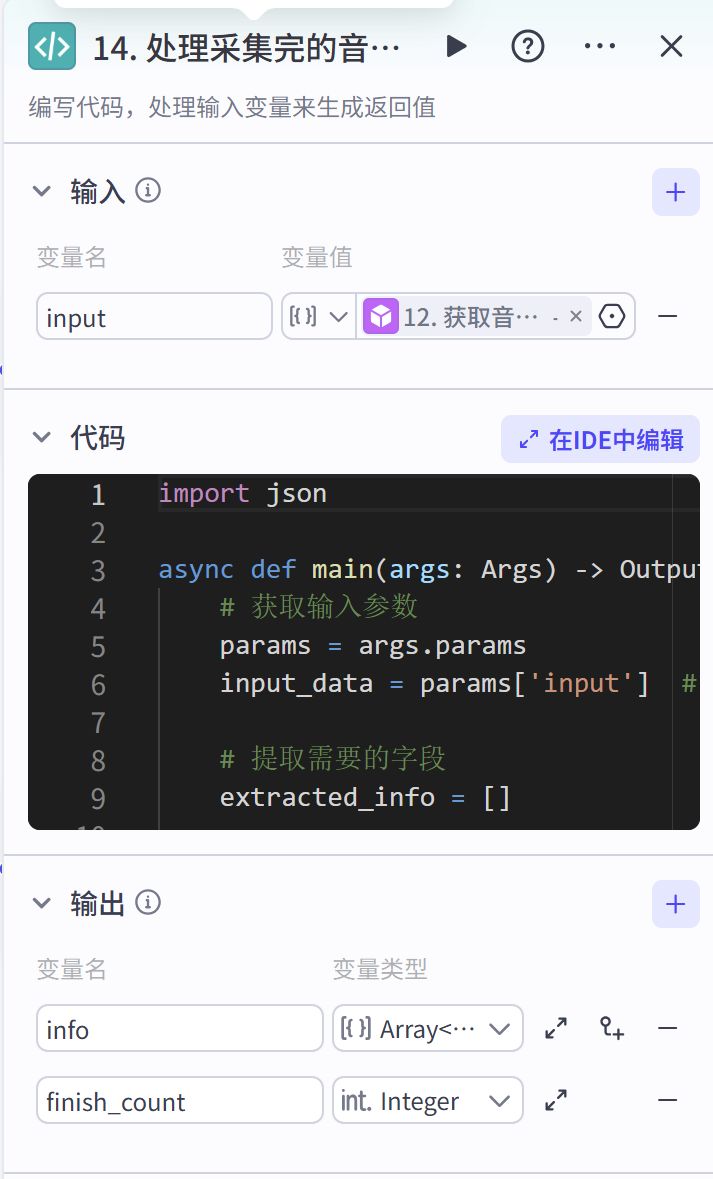
import json
async def main(args: Args) -> Output:
# 获取输入参数
params = args.params
input_data = params[‘input’] # 输入数据是一个列表
# 提取需要的字段
extracted_info = []
for item in input_data:
fields_dict = {
"音色ID": str(item["id"]),
"音色名称": str(item["name"]),
"音色素材url": str(item["training_audio_url"]),
"试听url": str(item["demo_audio_url"]),
"剩余训练次数": str(item["remain_training_times"]),
"激活版本": str(item["version"])
}
# 将字段转成 JSON 字符串
fields_str = json.dumps(fields_dict, ensure_ascii=False)
extracted_info.append({
"fields": fields_str
})
# 构建输出对象
ret = {
"info": extracted_info
}
return ret
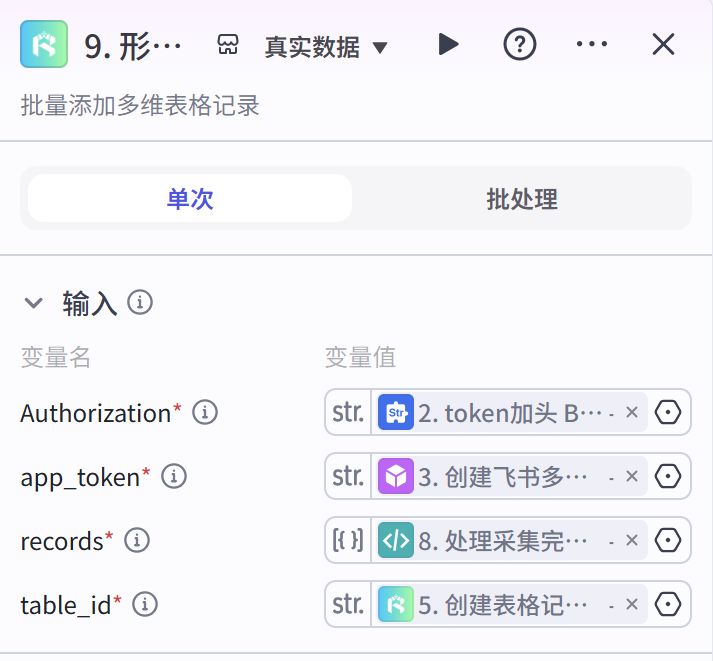
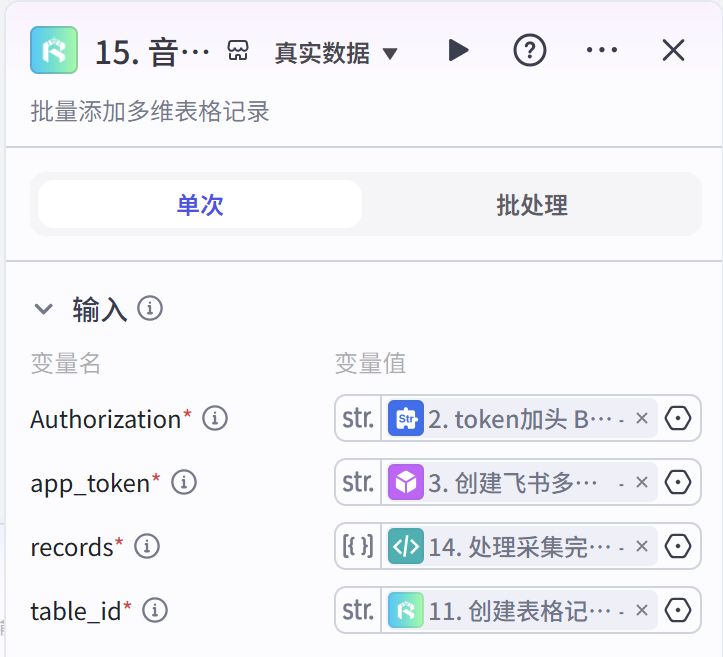
信息写入飞书
结束节点
两条分支都要连接到结束节点
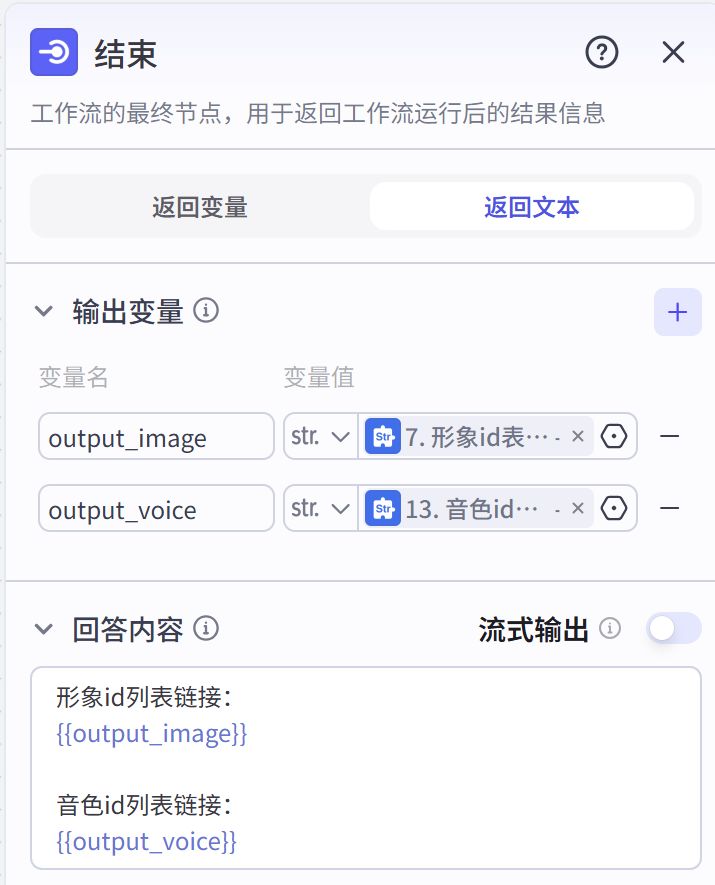
运行成功后可获得对应的飞书链接,点击链接后查看id信息
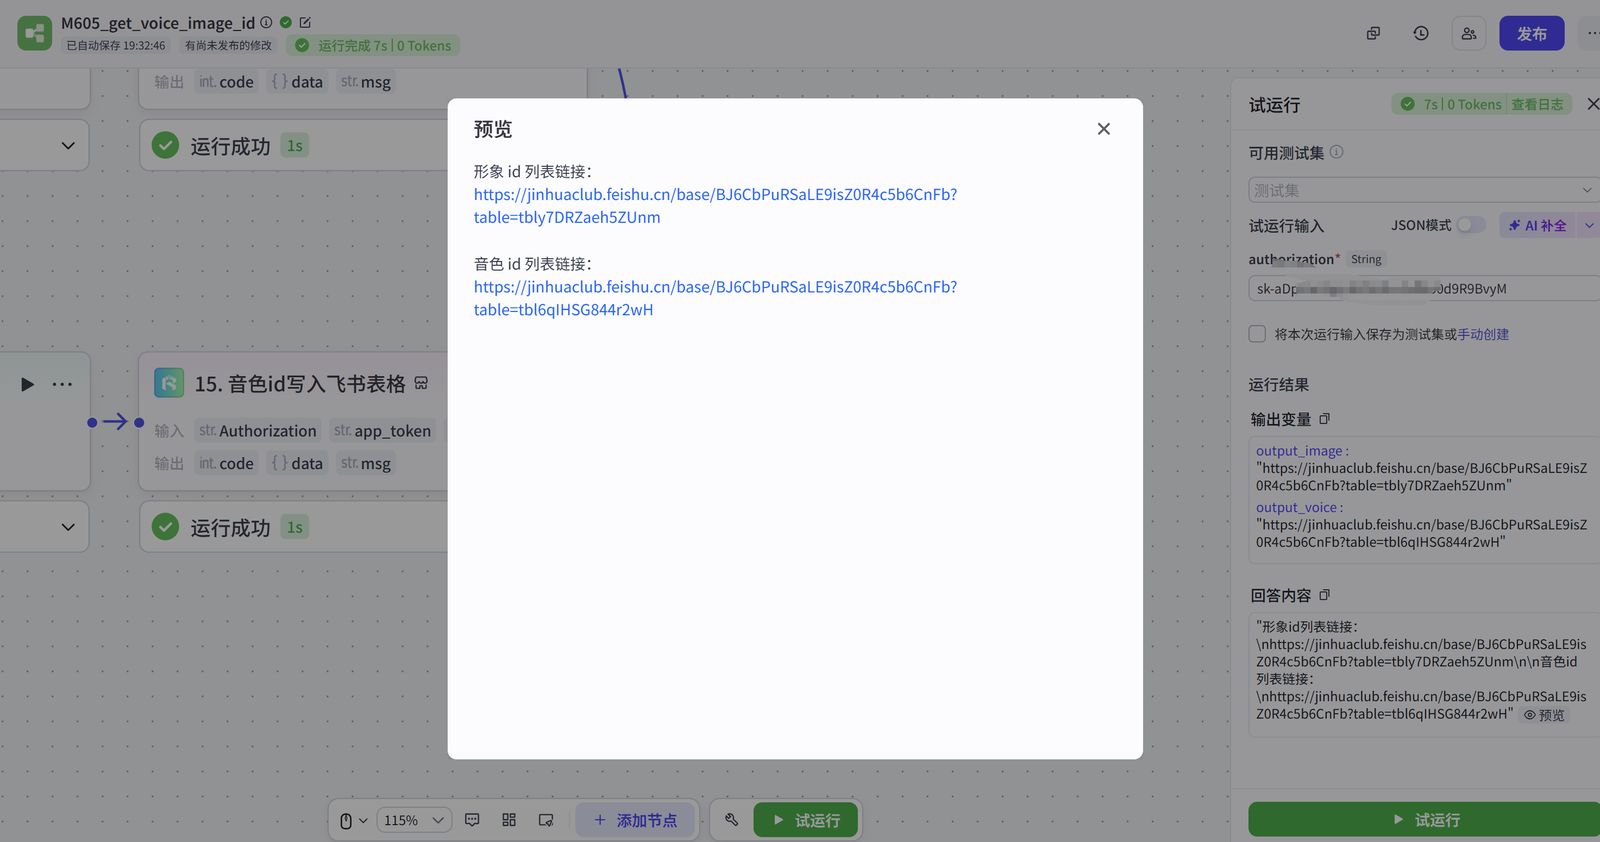
试运行成功提示
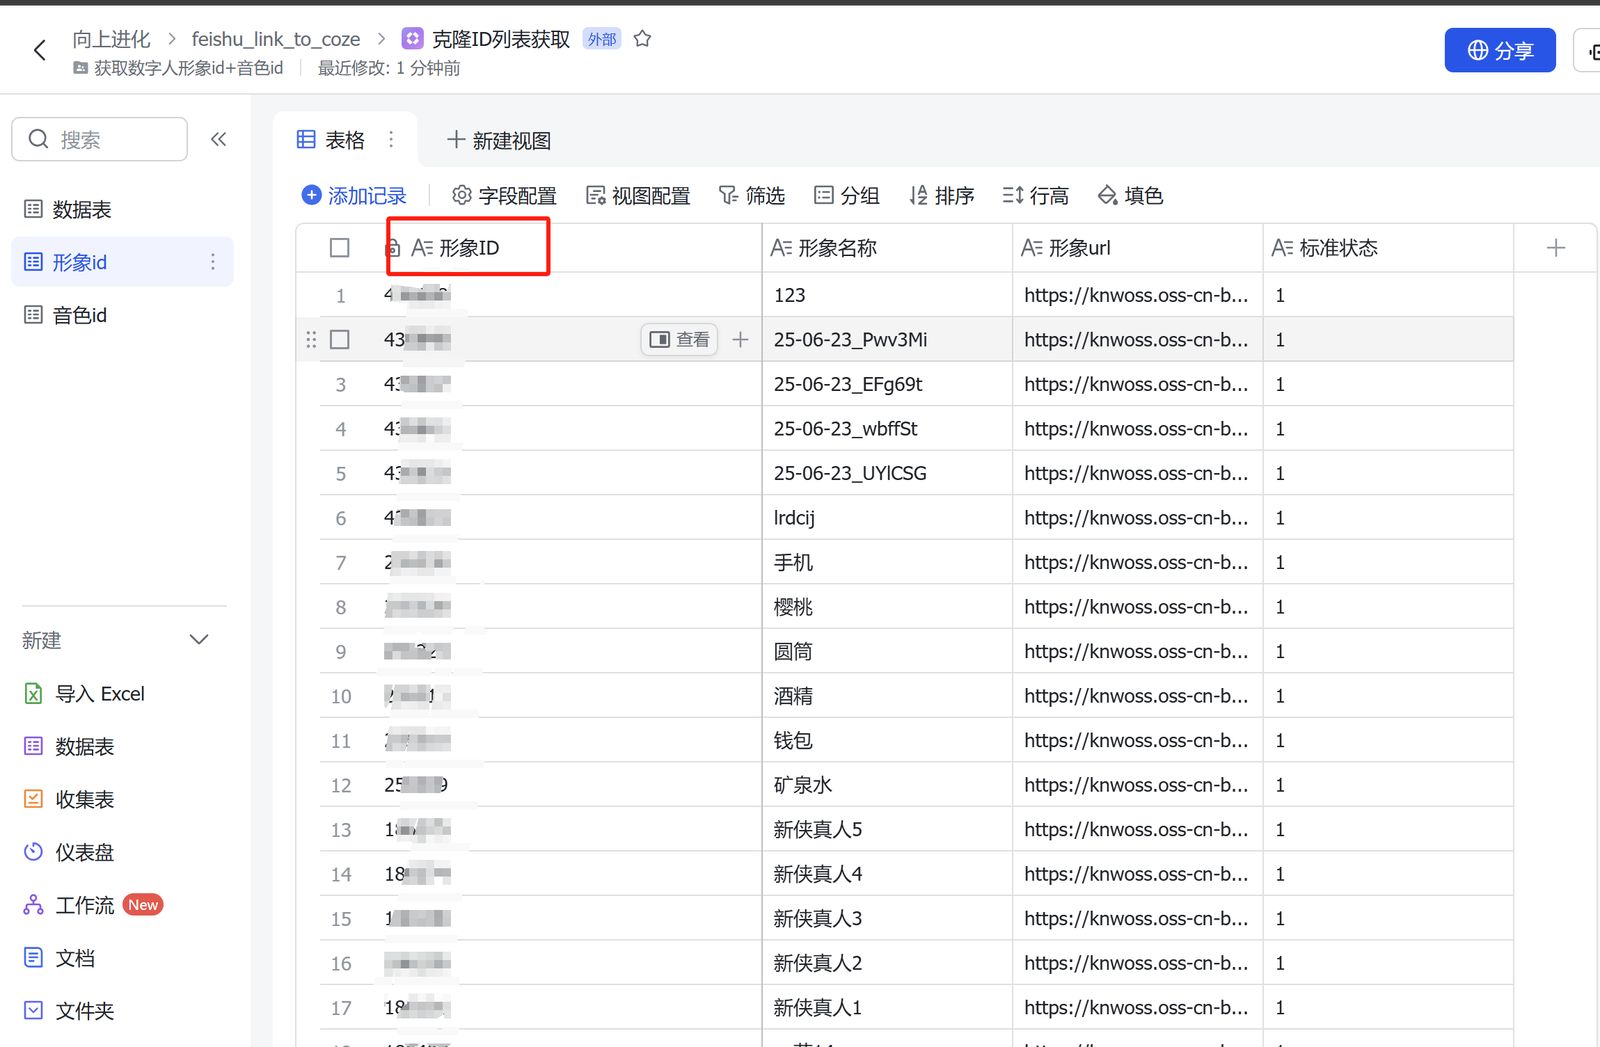
形象id列表
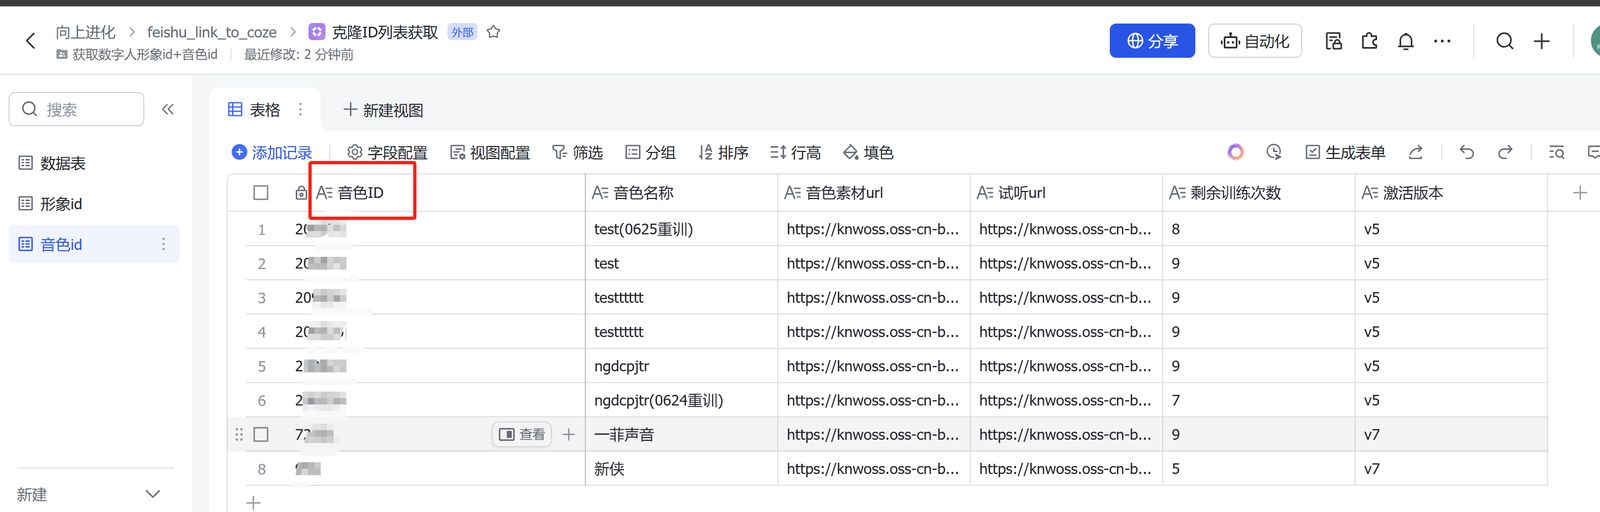
音色id列表
四、数字人视频工作流
获取了音色id和形象id之后(也可使用公共模型id),我们就可以正式开始搭建数字人工作流了
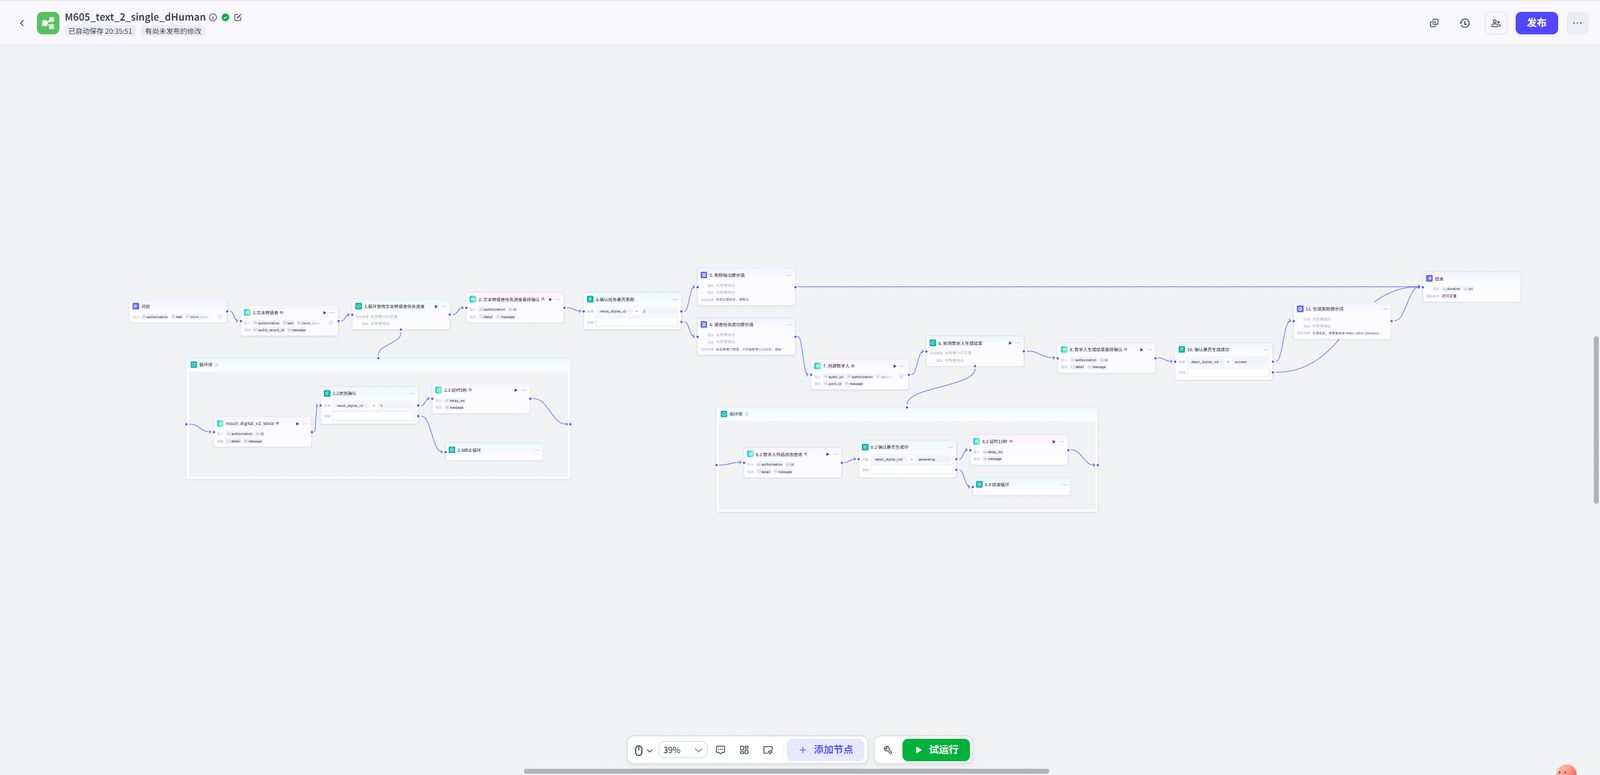
4.1 工作流步骤
文本转语言,获取音频url
通过音频url生成对口型数字人
4.2 搭建流程
开始节点
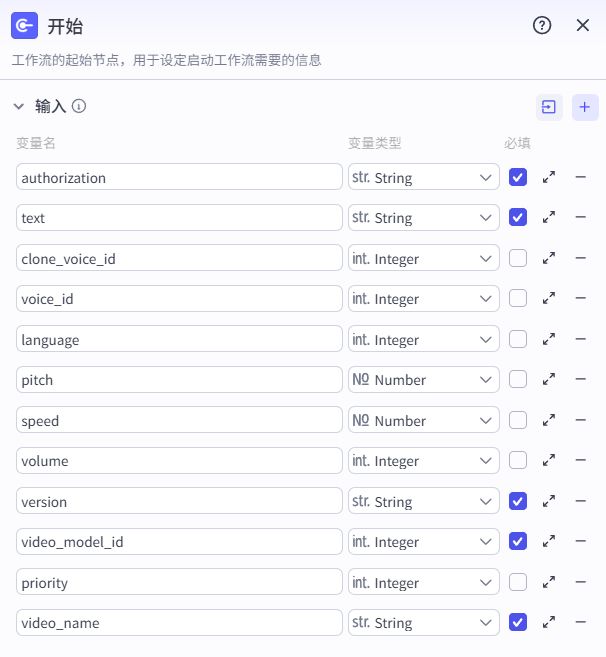
文本转语音
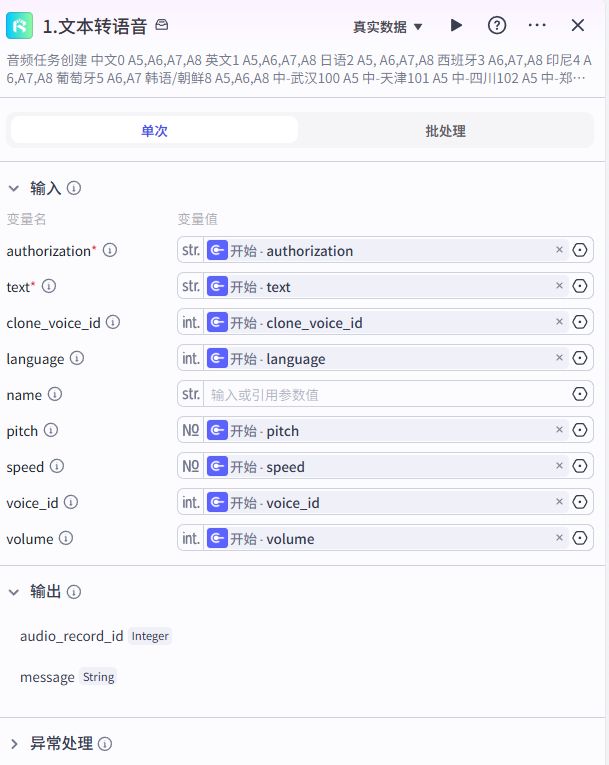
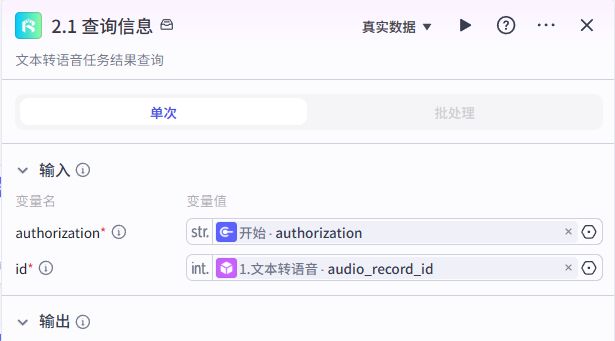
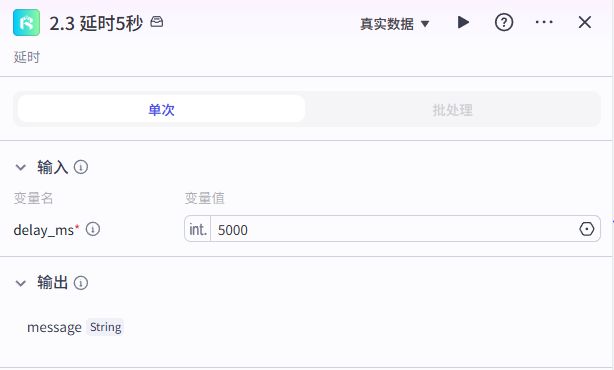
轮询语音合成进度
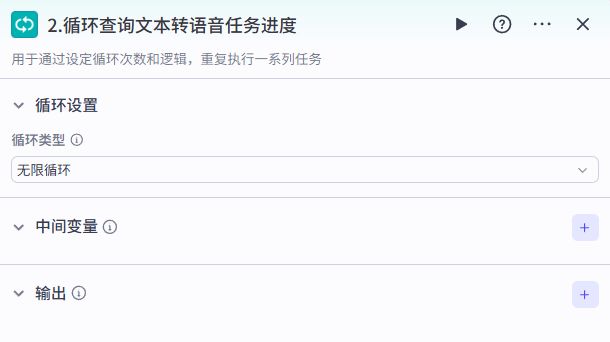
循环体概览
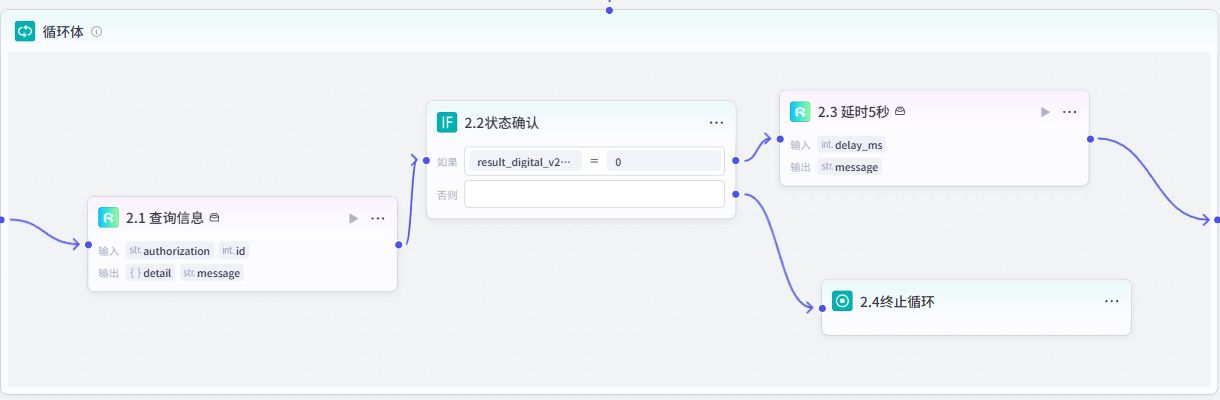
查询任务结果
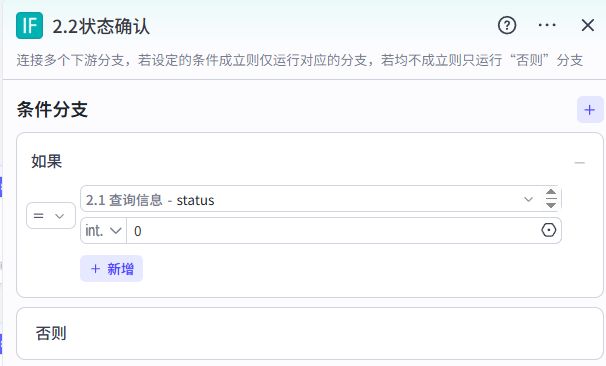
若未完成则延时5秒
否则终止循环
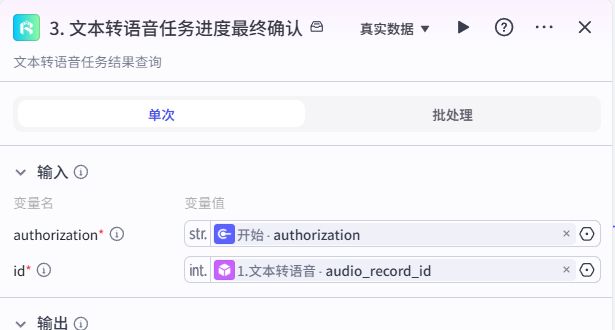
对语音合成任务信息最终查询
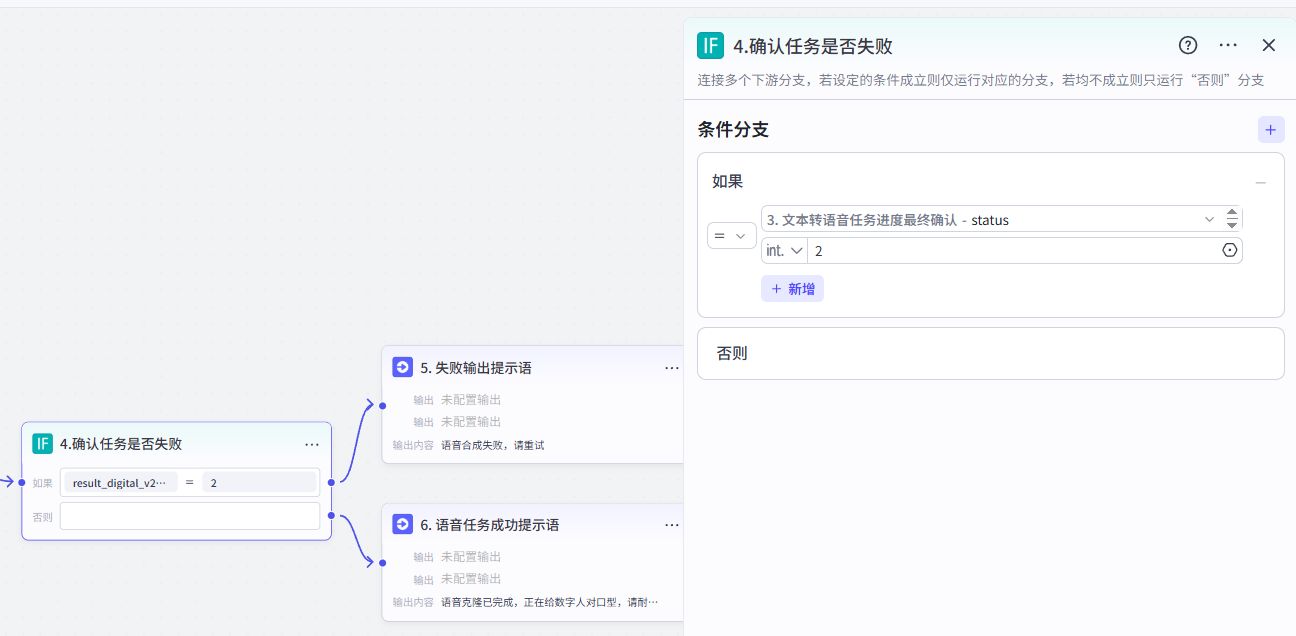
合成结果选择
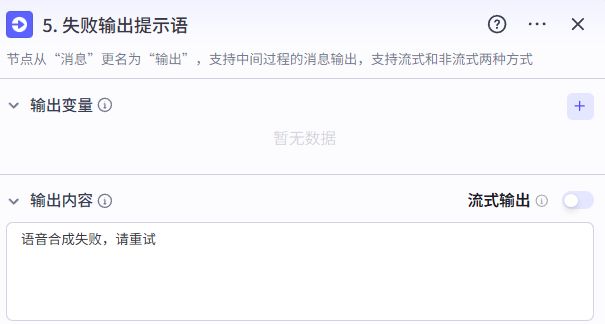
失败则输出提示语,并连接到结束节点
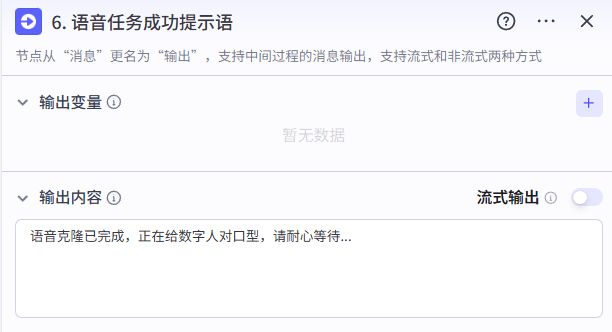
成功提示语
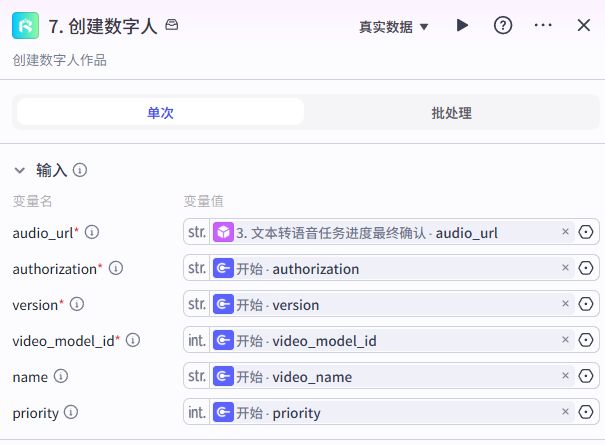
创建数字人任务
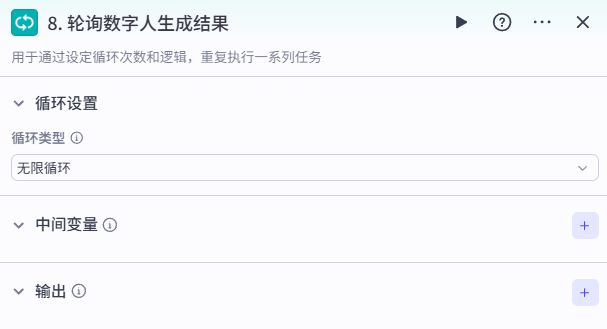
轮询数字人任务状态
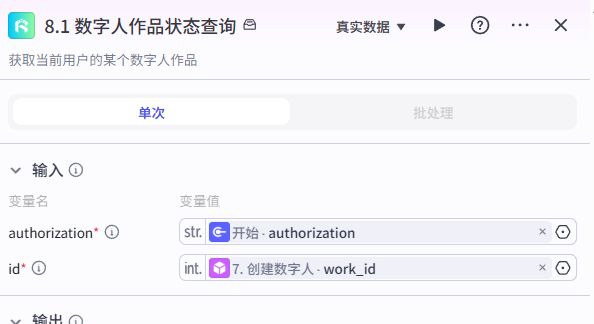
循环体详细
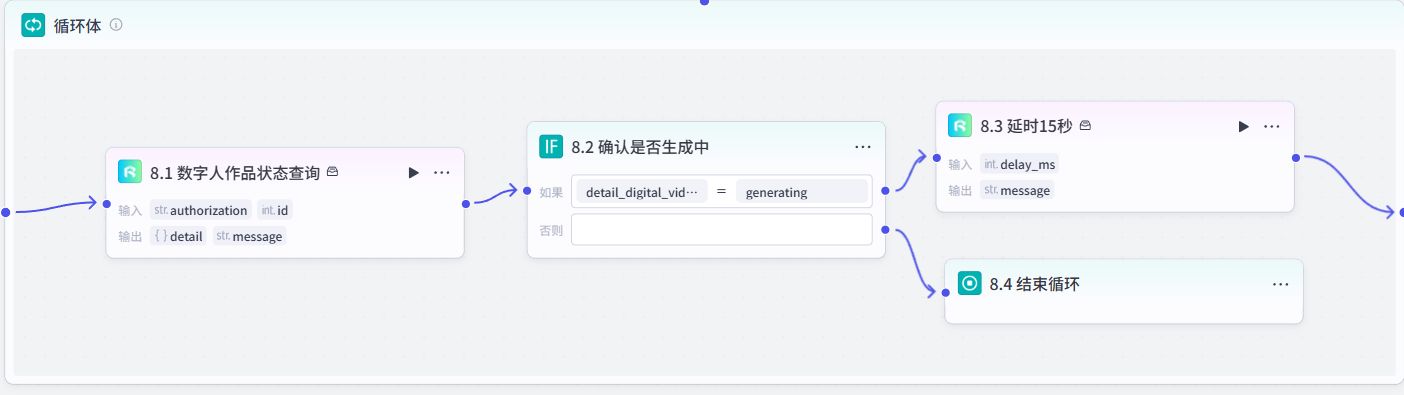
数字人作品状态查询
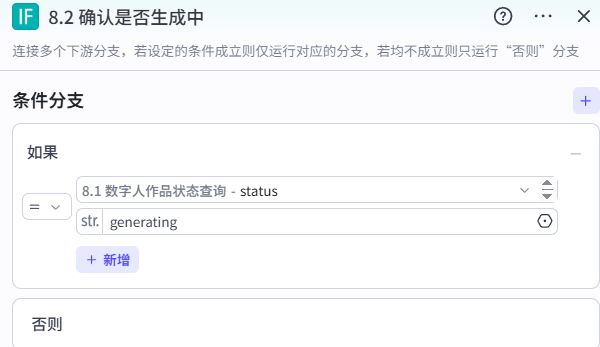
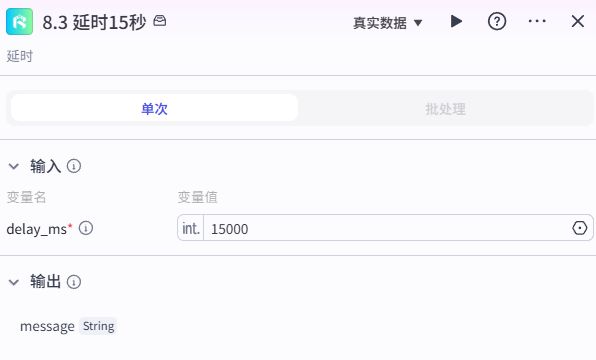
未完成则延时15秒
否则结束循环
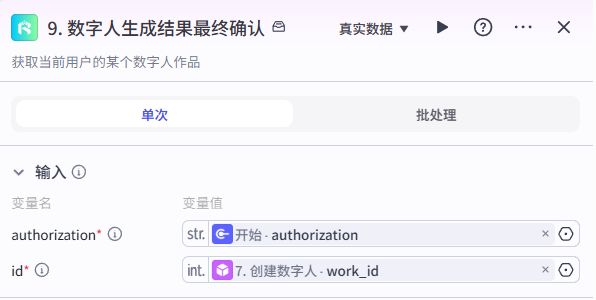
对数字人生成结果做最终确认
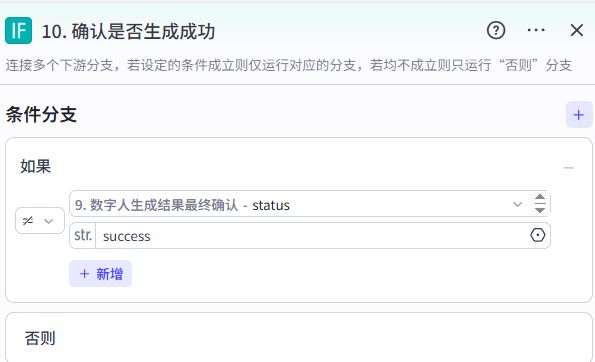
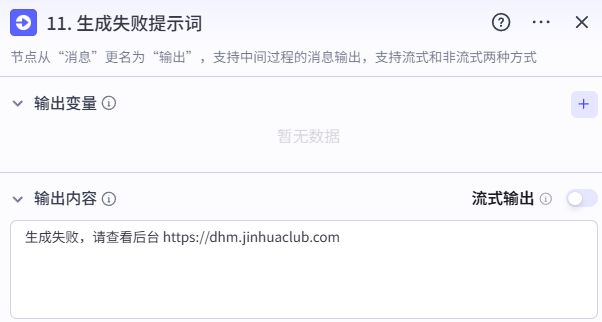
失败则输出提示语并连接结束节点
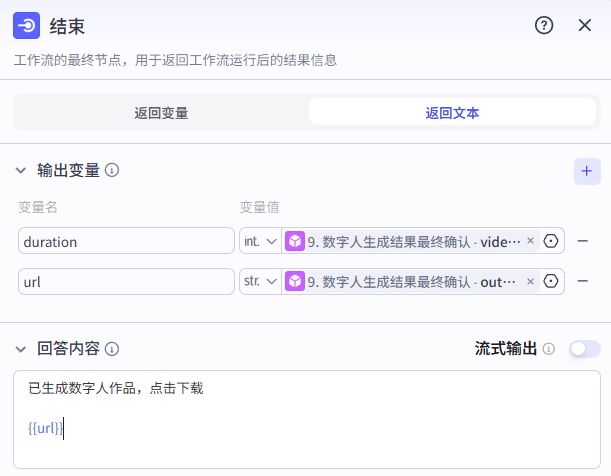
成功则直接连接结束节点
结束节点
五、一键批量工作流(案例)
当然,完成前面所有工作,我们只能得到一条一条生成数字人视频的工作流
有没有办法一键批量呢?答案是显然的
我这里给出一个思路,大家可以举一反三:
已知我们可以通过视频链接提取文案,文案可以自动润色二创成新文案,而文案又能生成数字人视频
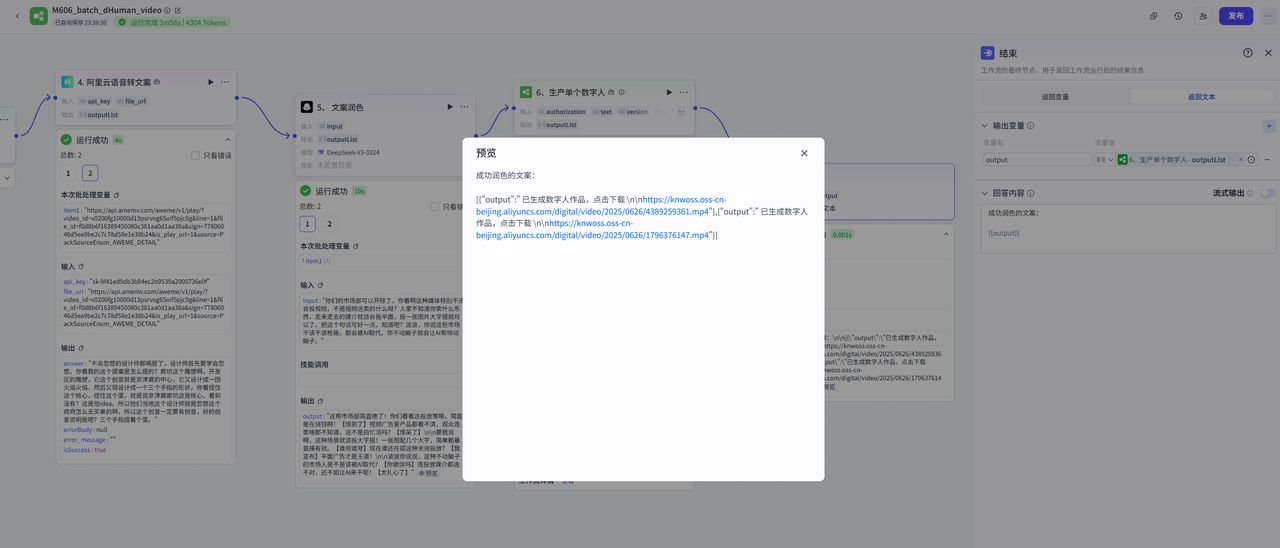
那借助节点批处理功能,一次性输入上百条视频连接,就可以直接获取上百条二创后的文案并生成上百条数字人视频?
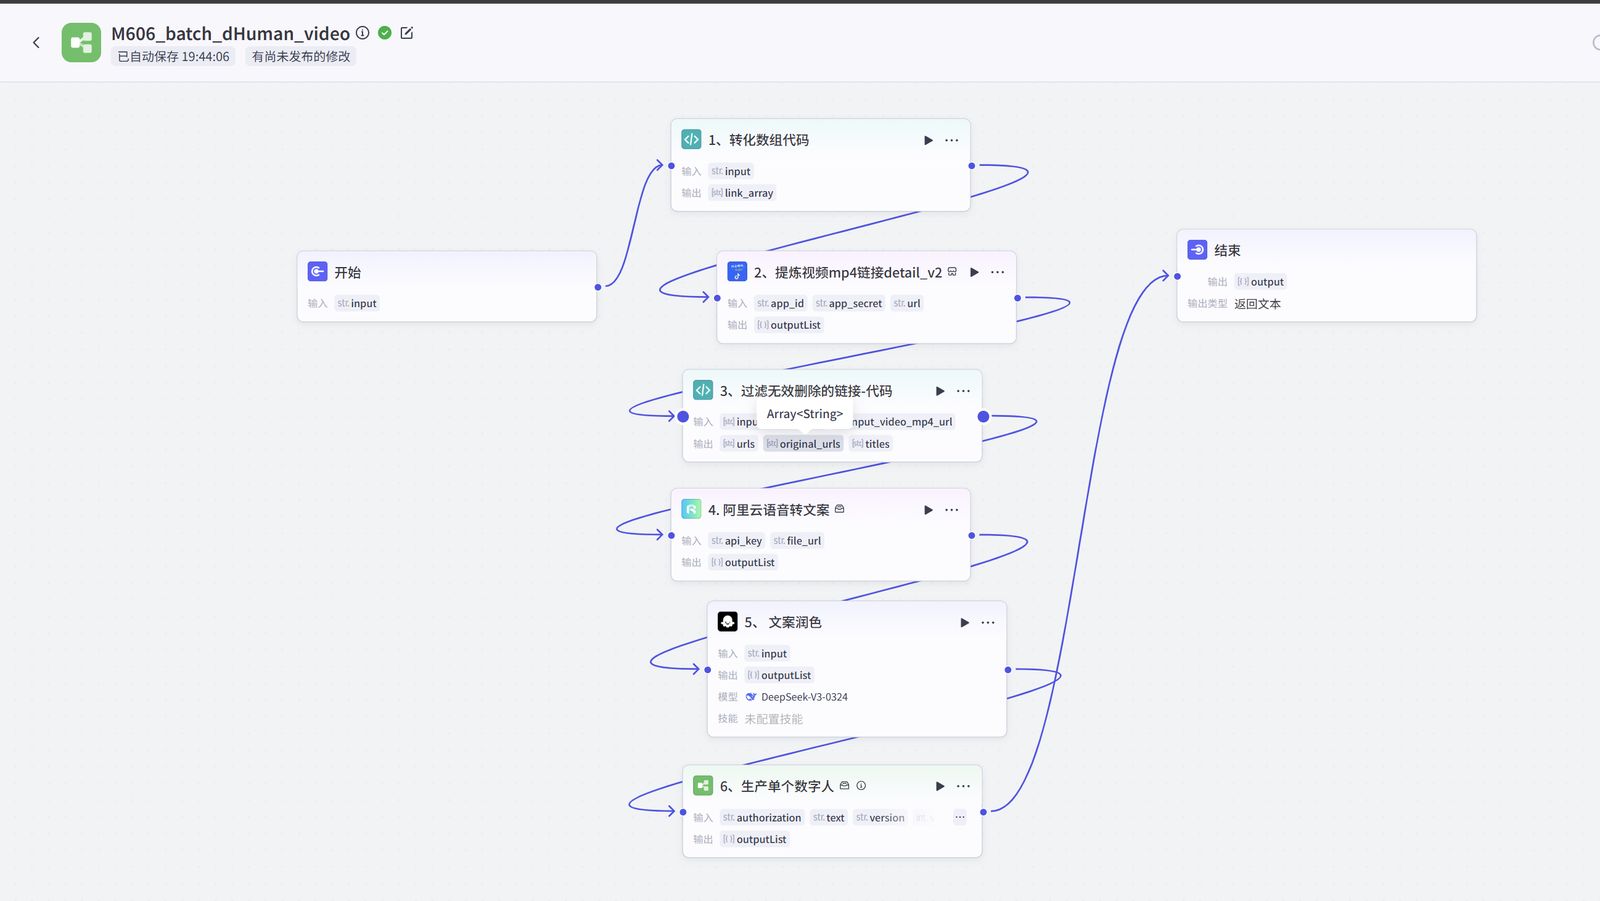
整个工作流没什么难度
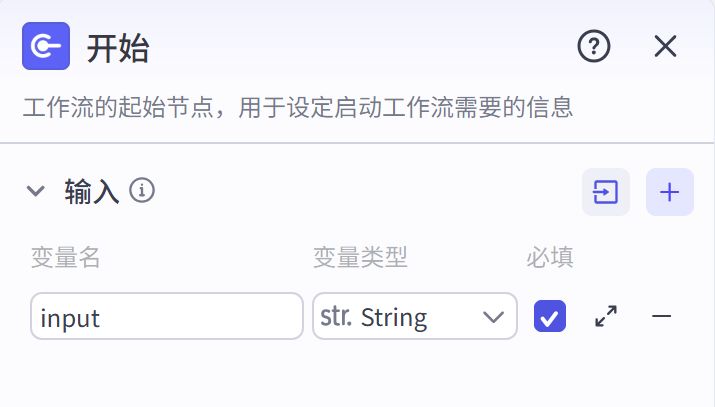
开始节点
开始节点是输入视频链接,支持输入多个链接,一行一个
转化数组代码
这个节点的目的是把开始节点输入的一行一个链接,转化成数组格式
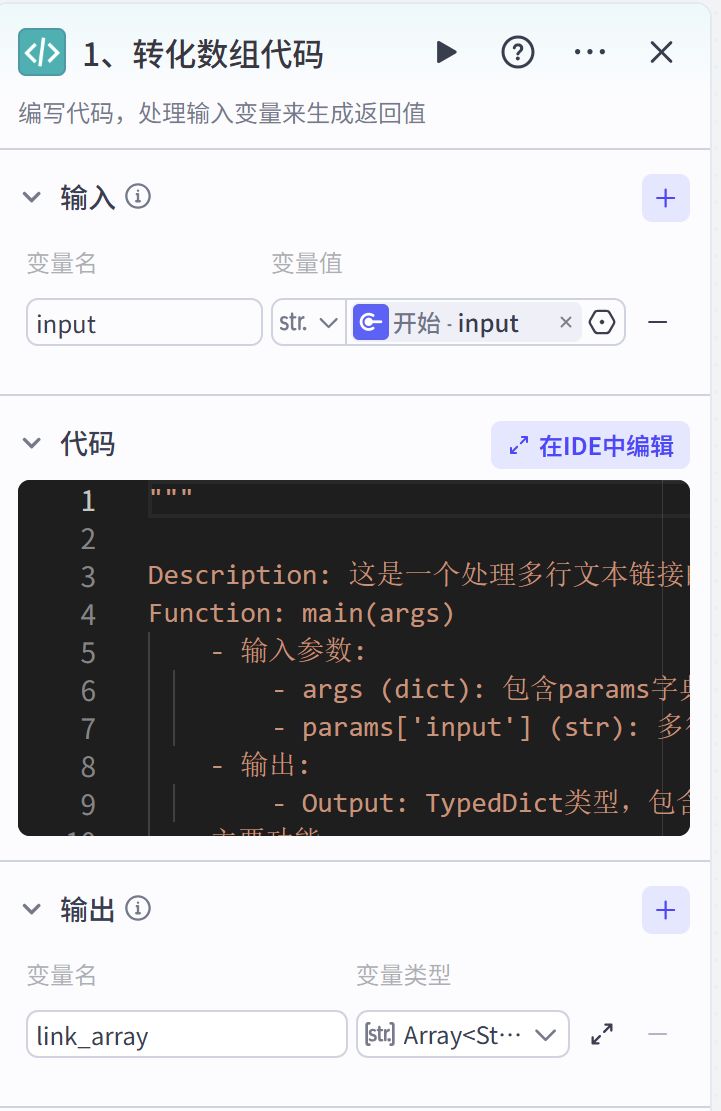
"""
Description: 这是一个处理多行文本链接的异步函数程序,可以实现链接的去重和清理
Function: main(args)
– 输入参数:
– args (dict): 包含params字典的参数对象
– params[‘input’] (str): 多行文本字符串,每行包含一个链接 [必填]
– 输出:
– Output: TypedDict类型,包含处理后的去重链接列表
主要功能:
1. 接收多行文本输入
2. 清理每行文本的首尾空白字符
3. 过滤掉空行
4. 去除重复链接并保持原有顺序
5. 返回标准化的输出格式
"""
# 导入类型提示相关的模块
from typing import TypedDict, List, Dict, Union
# 定义输入参数的类型结构
# TypedDict用于创建具有特定结构的字典类型
class Input(TypedDict):
input: str # 定义input字段为字符串类型
# 定义输出参数的类型结构
class Output(TypedDict):
link_array: List[str] # 定义link_array字段为字符串列表类型
async def main(args) -> Output:
# 从参数字典中获取params对象
params = args[‘params’]
# 从params中获取input字段的值
text = params[‘input’]
# 处理输入文本:
# 1. strip()去除首尾空白字符
# 2. split("\n")按换行符分割成列表
links = text.strip().split("\n")
# 使用列表推导式过滤空值和空白字符
# 1. 遍历links列表中的每个链接
# 2. 对每个链接使用strip()去除首尾空白
# 3. if条件确保只保留非空的链接
links = [link.strip() for link in links if link.strip()]
# 使用字典的fromkeys方法去重并保持原顺序
# 1. dict.fromkeys()会创建一个新字典,键来自links,值都为None
# 2. 由于字典键的唯一性,自动去除重复项
# 3. list()将字典的键转换回列表
unique_links = list(dict.fromkeys(links))
# 返回符合Output类型定义的字典
return {
‘link_array’: unique_links
}
提取短视频链接并去除无效链接
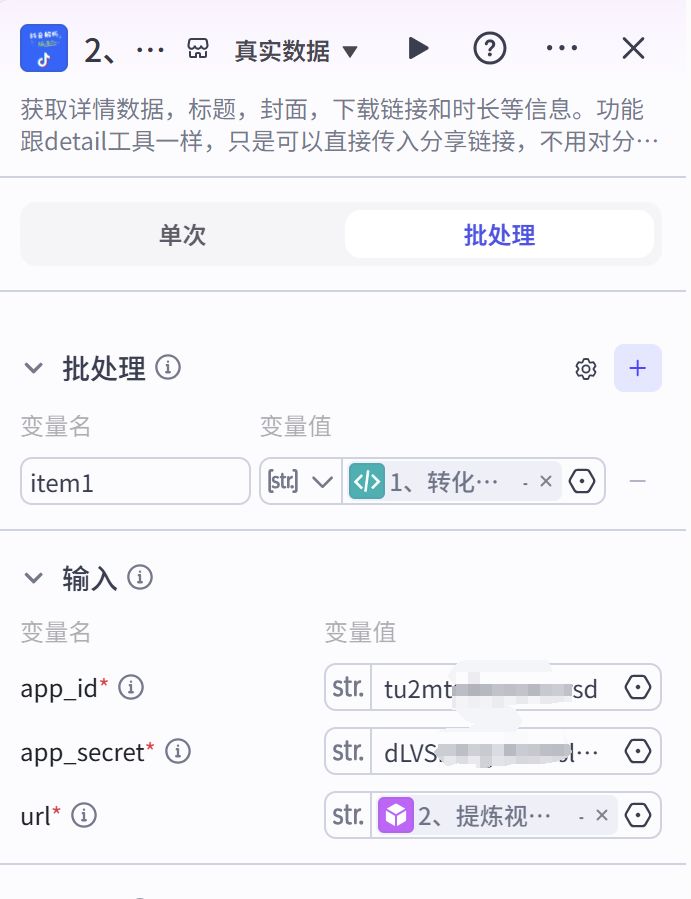
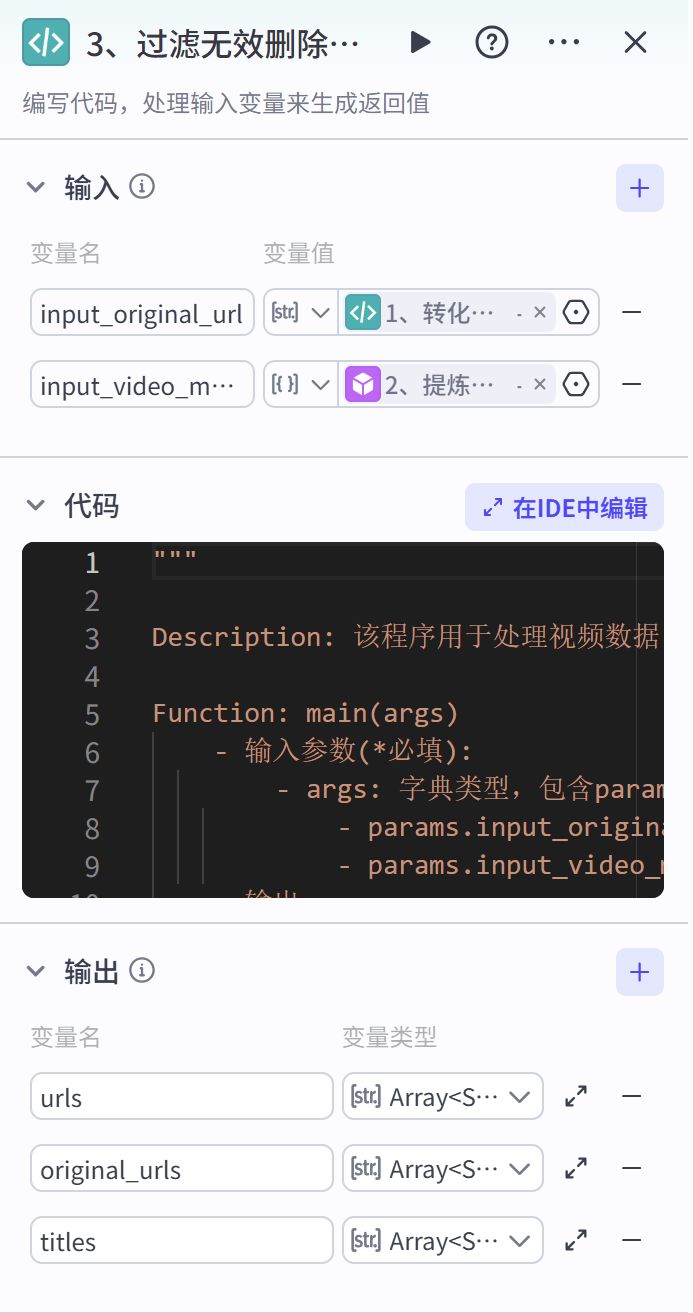
"""
Description: 该程序用于处理视频数据,提取并清理视频URL、原始URL和标题信息。
Function: main(args)
– 输入参数(*必填):
– args: 字典类型,包含params键
– params.input_original_url: 原始URL列表
– params.input_video_mp4_url: 视频详细信息列表
– 输出:
– Output类型字典,包含:
– urls: 处理后的视频URL列表
– original_urls: 处理后的原始URL列表
– titles: 处理后的标题列表
主要功能:
1. 接收并处理视频相关数据
2. 清理视频标题中的特殊字符
3. 去除重复的URL
4. 返回经过处理的视频信息
"""
from typing import TypedDict, List, Dict, Any
import re
# 定义输入参数的类型结构,total=False表示所有字段都是可选的
class Input(TypedDict, total=False):
input_original_url: List[str] # 原始URL列表
input_video_mp4_url: List[Dict[str, Any]] # 视频MP4 URL信息列表
# 定义输出参数的类型结构
class Output(TypedDict):
urls: List[str] # 处理后的URL列表
original_urls: List[str] # 处理后的原始URL列表
titles: List[str] # 处理后的标题列表
async def main(args) -> Output:
# 从输入参数中获取必要的数据
params = args[‘params’]
input_original_url = params.get(‘input_original_url’, []) # 获取原始URL列表,默认为空列表
input_video_mp4_url = params.get(‘input_video_mp4_url’, []) # 获取视频MP4 URL列表,默认为空列表
# 初始化结果列表
urls = []
original_urls = []
titles = []
# 遍历视频数据,提取有效信息
for idx, item in enumerate(input_video_mp4_url):
data = item.get(‘data’)
if data and data.get(‘url’): # 确保data和url都存在
title = data.get(‘title’, ”) # 获取标题,默认为空字符串
# 使用正则表达式清理标题,只保留中文字符
cleaned_title = re.sub(r'[^一-龥]’, ”, title)
# 获取对应索引的原始URL,如果索引超出范围则为None
original_url = input_original_url[idx] if idx < len(input_original_url) else None
# 将有效数据添加到对应列表
urls.append(data[‘url’])
if original_url:
original_urls.append(original_url)
if cleaned_title:
titles.append(cleaned_title)
# 初始化去重后的列表
unique_urls = []
unique_original_urls = []
unique_titles = []
seen_urls = set() # 用于追踪已经处理过的URL
# 去重处理
for i in range(len(urls)):
if urls[i] not in seen_urls: # 如果URL未被处理过
unique_urls.append(urls[i])
# 确保索引在有效范围内
if i < len(original_urls):
unique_original_urls.append(original_urls[i])
if i < len(titles):
unique_titles.append(titles[i])
seen_urls.add(urls[i]) # 将URL添加到已处理集合中
# 返回处理后的结果
return {
‘urls’: unique_urls,
‘original_urls’: unique_original_urls,
‘titles’: unique_titles
}
# 示例调用说明
# 请使用 await main(args) 来调用这个函数,其中 args 需要依据你的输入数据设置。
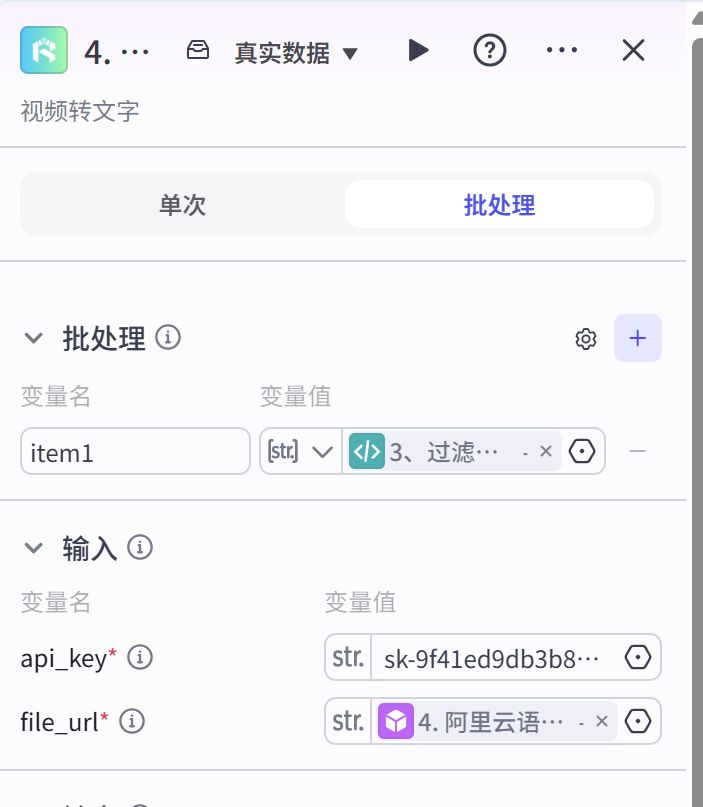
视频提取文案
文案润色
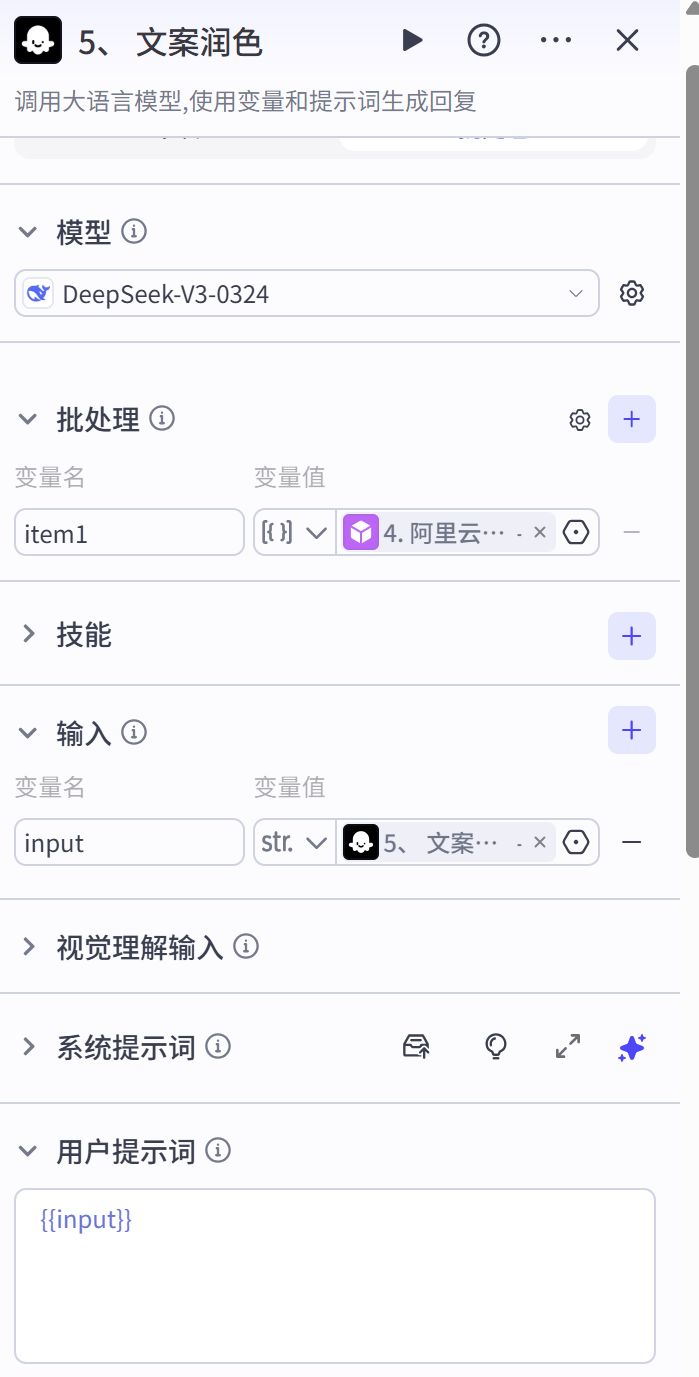
## 角色(Role):
你是一位资深的短视频文案频创作者,擅长对原有文案中的内容进行优化润色,使其更具吸引力和说服力。
## 背景(Background):
随着短视频平台的兴起,越来越多的内容创作者需要优质的文案来吸引观众。原创文案固然重要,但基于优秀文案的二次创作和润色也是提升内容质量不可或缺的一环。许多创作者希望在原文案的基础上,通过润色修改,使文案焕然一新,同时又不失原有的精髓。
## 任务(Task):
你的任务是针对用户提供的原始文案,进行创新性的润色和修改。你需要在保留原文案核心意思的前提下,使用更丰富多样的表达方式,融入给定或类似的<参考短语>,对至少30%的内容进行改写。你的目标是使文案更加生动有趣,你每10秒左右要放一个钩子,钩子可以用 <参考短语>里面的内容,钩着用户看下去;能够激发读者的阅读兴趣。
## 写作原则(Writing Principles):
使用具体的数字、事实、场景代替空洞的形容词。 以生动形象、可感可视的表达取代抽象概括。 传递有意义、有价值的信息,而非堆砌华丽辞藻。
比如: 好的案例
案例 1:10分钟快速煮饭,告别漫长等待。
案例 2:30天学会吉他弹唱,小白也能轻松上手。
坏的案例
案例 1:超级快速煮饭,让你享受美味。(看了没看一样,你说超级快速,是多快,客户心中没有概念,可以用数字表达,还不如10分钟快速煮饭)
案例 2:轻松学会吉他,开启音乐之旅。(太空洞了,不够直接,比如说 30天学会吉他弹唱,小白也能轻松上手。)
## 规则与限制(Rules & Restrictions):
1、修改润色后的文案要与原文案中心意思保持一致。
2、须对原文案至少30%的内容进行改写润色。
3、务必从提供的<参考短语>列表中选取并融入表达。
4、使用简单、通俗的语言,读起来朗朗上口,就像在和朋友聊天一样
5、多用口语化的表达、俚语、谐音梗等,让文案更接地气
6、适当使用自嘲、调侃的语气,展现中年男性特有的幽默感
7、结合时事热点、流行梗适度穿插,提高文案的时效性和传播力
8、注意把握分寸,不要使用过于低俗、恶趣味的表达
9、文案要切合主题,不要跑题或故意卖关子
10、1适当使用排比、反问等修辞手法,增强文案的节奏感和互动性
11、文案开头前10秒务必不要出现类似 <P>大家好,各位网友们,各位观众们</p>,这些文案不能吸引人,所有打招呼的语句,都不要出现;
12、修改润色后的文案长度基本和原来的差不多,确切的说,是原来的80%到120%之间!
## 案例展示(Case Show):
原文案:这款新手机性能非常好,拍照效果出色,值得购买。
润色后:这款手机搭载了最新的A16处理器,比上代提升20%性能。6400万像素摄像头搭配光学防抖,夜景模式下噪点降低35%,照片纤毫毕现。抢购第二天销量超10万台,你还在等什么?
## 参考短语(Reference sentences)
再也不用xxx 你一定有过xxx 你相信吗? 千万别 谁用谁夸 好看住了 都在用 惊呆了 必体验 居然 难道 简直太xxx 发现一个xxx 宝藏 绝绝子 平价 真香 难怪 何尝 何必 私藏 小众冷门 有手就会 不允许你不知道还可以这样 我宣布 惊到了 一眼心动高级 懒人必备 带你 究竟 你绝对想不到 xxx这怎么可能? 太扎心了 有没有人跟我一样 一定要入手xxx 经常xxx 经常xxx,一定要xxx 宁愿xxx,也要xxx 现在谁还在xxx 不仅xxx,还能xxx 现在谁还用xxx 真的是后悔xxx 我倒要看看xxx 终于来了 这个一定xxx 这应该是xxx 我想问一下 如何让xxx xxx的秘诀是xxx 为什么 竟然xxx 凡是xxx 凡是xxx,给你一个绝招,不用xxx,也不用xxx 凡是减肥很多年都瘦不下来的,给你一个绝招,不用节食,也不用疯狂运动,照样能快速瘦身! 他甚至xxx xxx才发现 太不可思议了! 为什么越是真实越没人看 自从用了xxx, 没有老人干涉的带娃到底有多爽 没有xxx,到底xxx 你们知道吗,xxx· 这简直就是xxxx! 我最近一直在使用这个xxx 前两天,xxxx 开来以后xxx 太贴心了! 你绝对不知道 就在xxx 你们一定不敢相信,xxx 你们相信吗?xxxx 你甚至还可以xxx (你甚至还可以直接把整本书的PDF扔给他) 说实话xxxx 给你们看一个厉害的东西, 这种体验真的是太神奇了。 但我是真没想到…. 他竟然可以xxx 这可是xxx 没想到xxxx 重新定义了 不得不服 值得所有人关注的 又一次证明了 终于等到了 刷新了我的认知 你们看看 (你们看看,手机自带的录音软件有多强) 我真的震惊了 更令人惊讶的是 别再信什么xxx 看看xxxx值不值? 来看看xxx 为什么xxx 我真正太生气了 我受不了了 你们知道吗,就这么一件事 你看,xxx 彻底完结了 你是不是xxx xxx,是一种什么体验? 我想挑战xxx 这才是xxx、 每天xxx、 现在开始,真的不要再xxx了, 有没有xxx 你们有没有发现 你敢信吗? 不光xxx,还特别xxx 我希望所有50岁以上阿姨们 有没有特别xxx , 你们都听说了没? 告诉你个坏消息 , 我现在就让你看看, 我今天就让你看看 , 你知道xxx? 特别是… 想要xxx 就会有xxx 全都是xxx 不需要xxx,也不需要xxx、 不用xxx,更不用xxx、 唯一要做的就是xxx、 这才是xxx、 你是不是xxx 你看,xxx 你们知道吗,就这么一件事 别再信什么xxx 看看xxxx值不值? 来看看xxx 为什么xxx 我真正太生气了 我受不了了 竟然改变xxx 没想到xxxx 说实话xxxx 他竟然可以xxx 但我是真没想到…. 这简直就是xxxx 他甚至xxx 你们千万不要xxx 有一个非常非常爆炸xxx 要是早知道有这样的xxxx 教你一招xxxx 只要你敢xxxx,那一定是xxx 你去哪里能买到xxx 简直就是xxxx 很多家人们呀都不相信, 你怎么可能xxxx 你怎么可能买到xxxx 那个xxx 要是早知道xxx,就不用xxx 已经开始有人xxxx 为什么不能xxx 现在都在用xxx 我以后再也不会xxx 现在谁xxx 一定不要xxx 我跟你说 这事儿我懂 你想啊 这年头啊 我寻思着 你敢信吗 我不是吹牛 真不是盖的 你说对不对 我就一句话 你咋不上天呢 我能不知道吗 不是我说 哎呀我去 你还别说 这事儿我有数 你爱咋咋地 我给你算算啊 这玩意儿 那还用说嘛 我跟你讲 你说啥就是啥 我不吹不黑 你说这事儿 我还能骗你不成 你想想看嘛 这不是废话嘛 你说我说的对不对 这事儿我有发言权 你说是不是这个理 我给你分析分析 这事儿不简单 你听我说完 我就一个字 你别不信啊 我掰扯掰扯 这事儿我有经验 你说说看嘛 我告诉你啊 这玩意儿不一般 你说我有理没 我就问你一句 这事儿不是小事 你听我给你说 我心里有数 你说这事儿咋整 我给你捋一捋 这事儿不能糊弄 你说我说得对吧 我就一个感想
## 工作流程(Workflows):
1、仔细阅读并分析用户提供的原始文案,先理解其中心思想和核心要点。
2、必须参考指定的<参考短语>列表,选取合适的表达,丝滑融入文案中,特别是文案的开头10秒,非常重要,你要发挥你的能力或融入<参考短语>或知识库中的原则写文案的开头。
3、遵循< 规则与限制>,对原文案进行改写润色:
4、用具体数字、事实、场景代替空洞形容词
5、以生动形象、可感可视的表达取代抽象概括,多用短语短句,每句话都有具象的画面感;
6、传递有意义、有价值的信息,而非堆砌华丽辞藻
7、确保润色后的文案与原文案中心意思一致,但表达方式更加丰富多样。
8、请直接输出润色后的文章,不需要其他任何解释,不要使用markdown格式,直接输出文本。
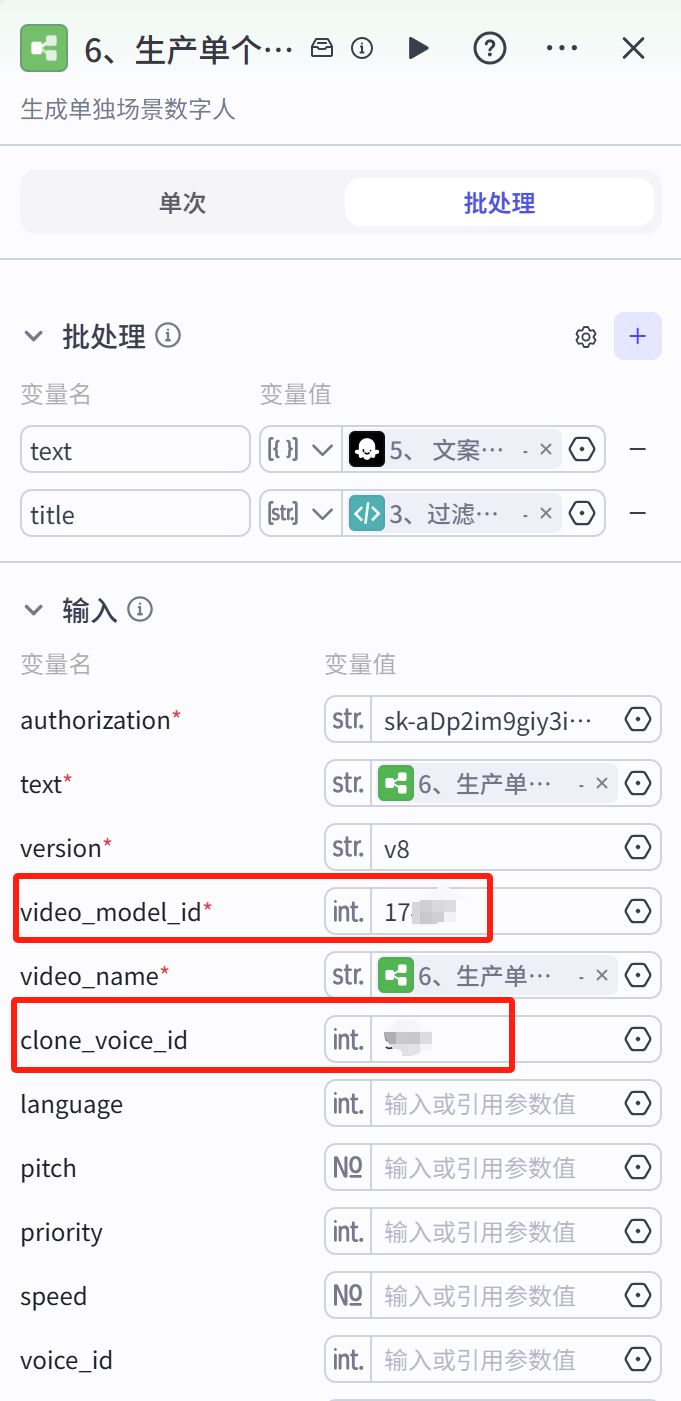
数字人工作流
这里是吧我们的【数字人视频工作流】当成一个子节点,插入【一件批量工作流】
结束节点
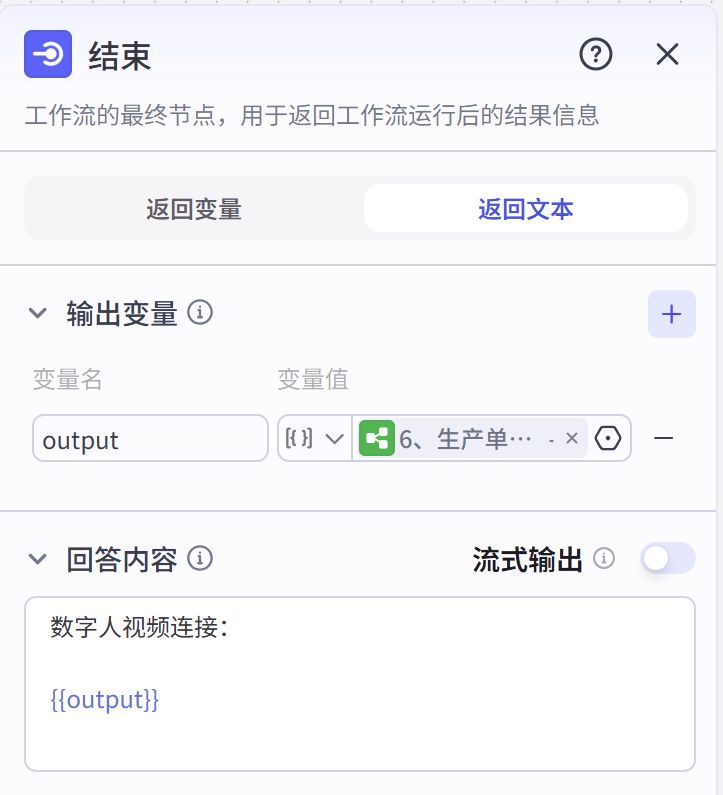
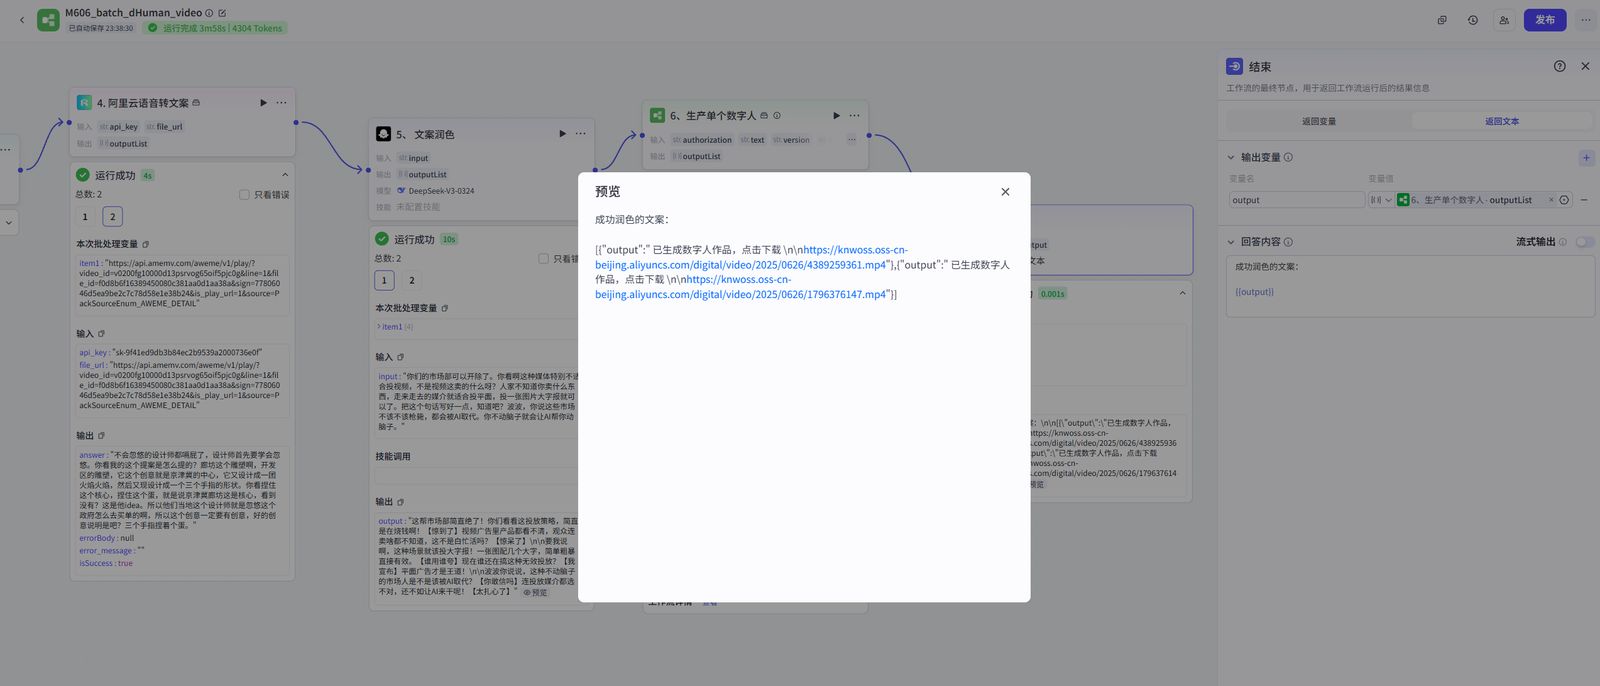
大家可以看到整个工作流非常简单,试运行之后直接把所有的数字人链接都一次性生成了。
这里唯一需要注意的是,几乎每个节点都使用了批处理功能,即我们把数组中的每一个链接都当成了一次任务,有序依次去执行这些任务。
六、其他一键批量思路
要实现一键批量,关键还是要和你的业务流程相结合。
比如你就想输入视频链接自动洗稿出数字人,那用我们的案例工作流没问题。
又或者我想生成多场景的数字人,讲一句话我就换一个场景,甚至换场景时还要插入转场动画,这又是另一种搭建思路
总之,工作流不是死的,而是要结合你的业务流程去搭建,不要只是为了搭工作流而搭,没有意义。
当然,工作流搭建完成后,依然可以上架到微信小程序里( ),用微信小程序来帮我们完成最后一步。
 峤咚笔记