 峤咚笔记
手把手教你使用N8N抓取Reddit中任意子频道关键词数据采集到多维表格并分析提炼和挖掘信息,帮你出海挖需求
你好,我是龙哥,RPA教练和AI智能体教练,专注于使用N8N,RPA,AI智能体,AI编程等AI技术提效。
最近很多大佬都在讨论Reddit,于是好奇的我也去瞅瞅,也让我发现一些好玩的东西,原来Reddit才是这个世界的样子。这里有35万个兴趣小组,你总能找到自己的创意和需求和好玩的东西。
Reddit介绍
很多人说Reddit类似于国内知乎豆瓣微博,于是我问了一下DeepSeek他们之间的优势与劣势。
总的一对比,发现Reddit甩国内这几个平台几十条街。
Reddit 是一个非常独特且庞大的网络社区,其特点非常鲜明。可以把它理解为一个由无数个细分兴趣小组(称为“subreddit”)组成的、用户驱动的内容聚合和讨论平台。
好家伙35万个兴趣小组
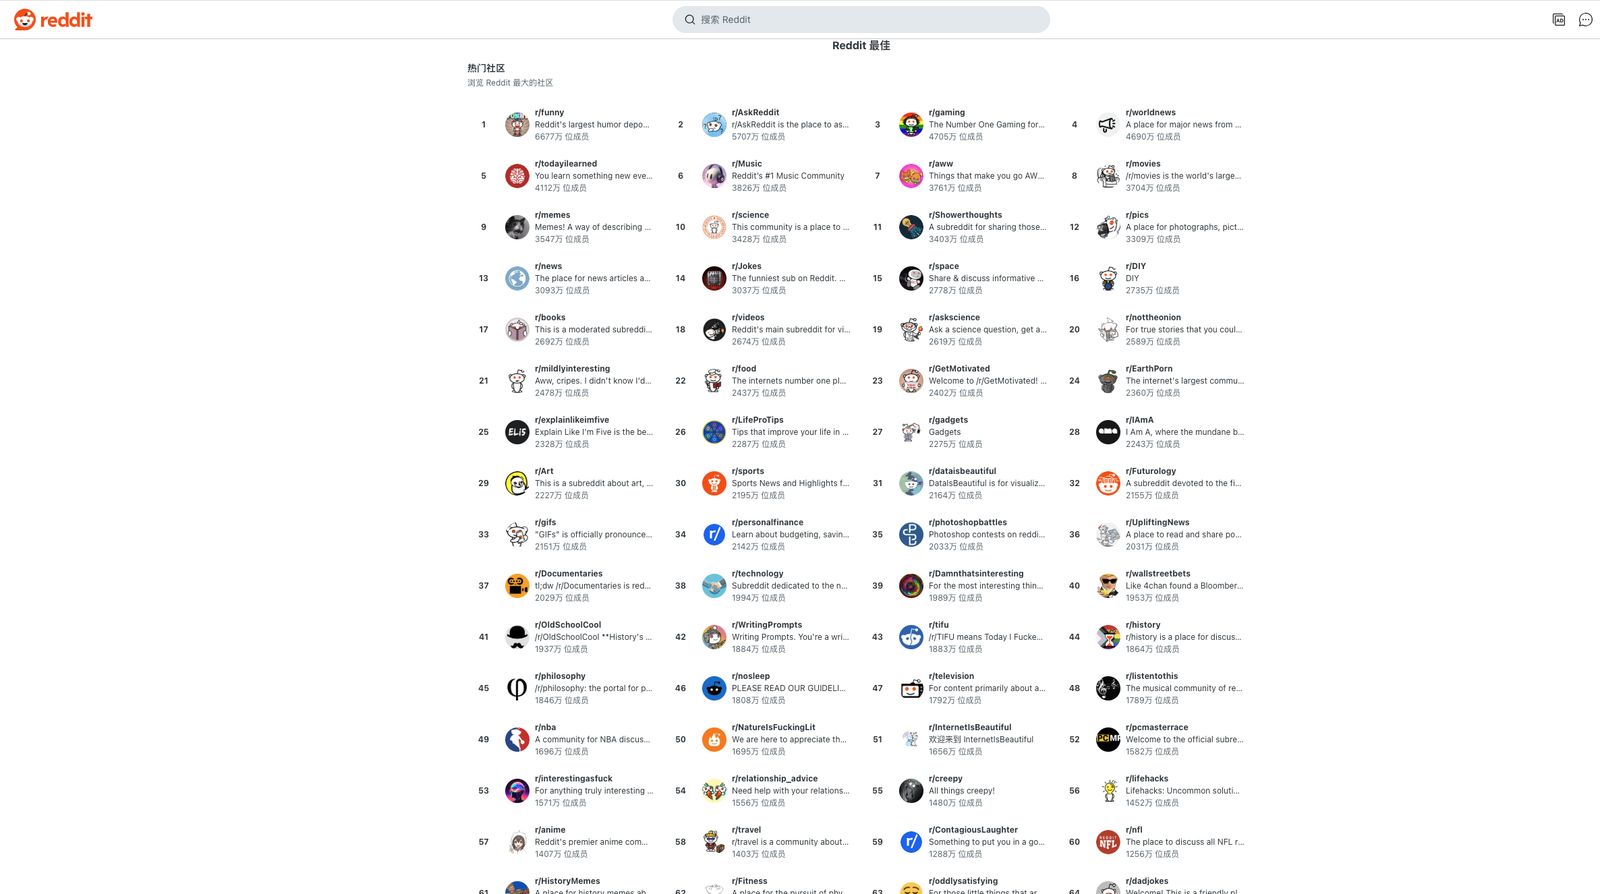
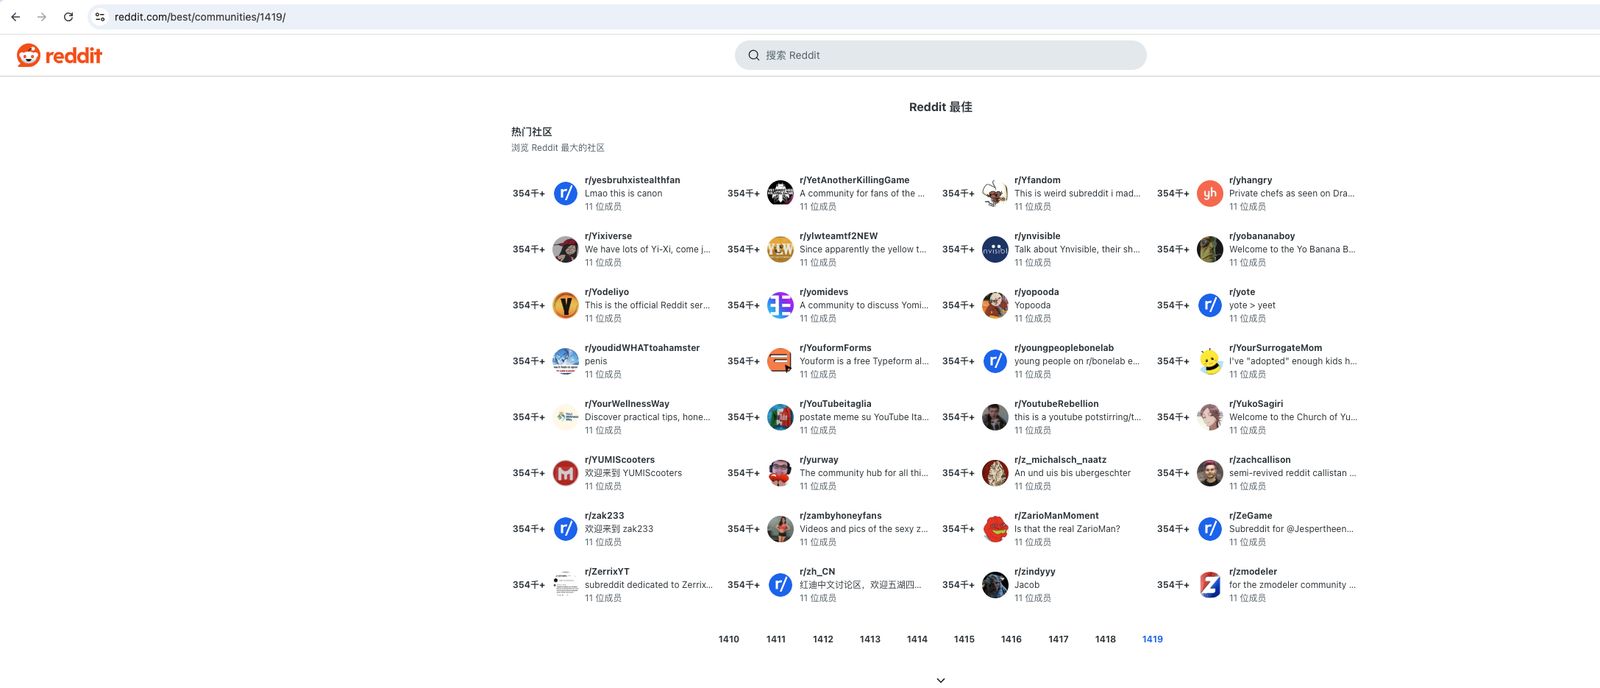
Reddit 的特点可以概括为:
它不是一个大社区,而是无数个小社区的集合。
它的内容不靠编辑推荐,而靠用户民主投票。
它的文化和氛围由每个子社区的成员共同塑造。
它既是获取深度、前沿信息的天堂,也可能充斥着糟粕和极端内容。
正因为这些特点,Reddit 成为了一个极其强大、复杂且充满活力的互联网缩影,吸引了全球数以亿计的用户,这是一个非常去中心化平台,能听到全世界的声音,值得好好研究。
我用Reddit获取高质量信息
既然Reddit能让我们听到全世界的声音,那么我想看看N8N平道有啥好玩的东西,于是我就去做了。
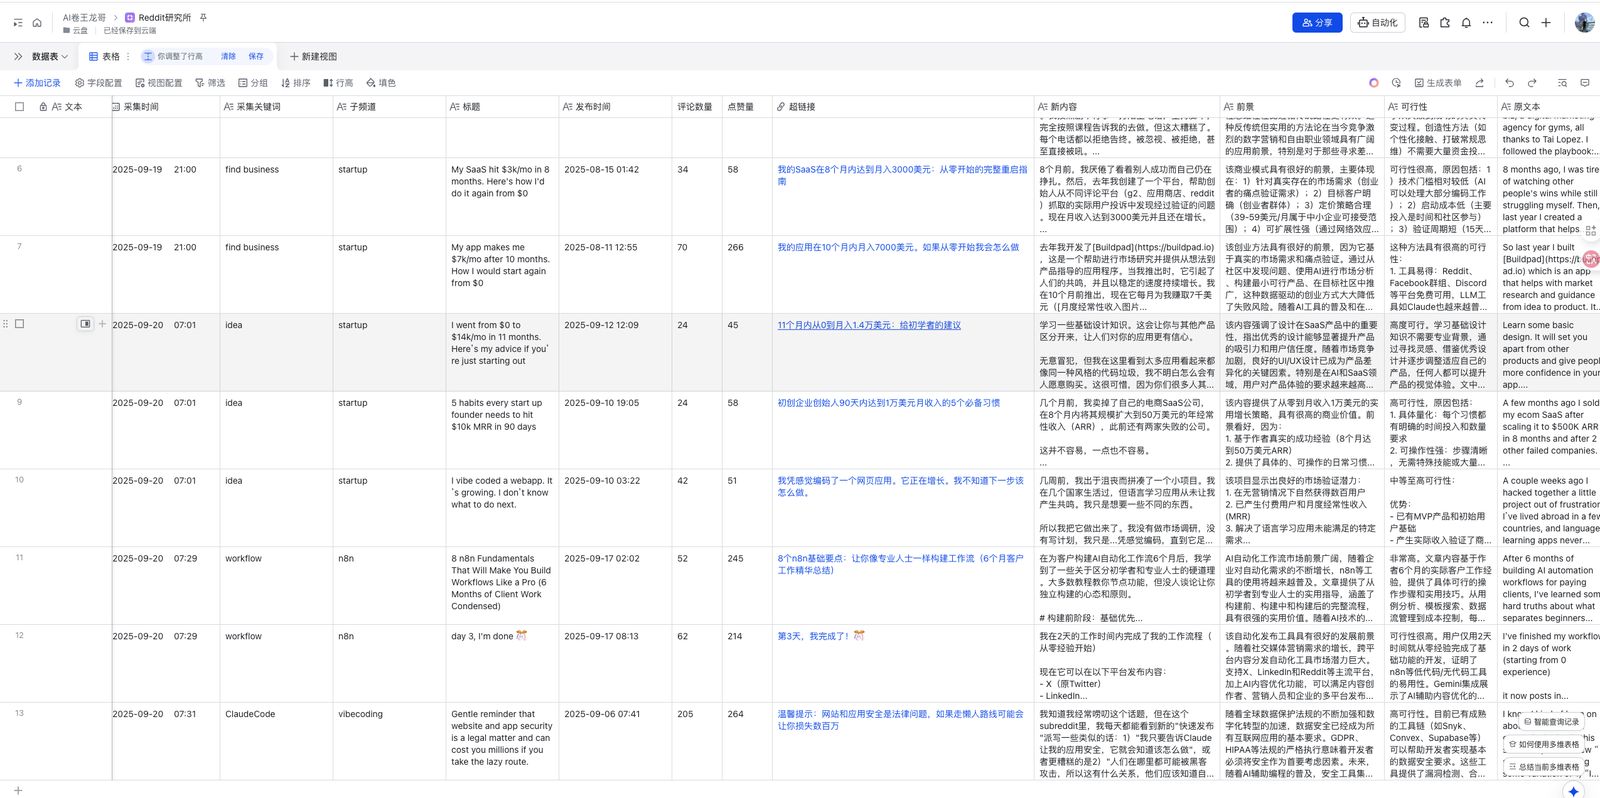
我在Reddit子频道N8N中搜索有关油管的话题,然后筛选半年内且有50个赞的有关油管的话题,然后用AI翻译并整理这些内容,并做一个话题的前景和可行性报告,然后保存到我的多维表格,方便研究数据。另外我也可以获取r/startup下的创业信息,反正信息量足够大,然后我把我获得的信息翻译提炼放到飞书,方便我查阅
如果我想找其他话题也是可以的,我只需要定制输入就好了,非常方便我看到全世界,看起来是不是很酷!
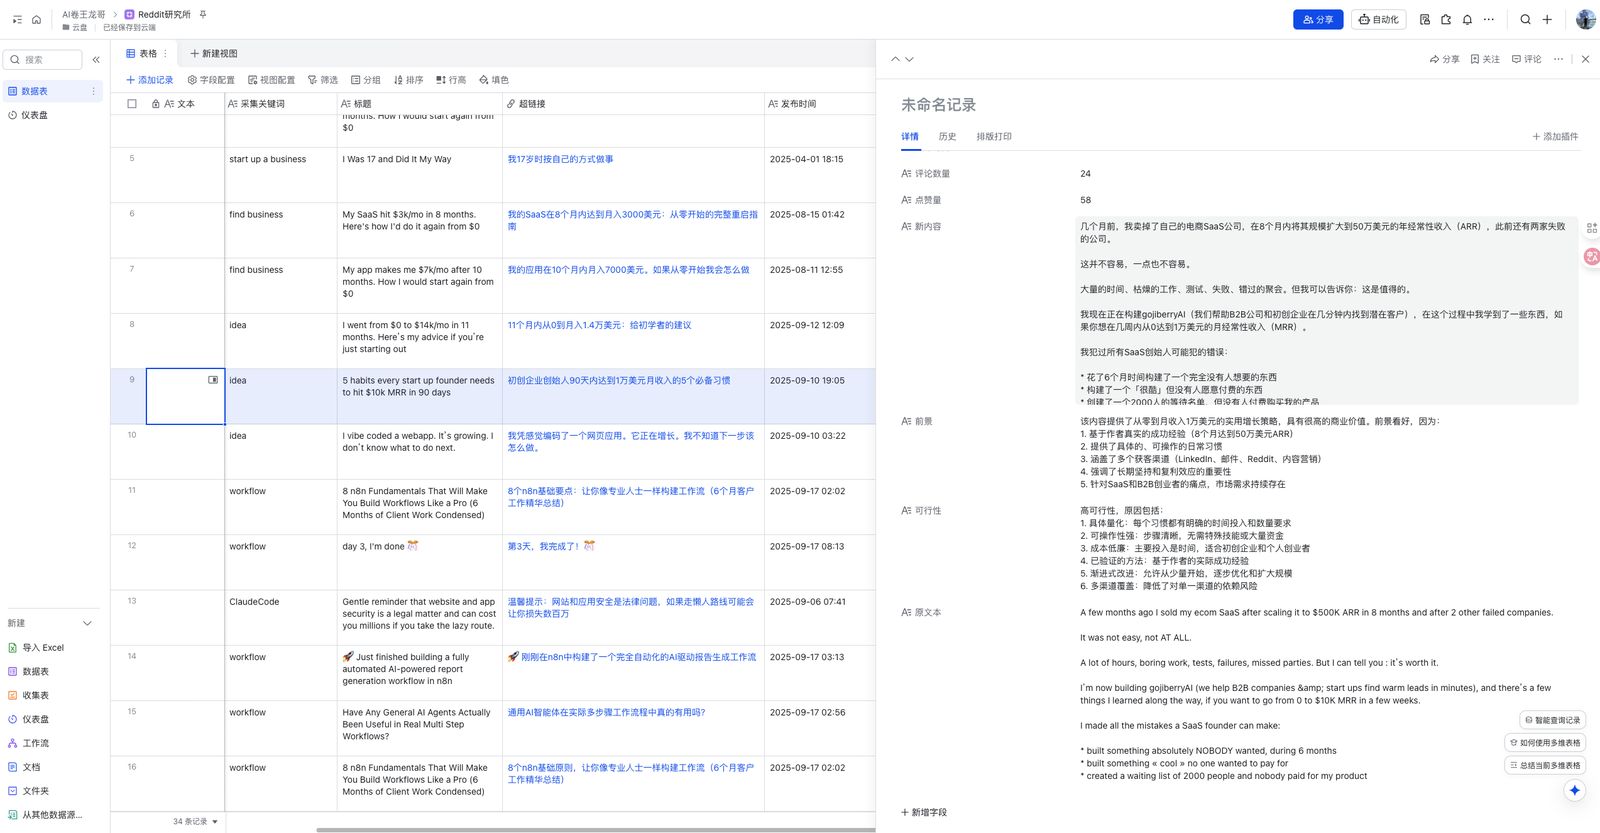
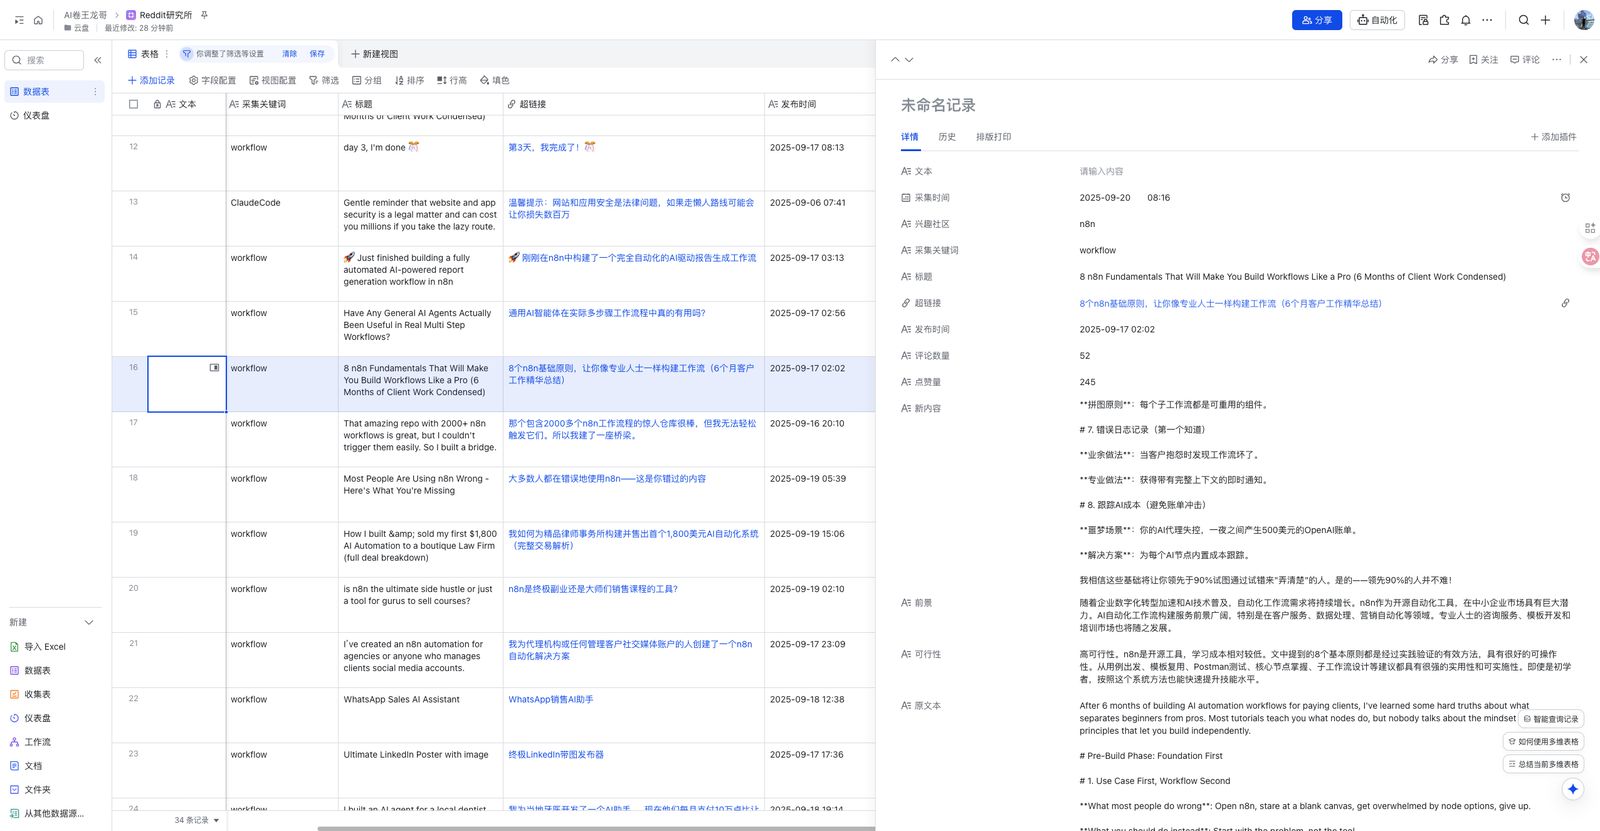
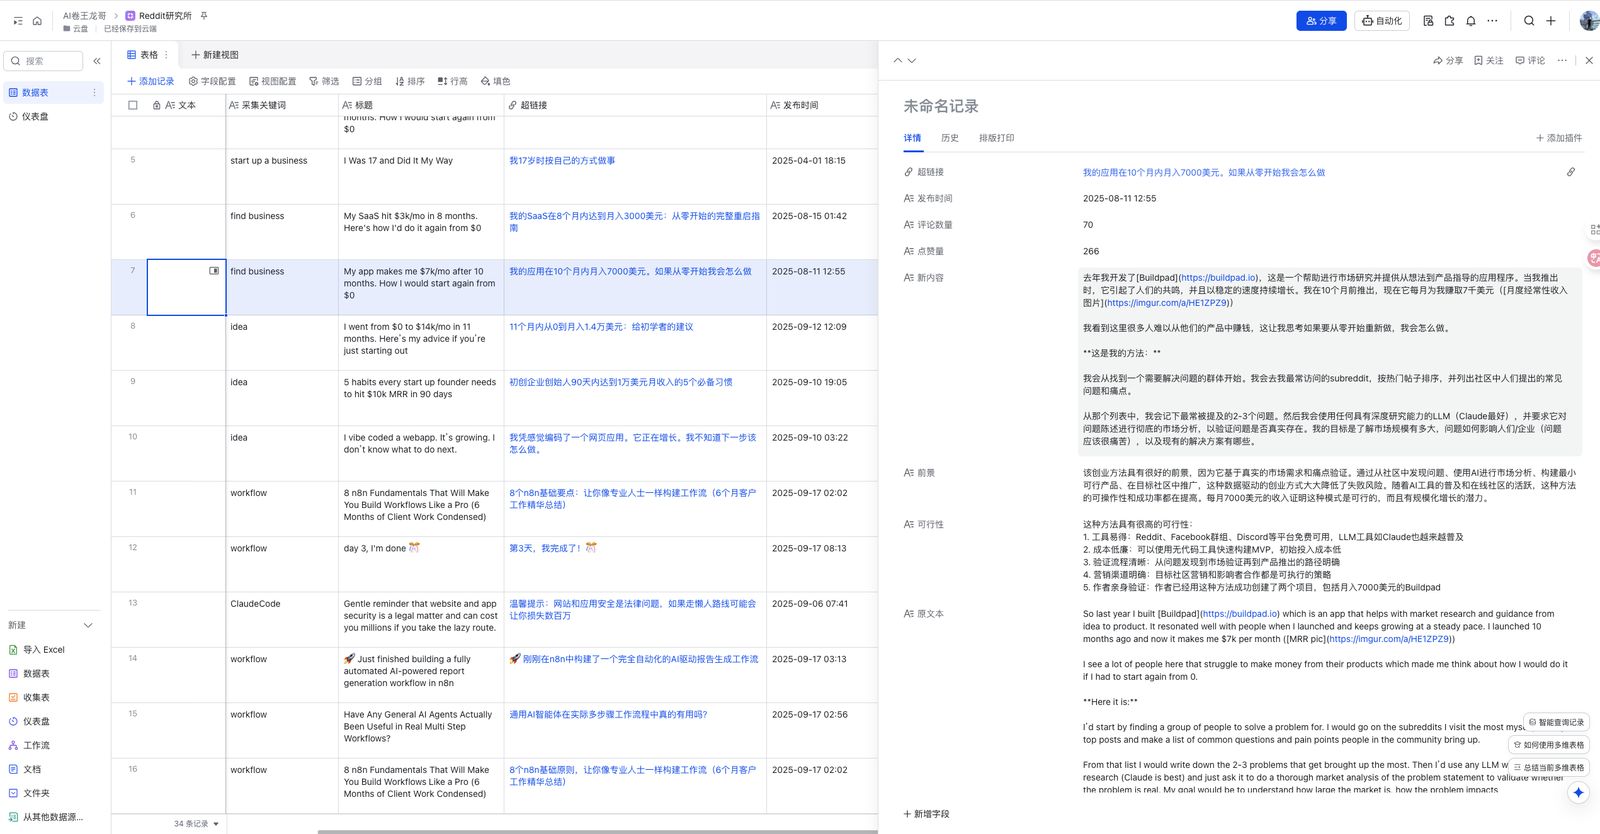
效果展示
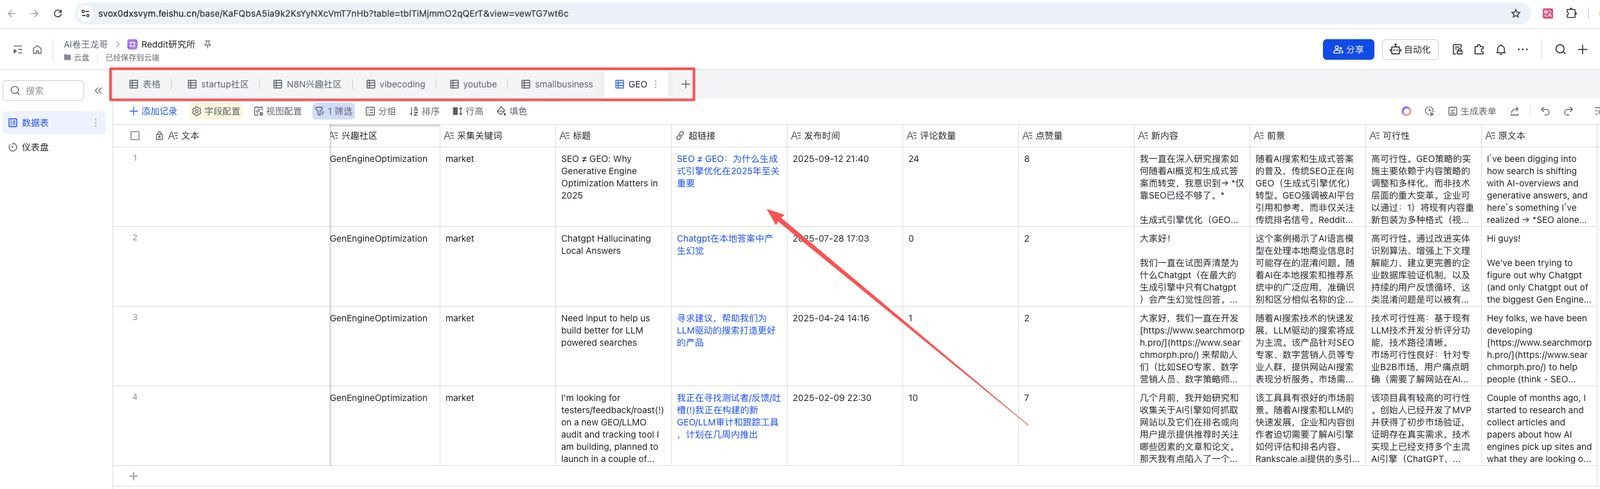
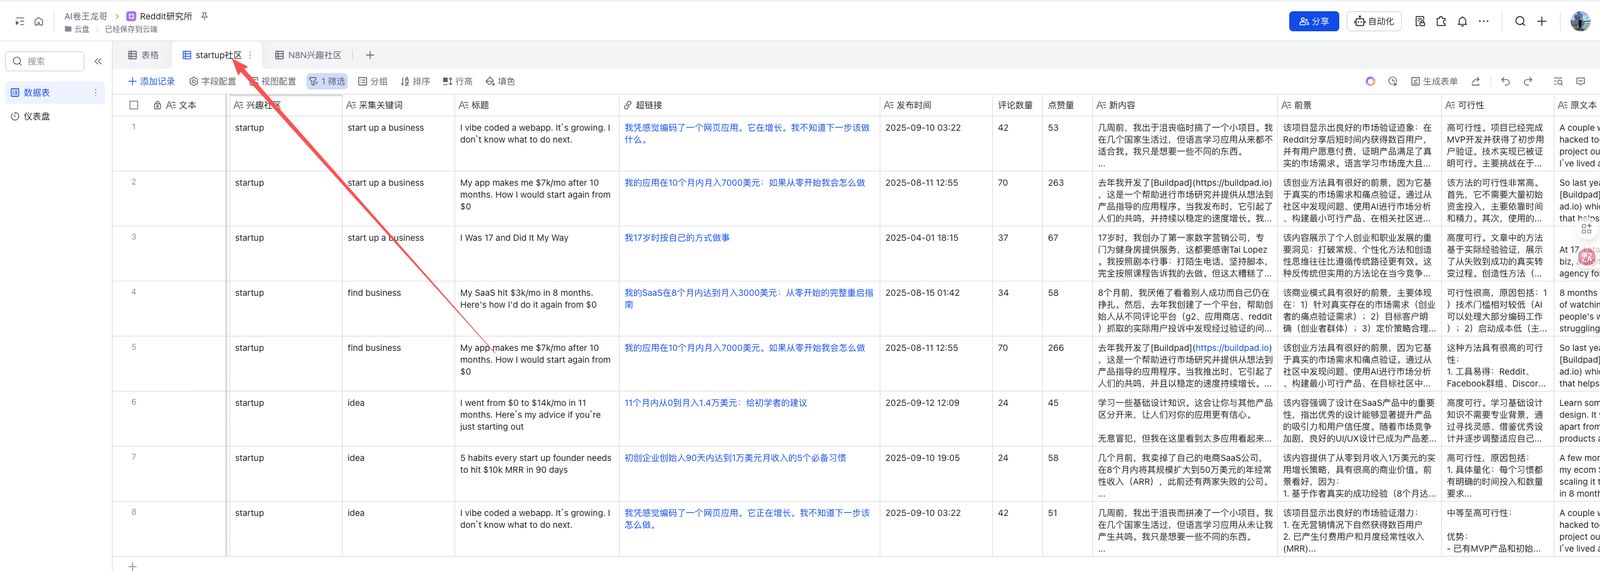
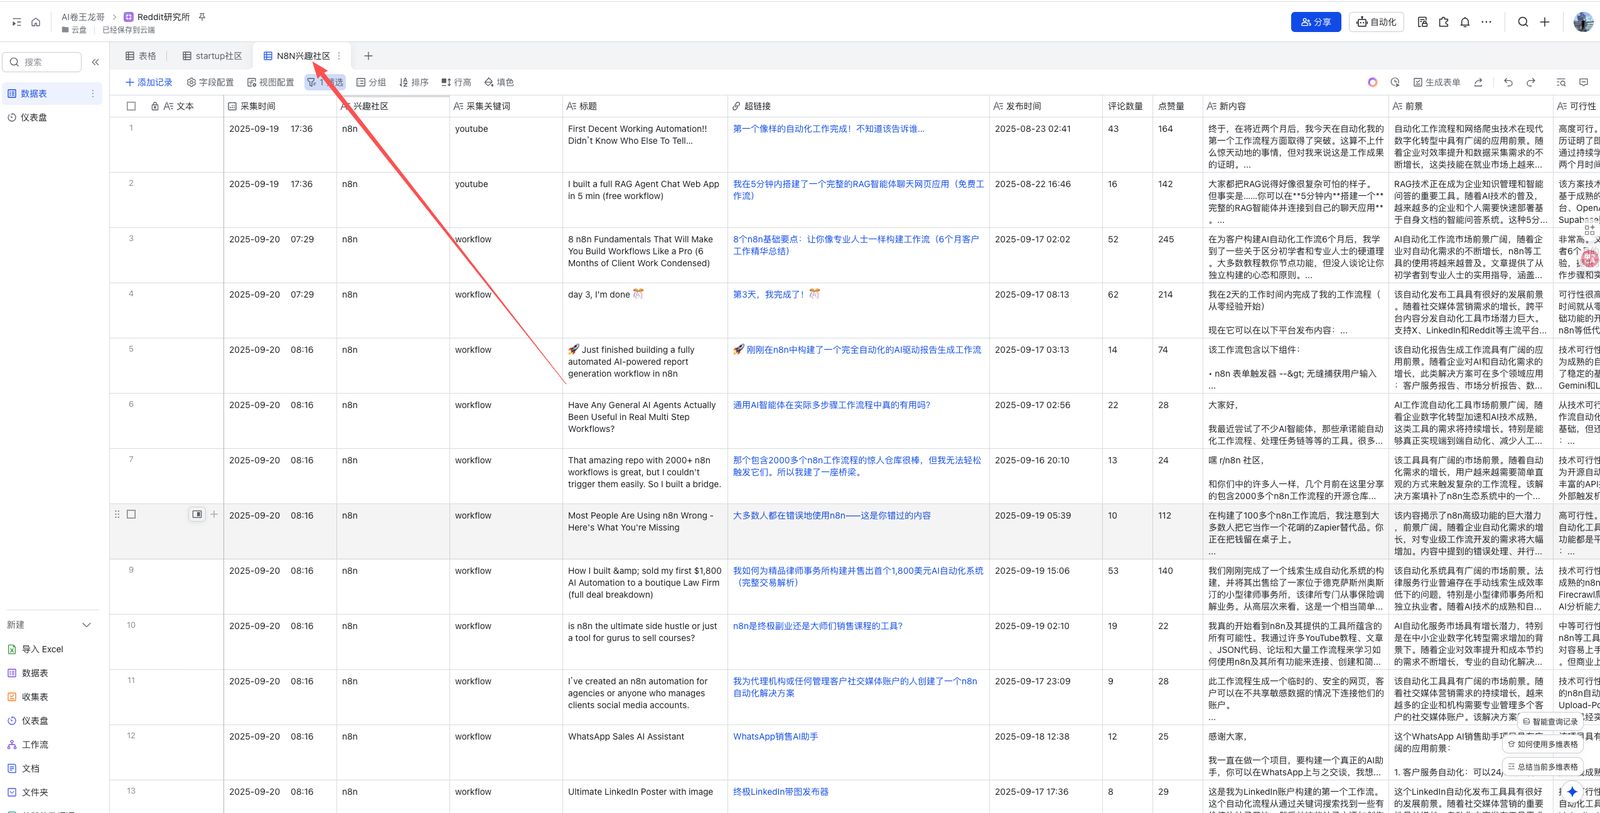
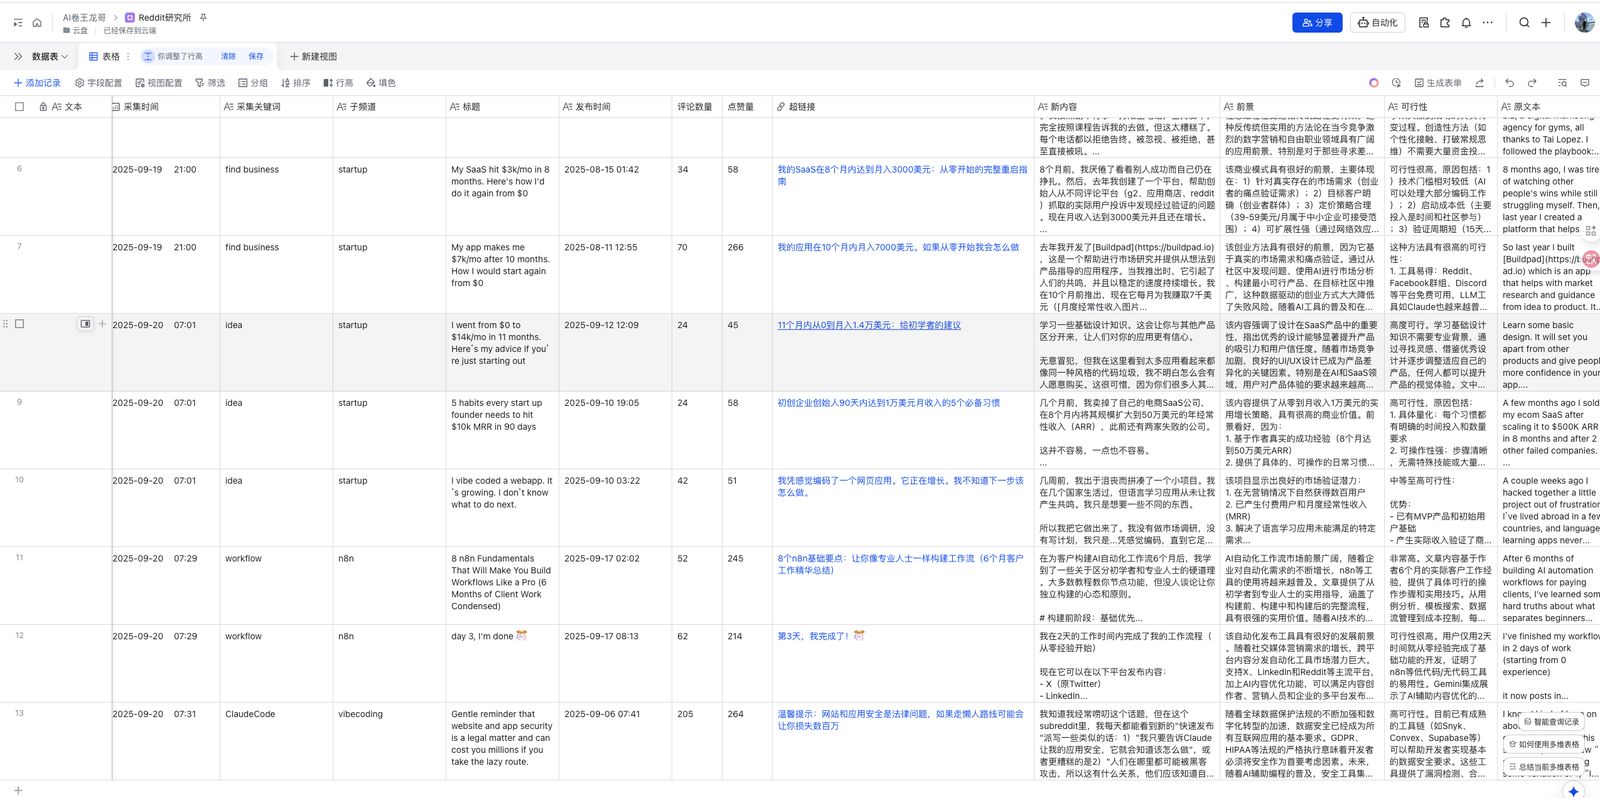
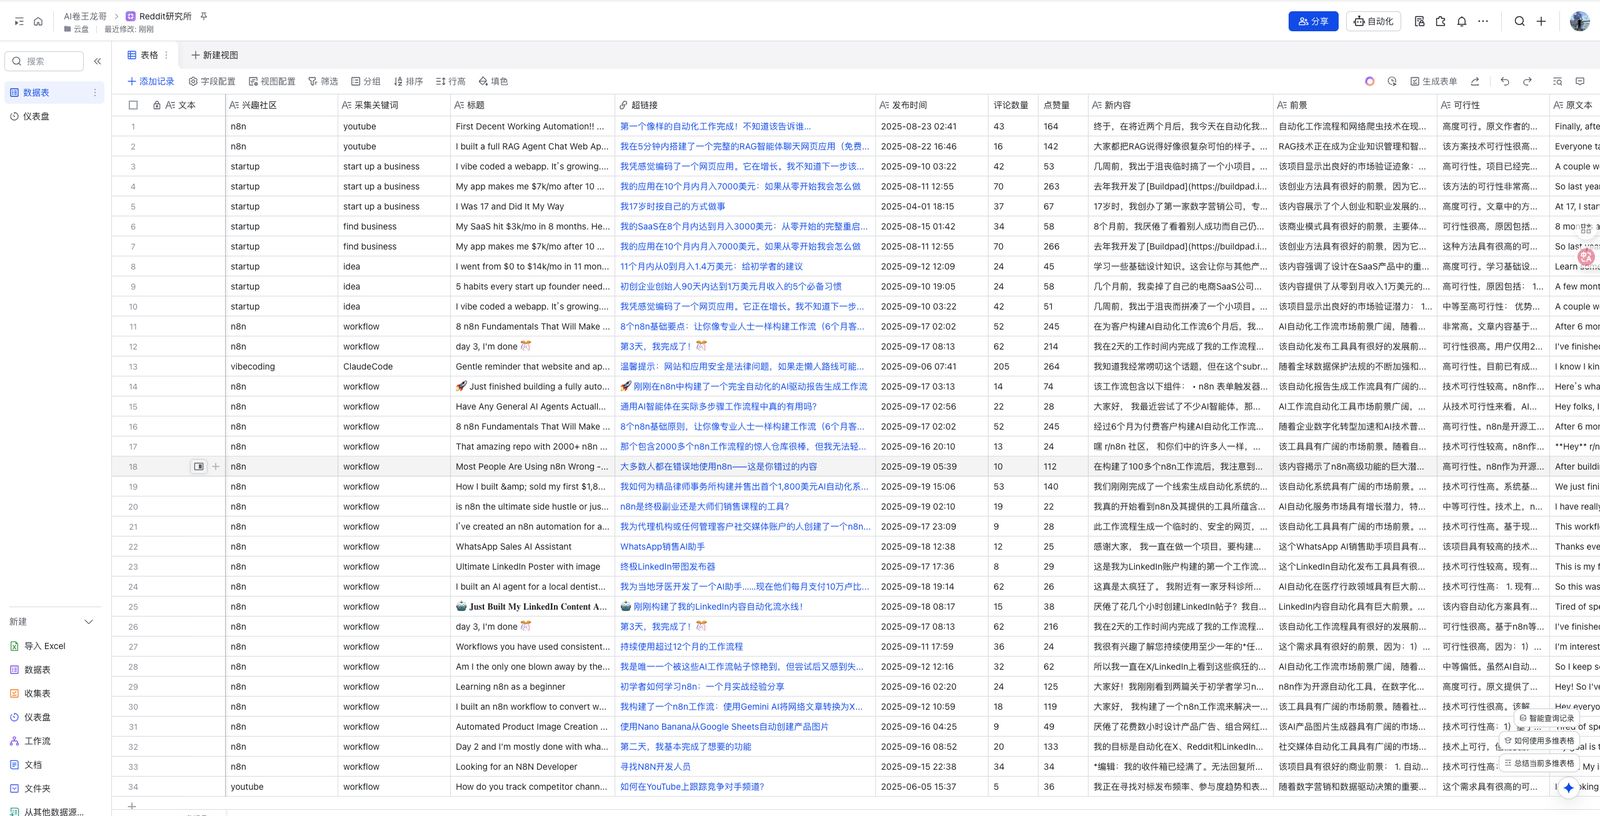
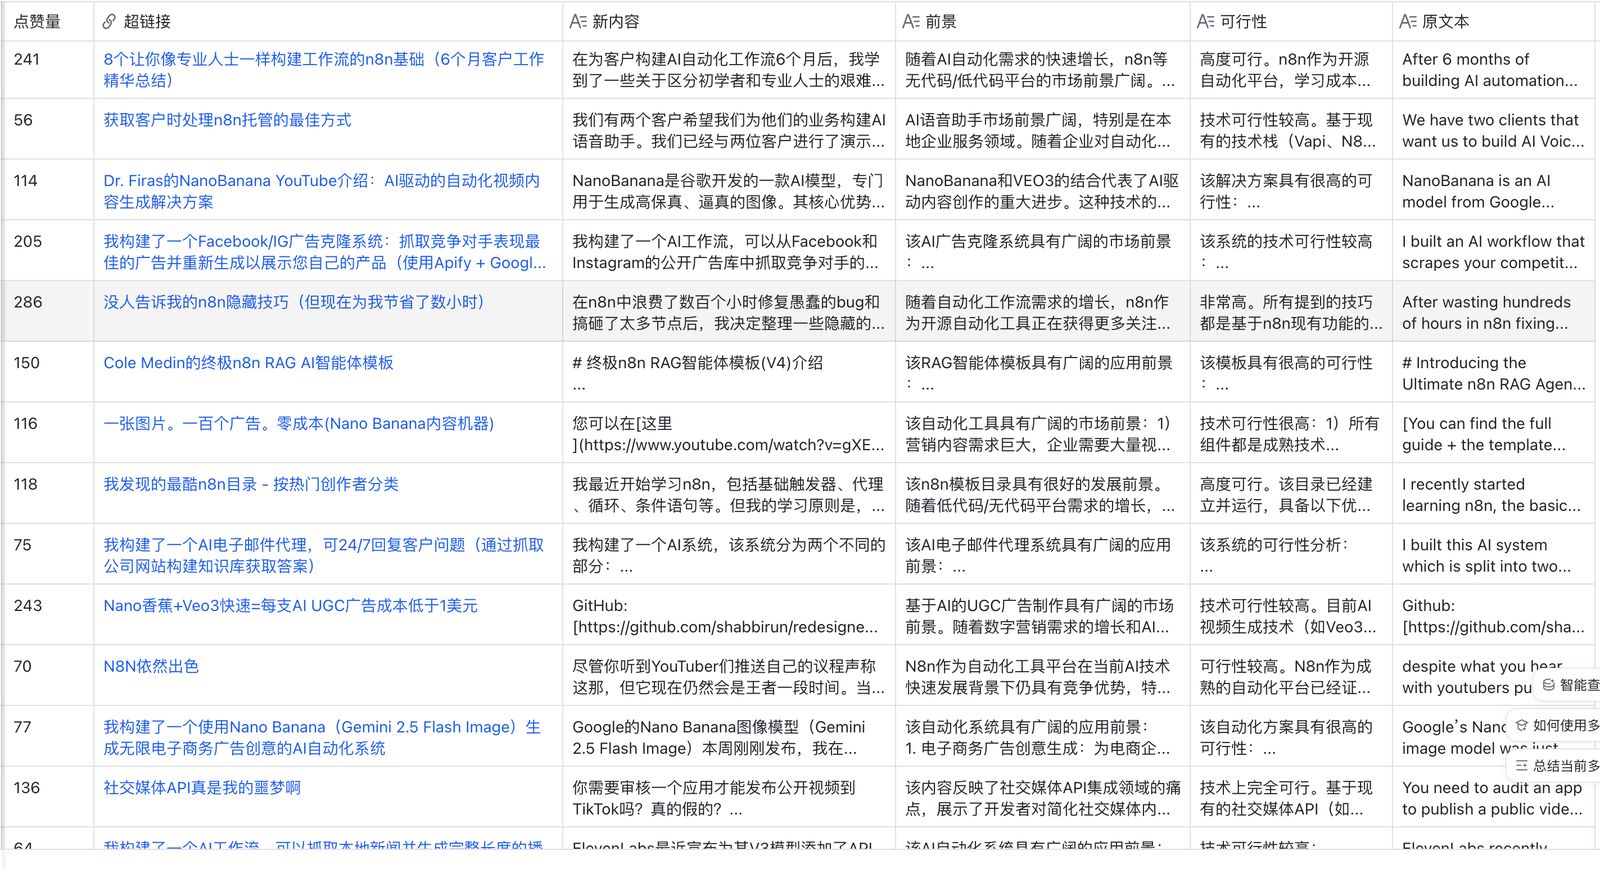
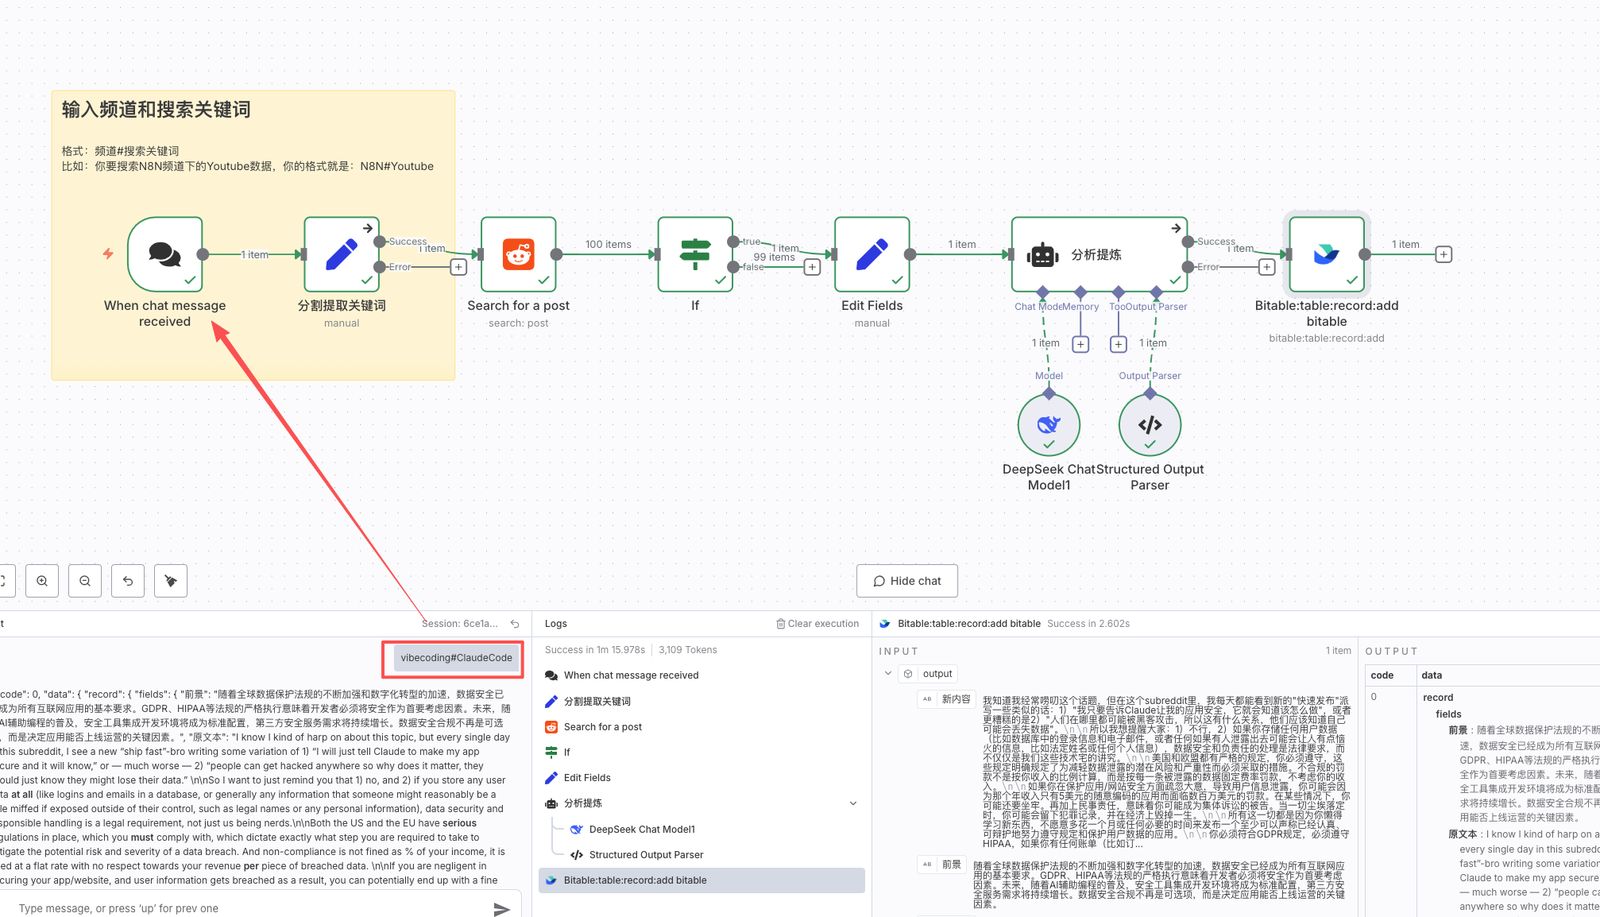
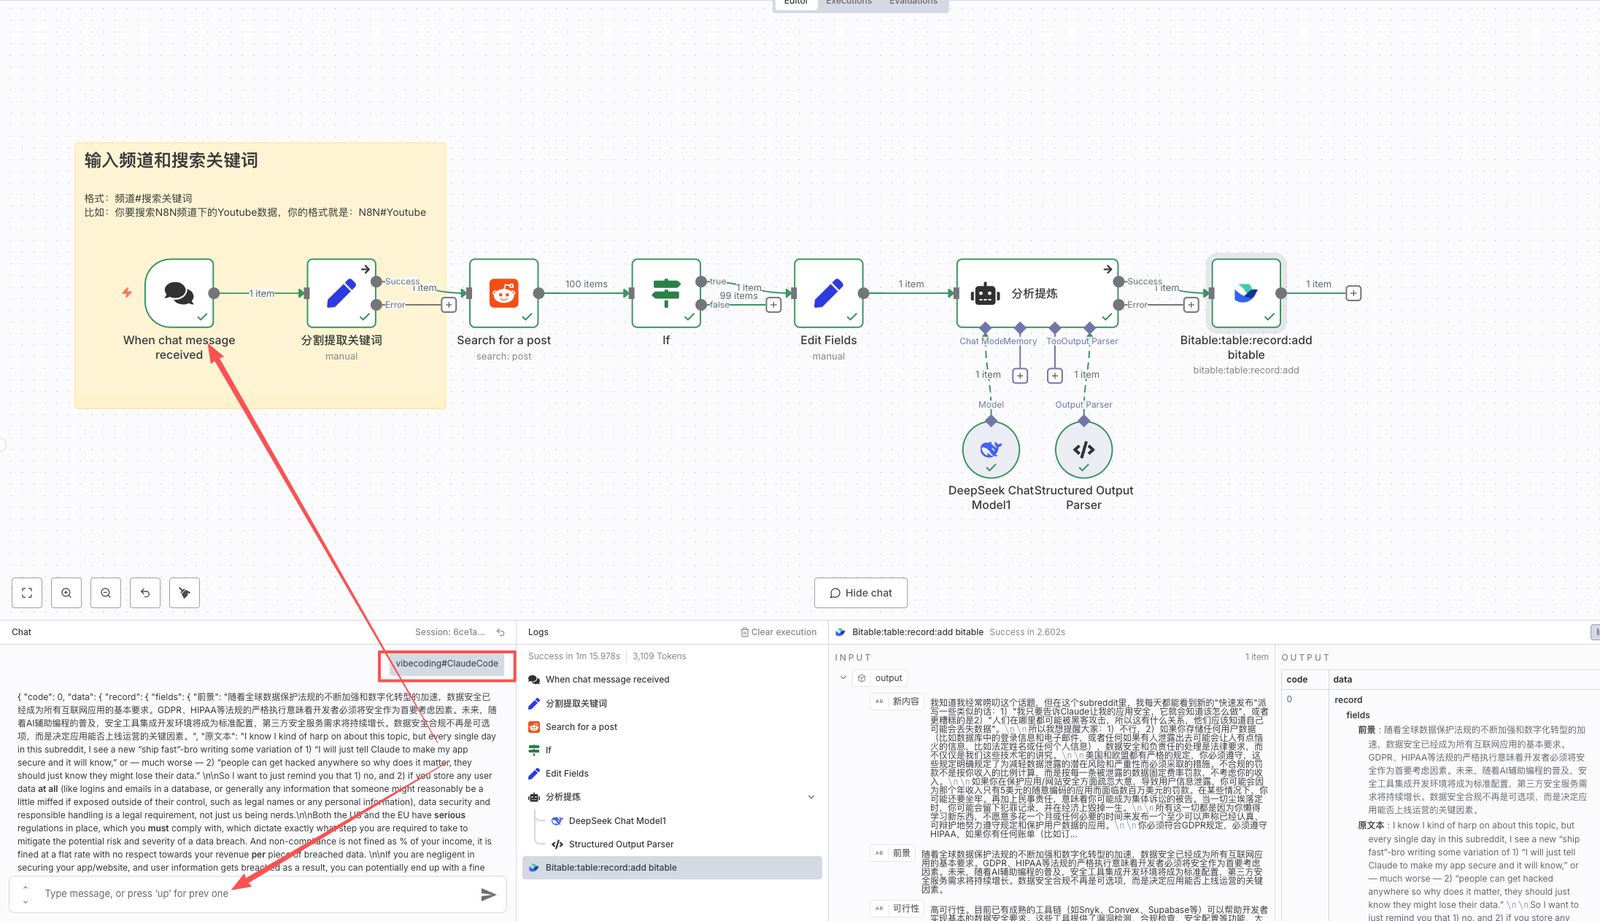
工作流结构如下
工作流搭建步骤
节点:对话启动
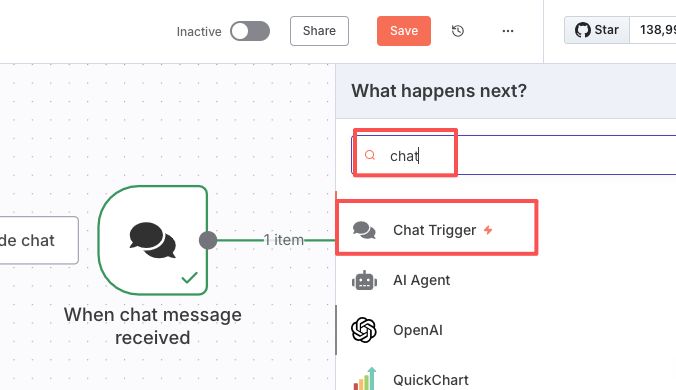
点击➕号,弹出节点搜索框,输入chat,点击红框中的触发器
节点:获取关键词
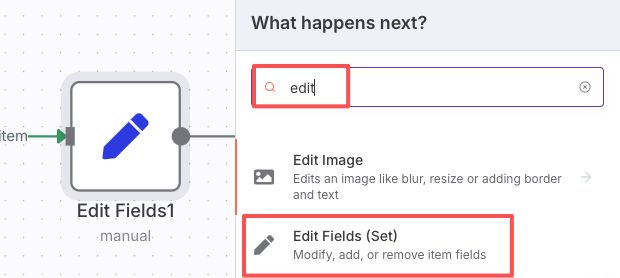
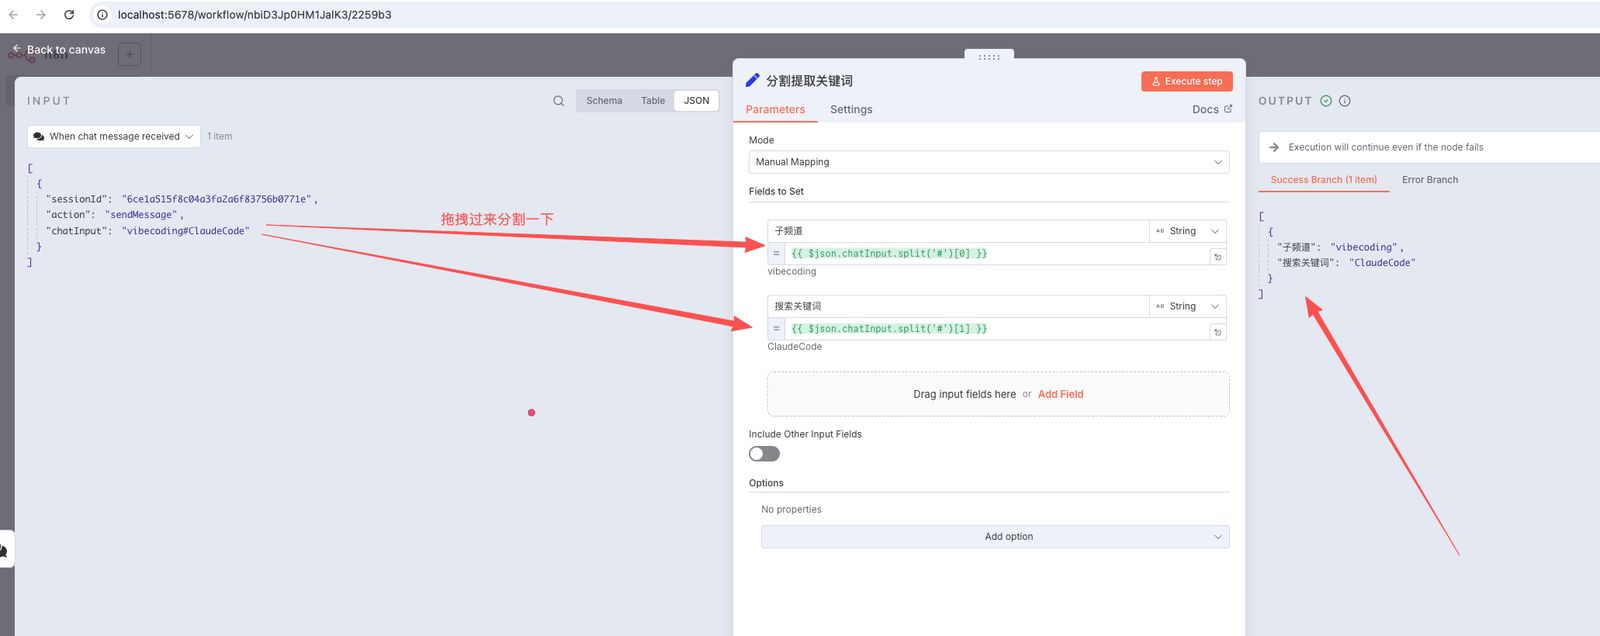
点击➕号,弹出节点搜索框,输入edit,选中红框控件
节点:搜索Reddit平道关键词
添加Reddit节点
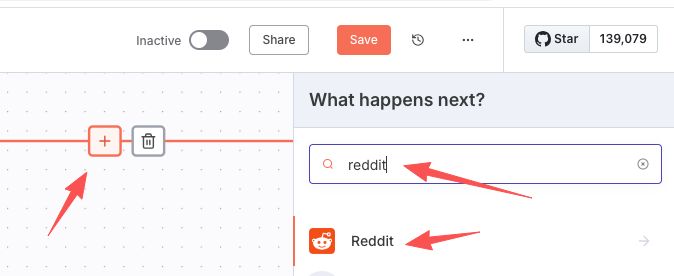
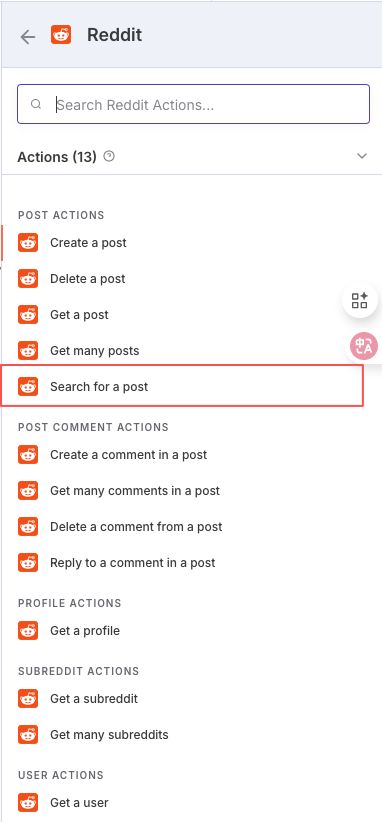
点击➕号,弹出节点搜索框,输入reddit,选中红框控件
选中 Search for a post
配置Reddit数据
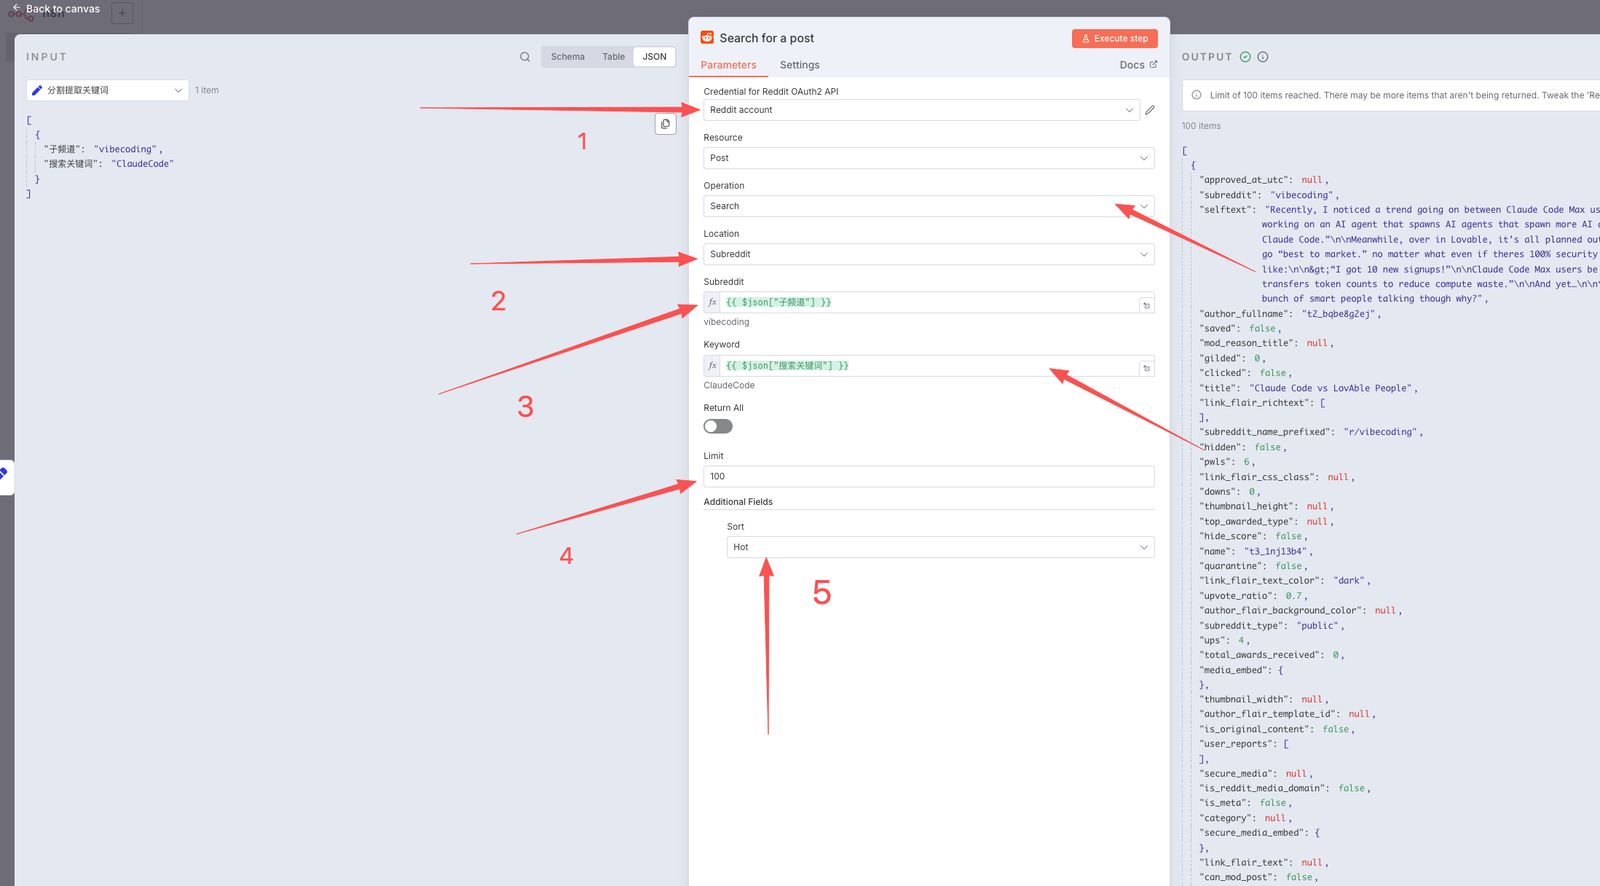
看我标记的解释:
配置证书,下面有介绍方法
选择频道,全频道还是子频道,我这里选的是子频道
频道名是startup
限制100条数据
排序按热点
搜索关键词
操作类型是搜索
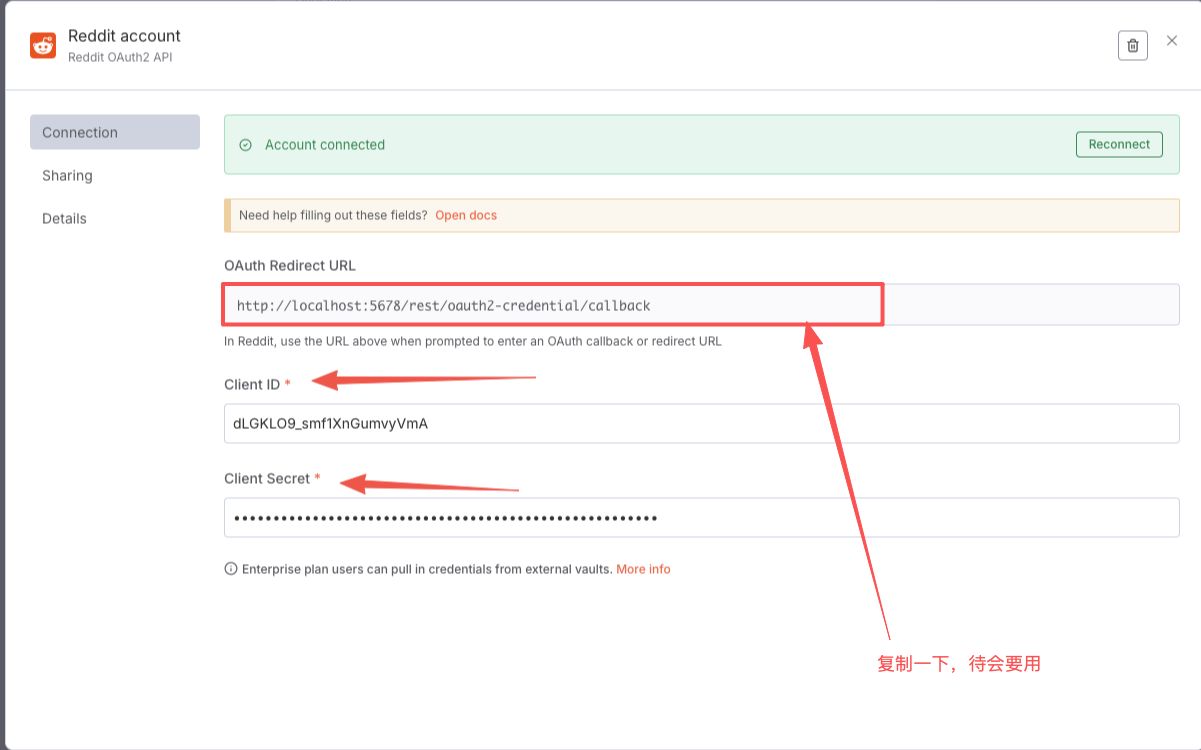
添加Reddit证书
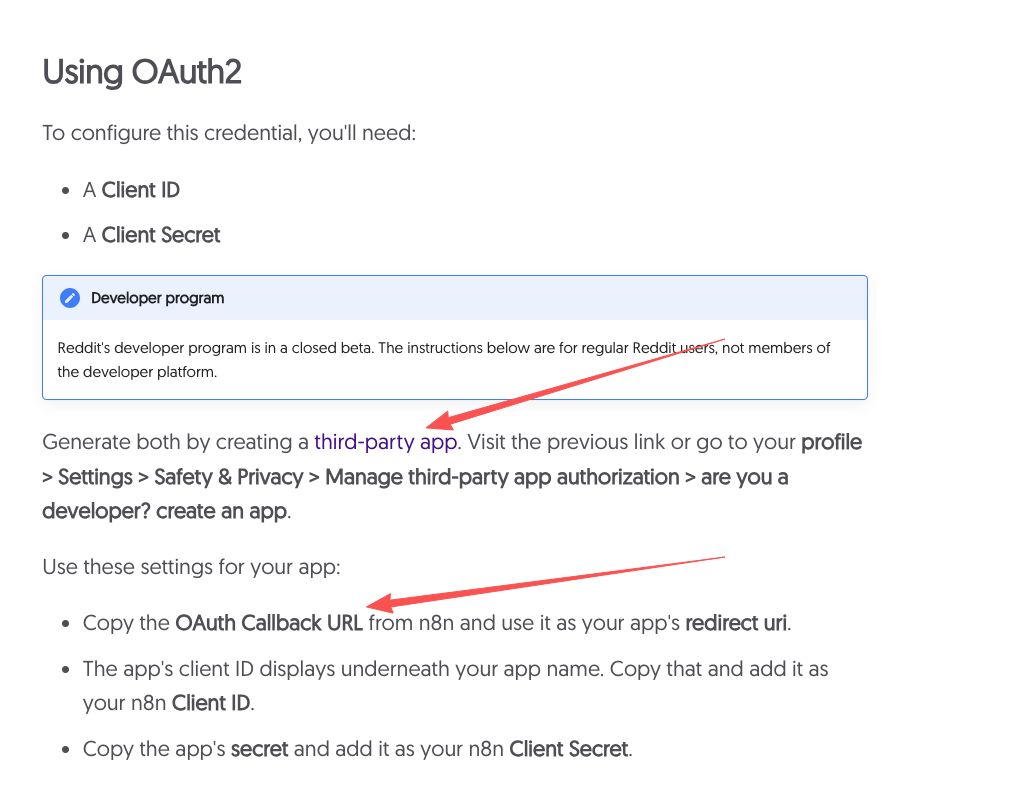
如何获取Client ID和Client Sercret
打开网站:
https://docs.n8n.io/integrations/builtin/credentials/reddit/?utm_campaign=create_new_credentials_modal&utm_medium=credential_settings&utm_source=n8n_app
搜索:Generate both by creating a third-party app.
点击蓝色的third-part app,进入信息也
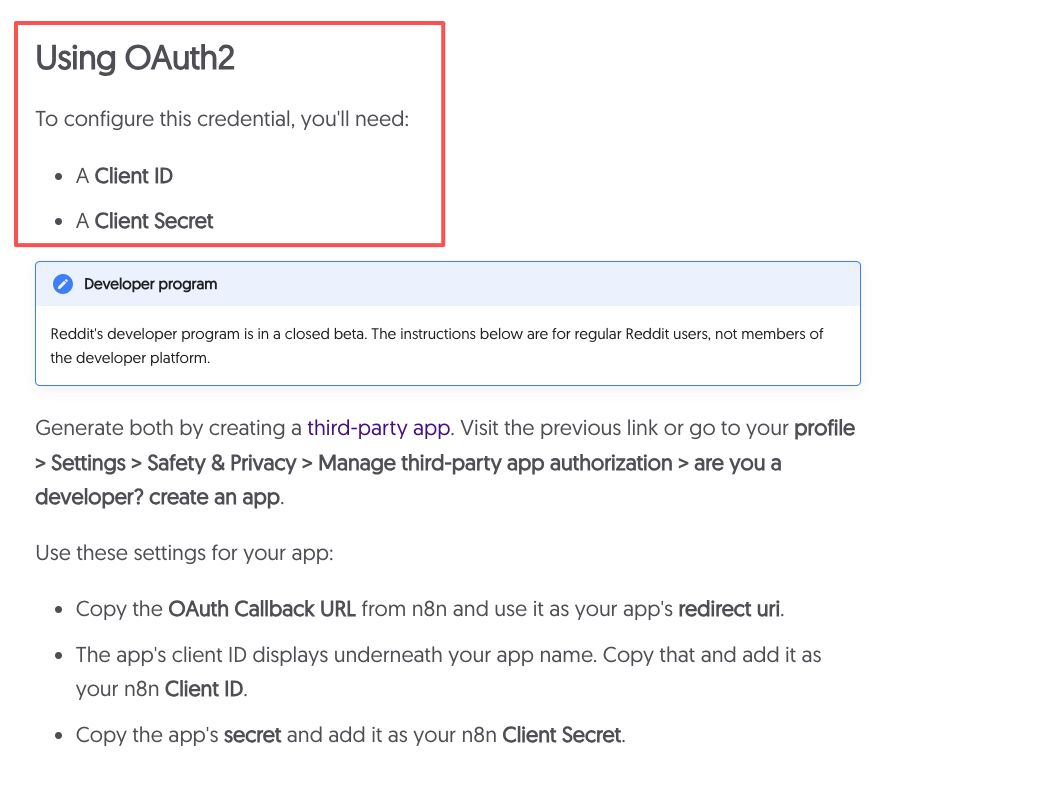
点击 third-party app. 进入新网页
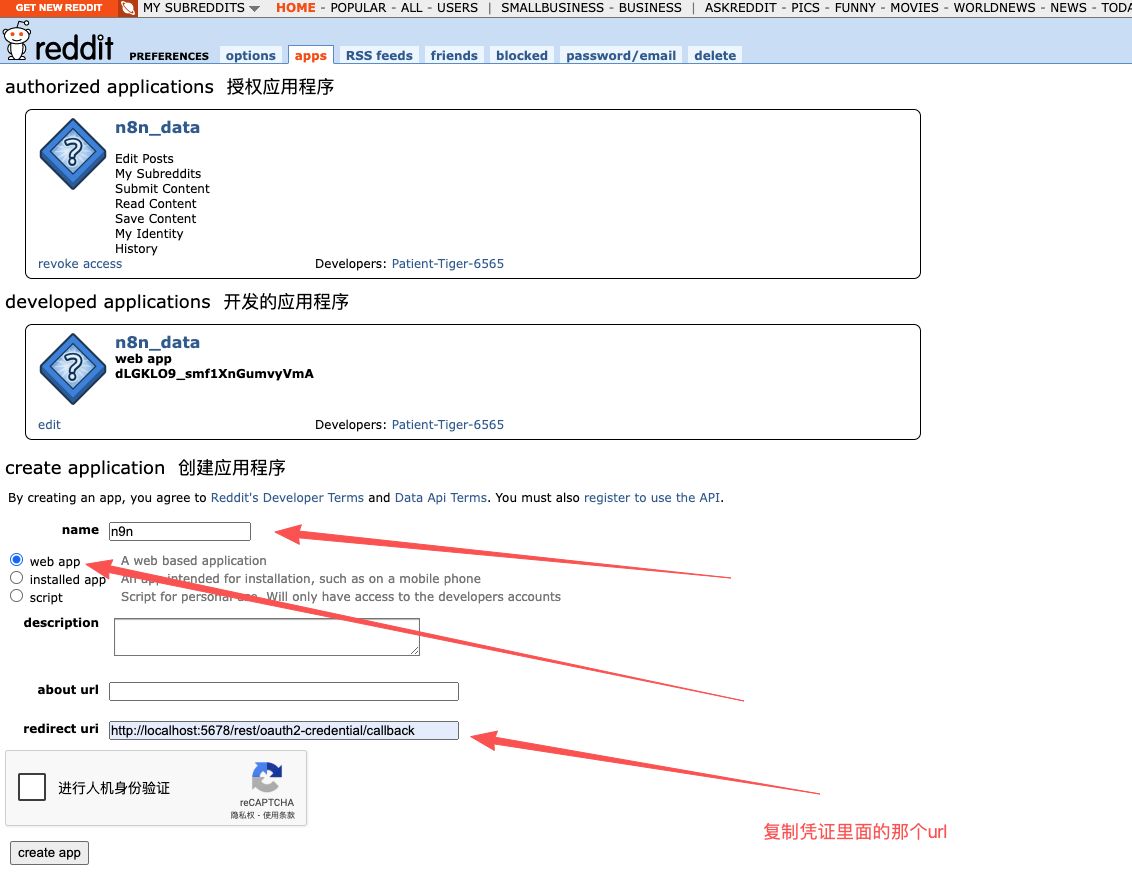
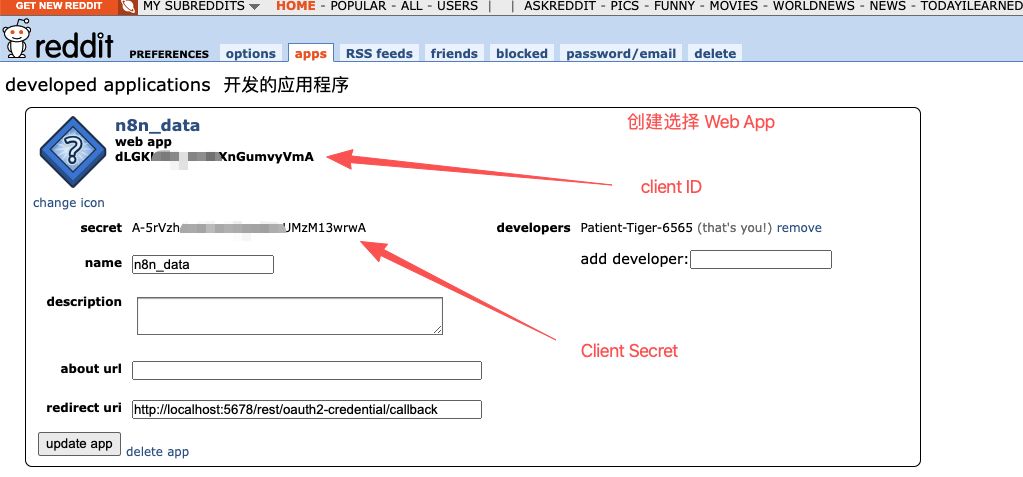
获取你的 Client ID和Client Secret,填入到凭证中就可以了
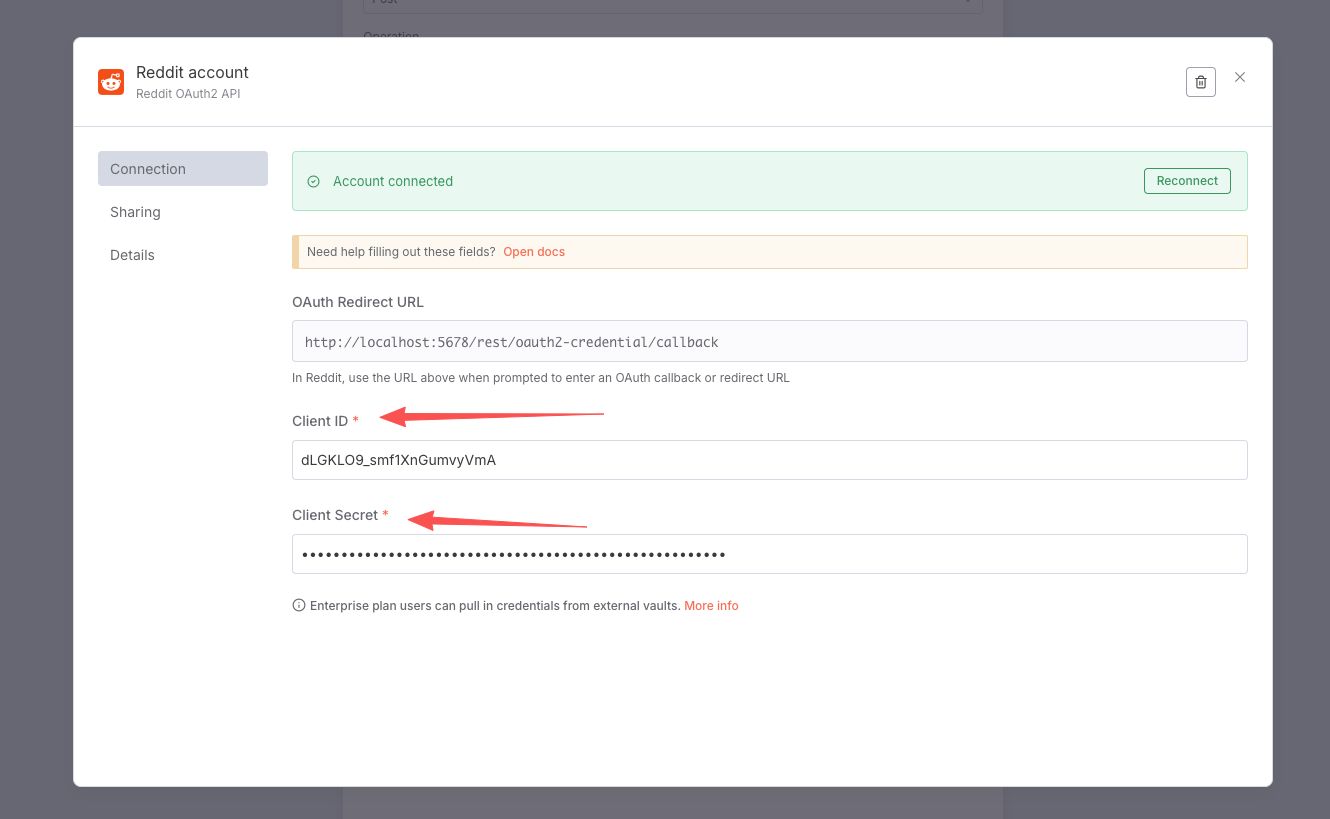
配置好证书
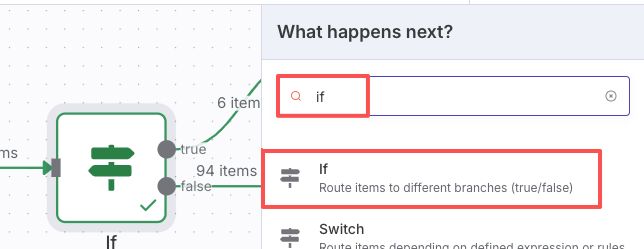
节点:if 筛选
点击➕号,弹出节点搜索框,输入if
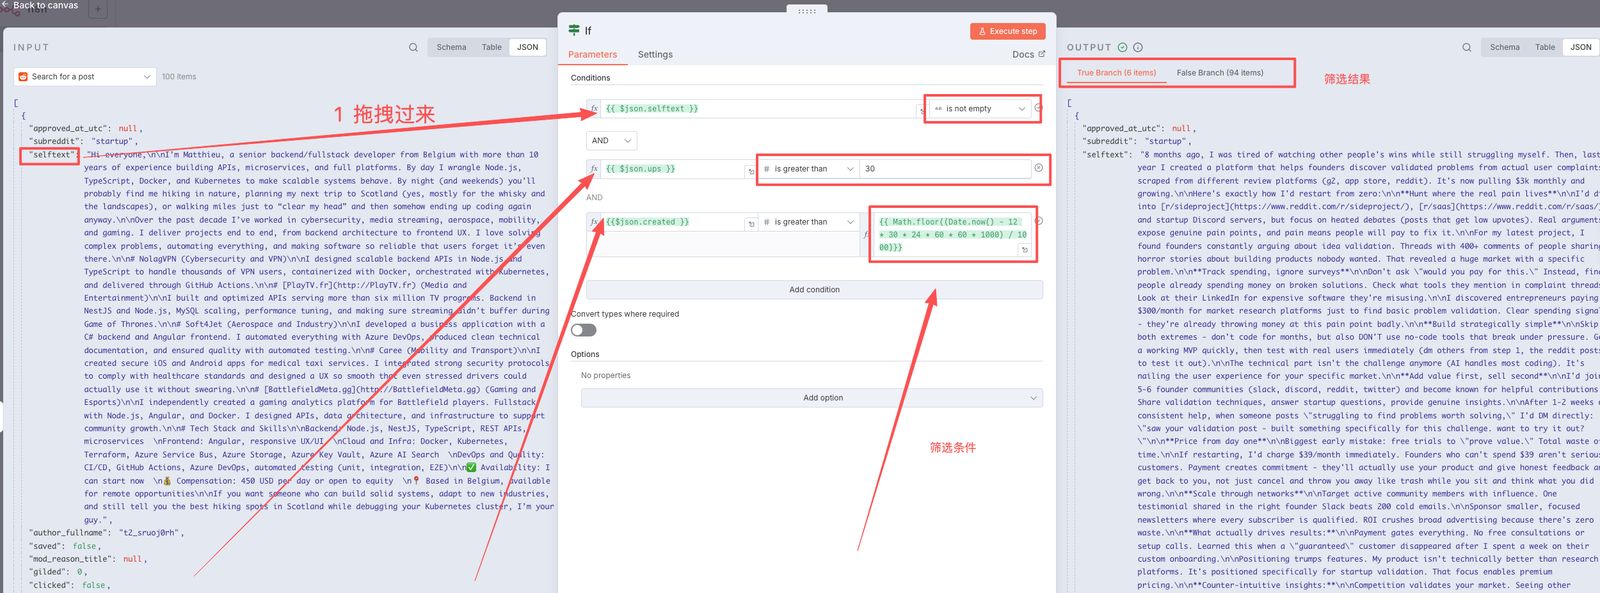
筛选文本不为空的内容
筛选30以上个赞的内容
筛选最近12个月的内容
节点:提炼数据
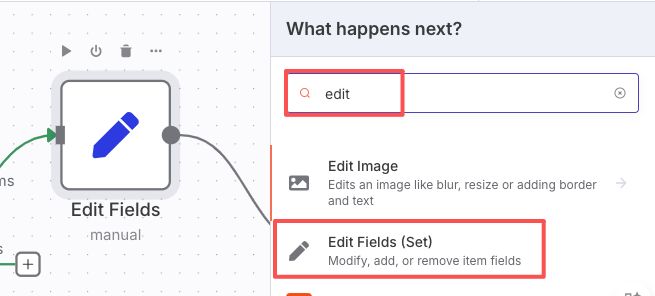
点击➕号,弹出节点搜索框,输入edit
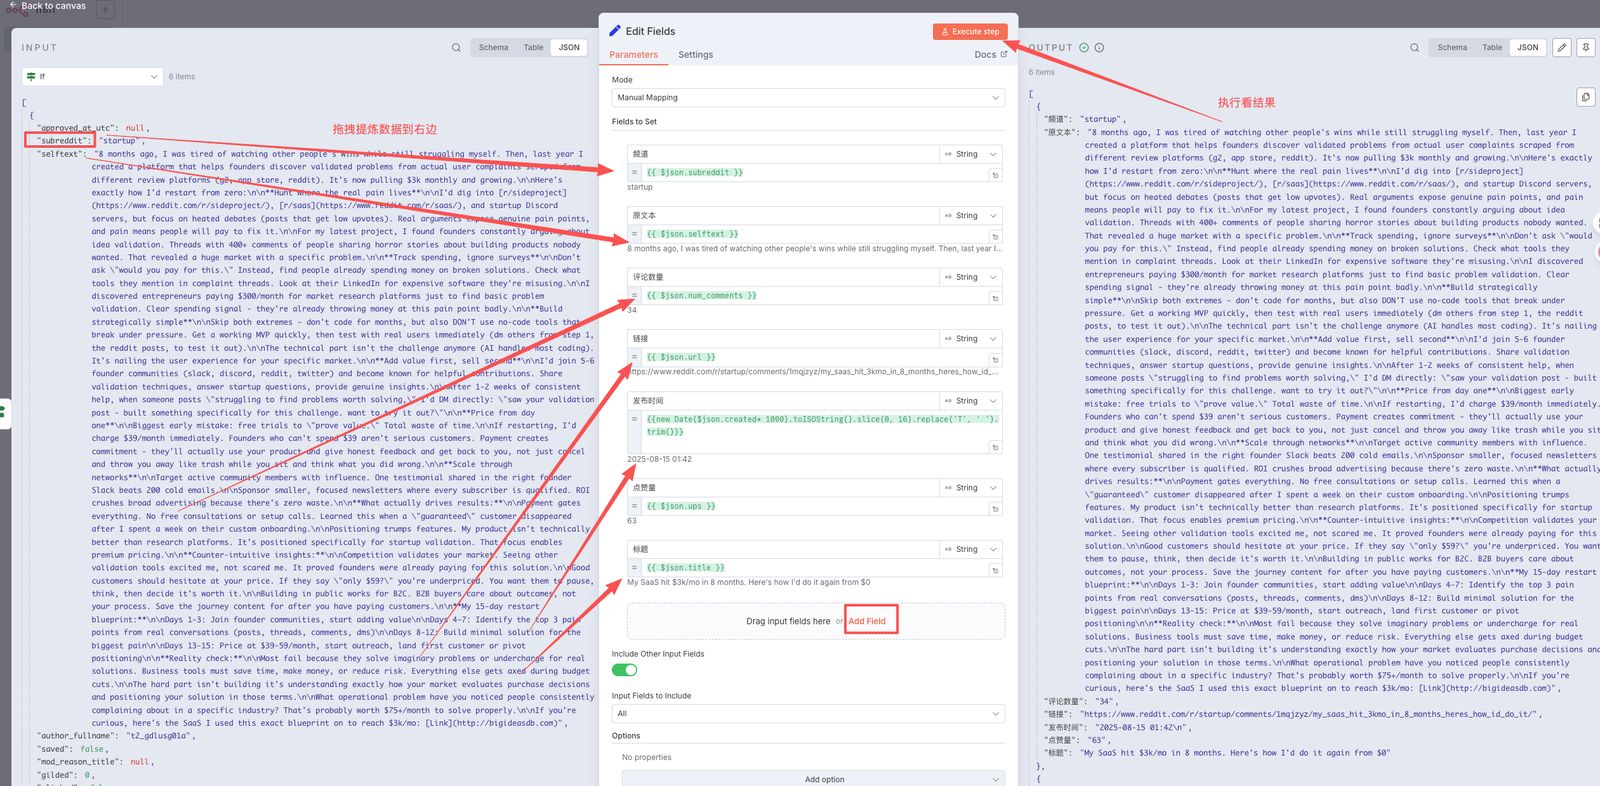
提炼数据
节点:分析提炼
添加AI节点
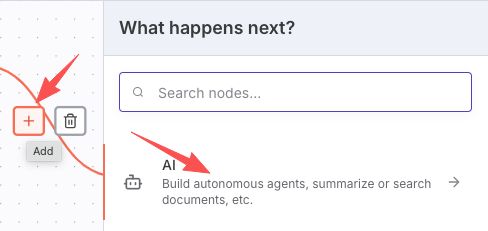
点击➕号,点击AI控件
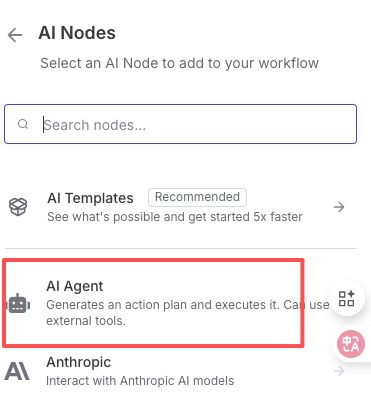
点击AI Agent
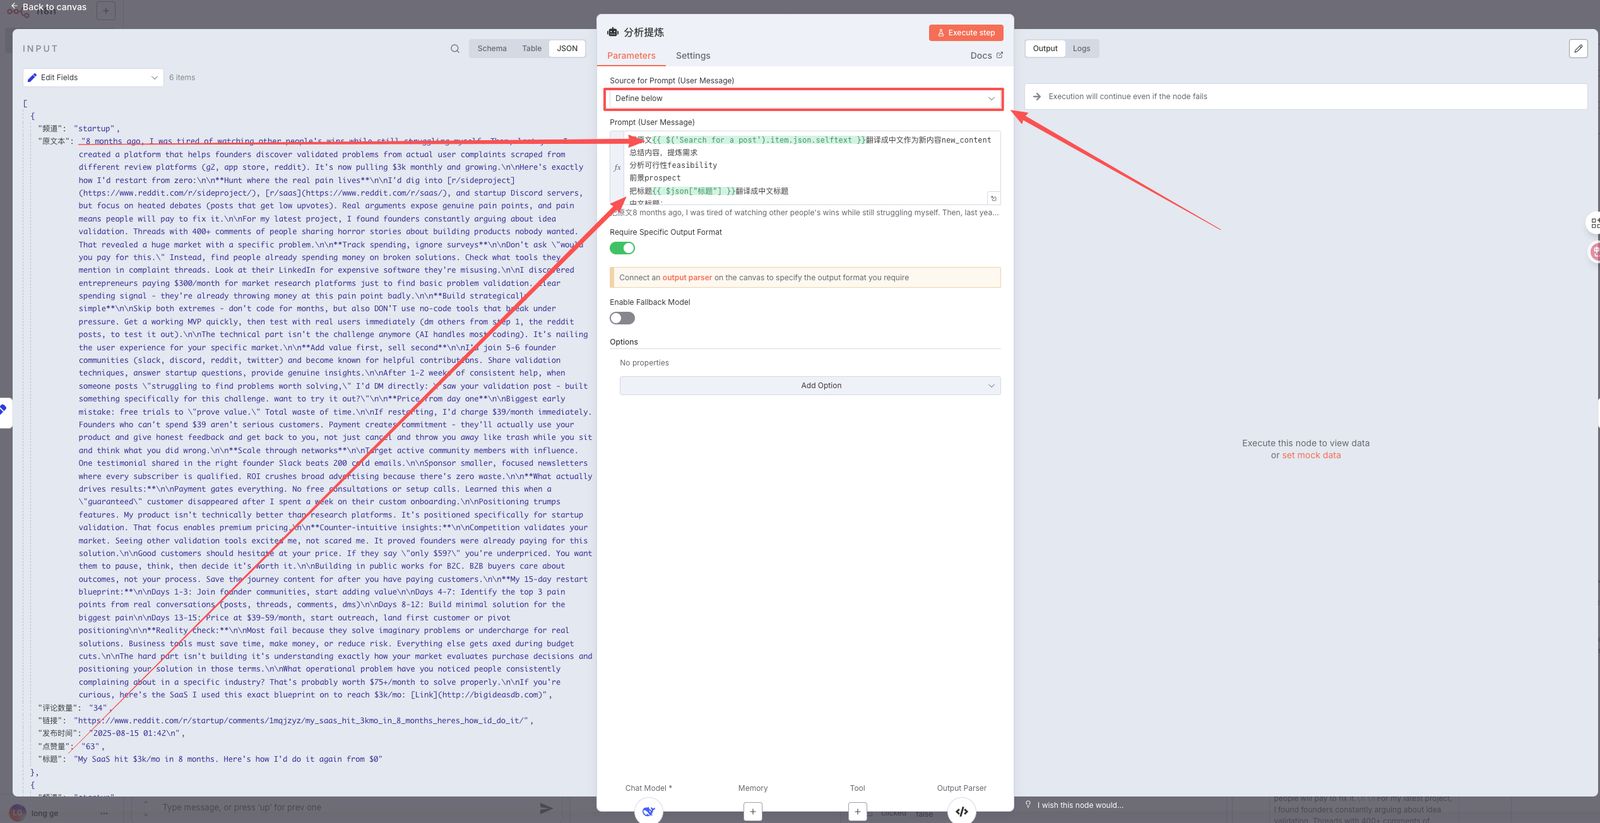
拖拽数据到里面
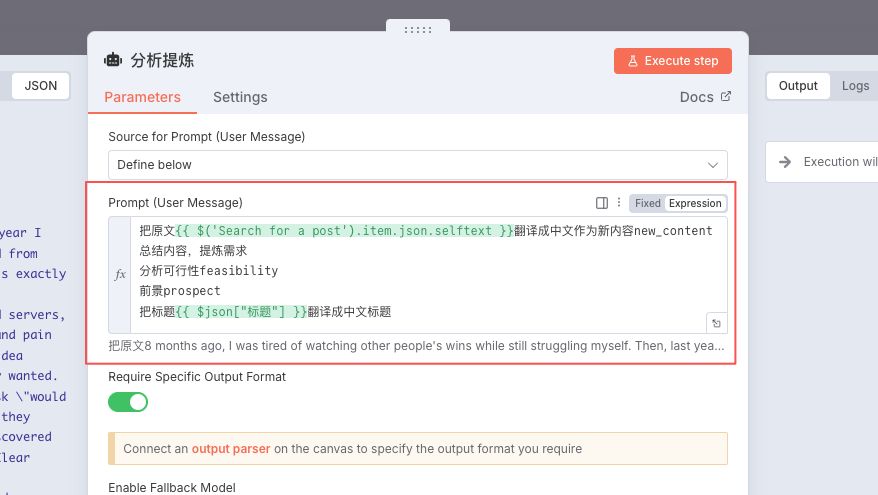
提示词
把原文{{ $(‘Search for a post’).item.json.selftext }}翻译成中文作为新内容new_content
总结内容,提炼需求
分析可行性feasibility
前景prospect
把标题{{ $json["标题"] }}翻译成中文标题
添加大模型
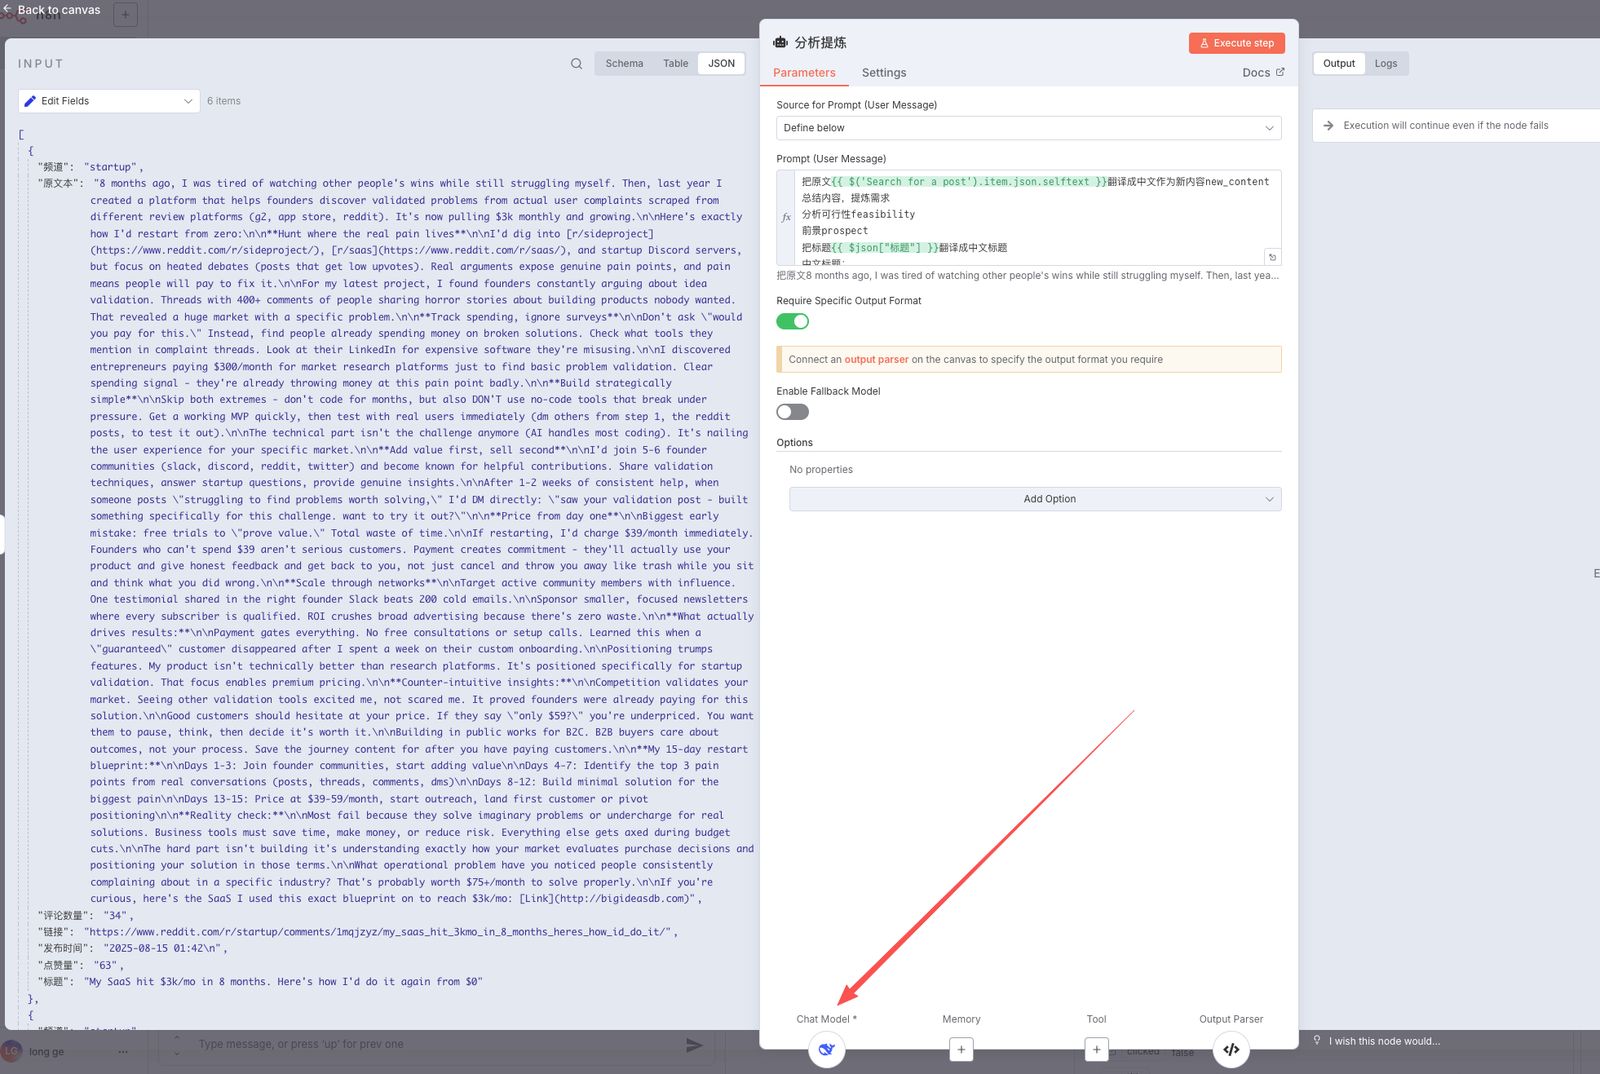
添加大模型参考: 我这里用的是DeepSeek,可以自由选择
输出数据解析
打开开关 Require Specific Output Format
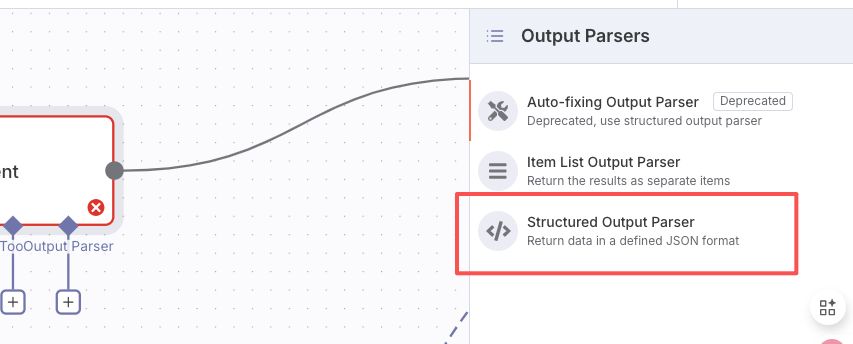
点击Output Parser
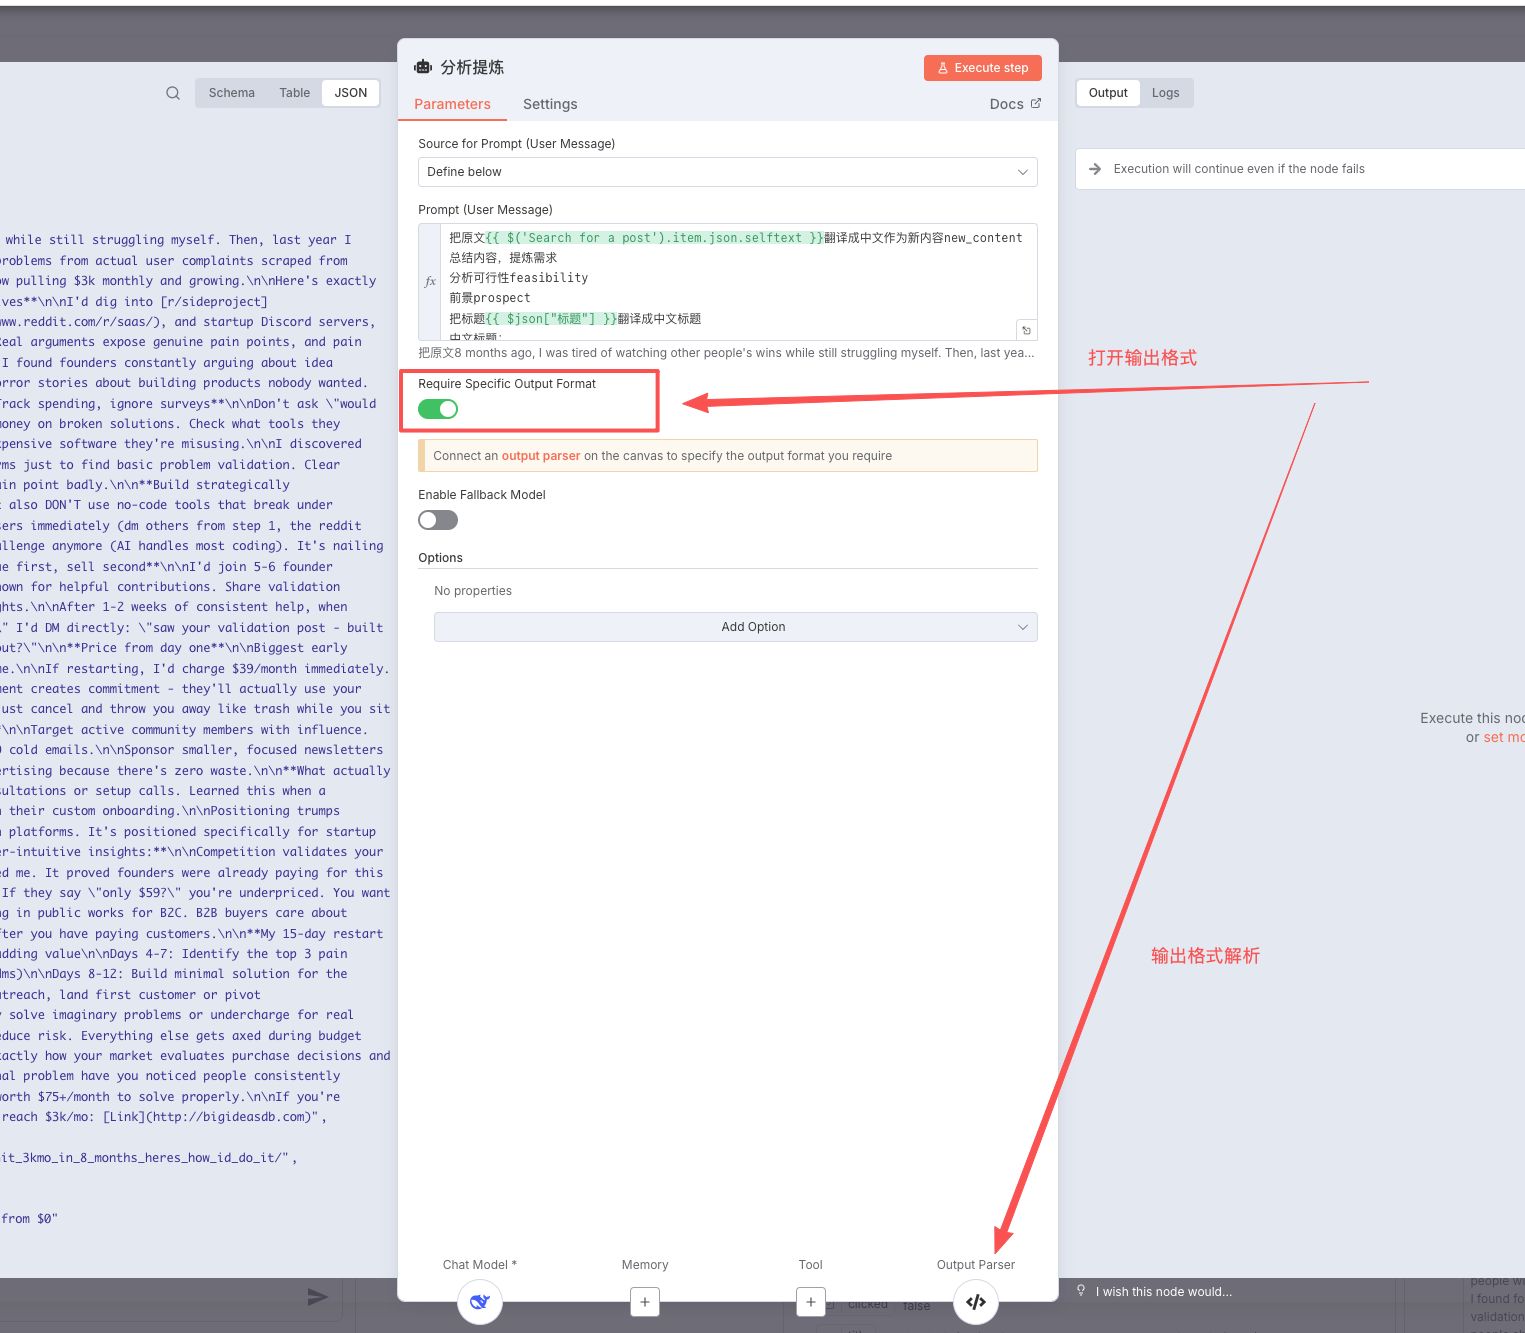
如图选择
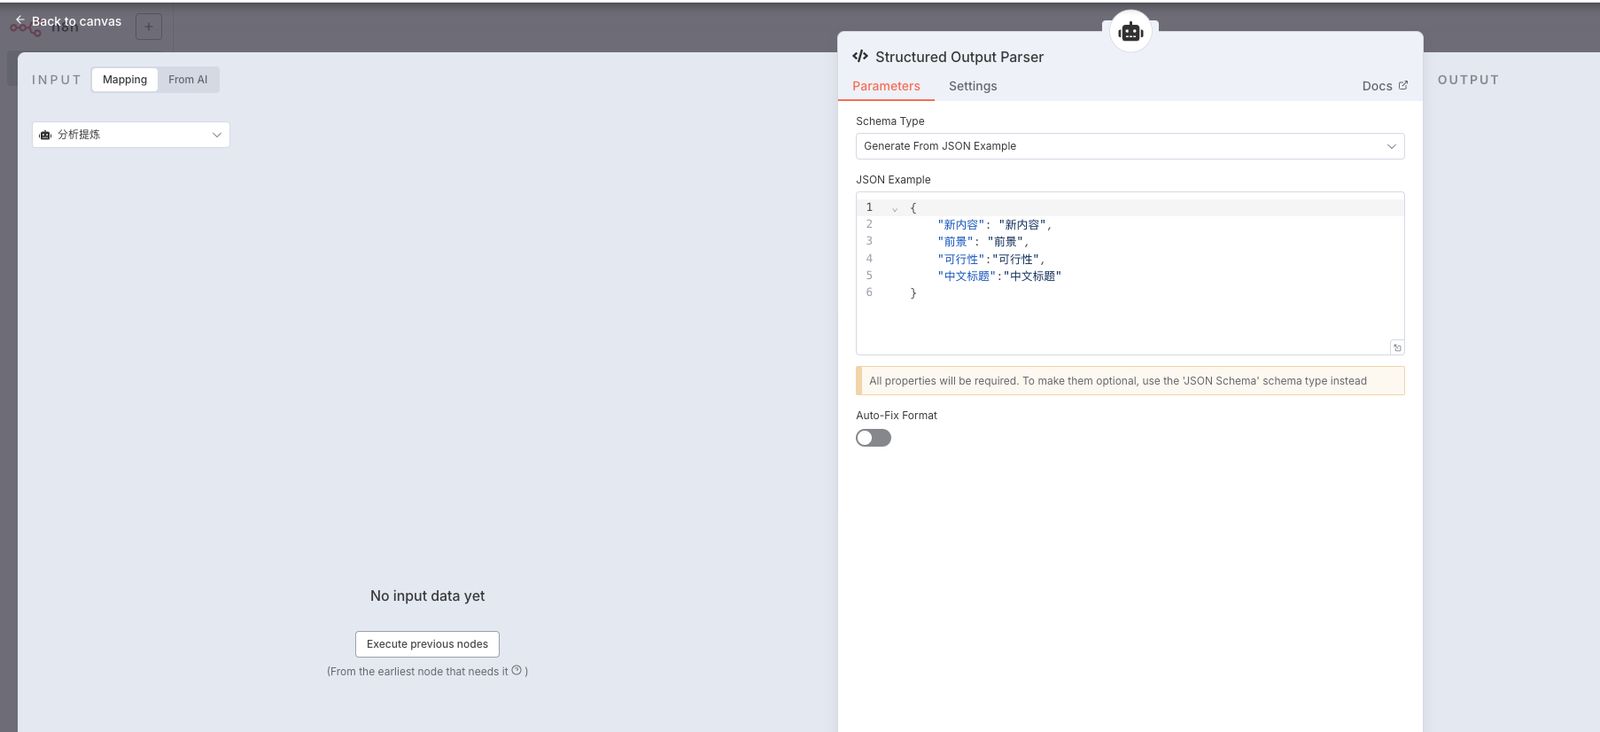
输出内容指定,需要配合我的提示词。
把原文{{ $(‘Search for a post’).item.json.selftext }}翻译成中文作为新内容new_content
总结内容,提炼需求
分析可行性feasibility
前景prospect
把标题{{ $json["标题"] }}翻译成中文标题
节点:飞书添加记录
说明:
你需要确认你的N8N是本地部署或者自建服务器部署的,网页版N8N不支持安装社区节点
在做本操作前,你需要确认,你的飞书社区节点已经安装,如果没有安装请先安装飞书社区节点。
N8N安装飞书节点
(如果你已经安装过,直接跳过这一节)
接入飞书前需要去社区安装飞书节点,因为n8n本身没有飞书节点,需要用插件的方式去安装,接下来是安装步骤
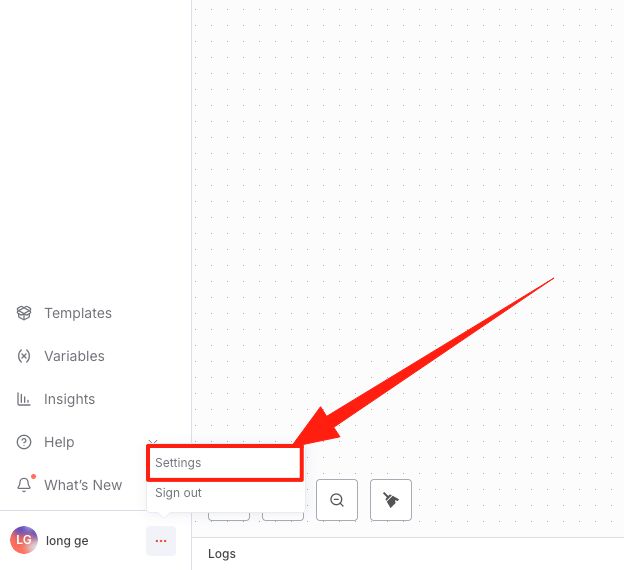
打开n8n主页,然后点下左下方的Settings
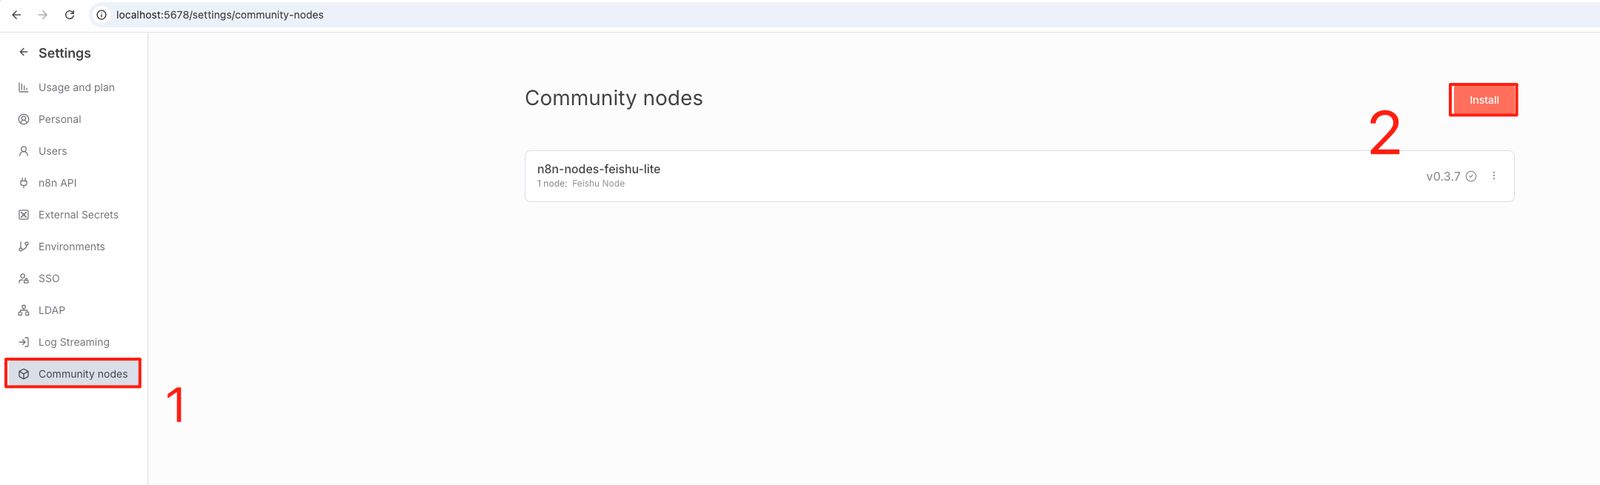
点击Community Nodes
点击安装
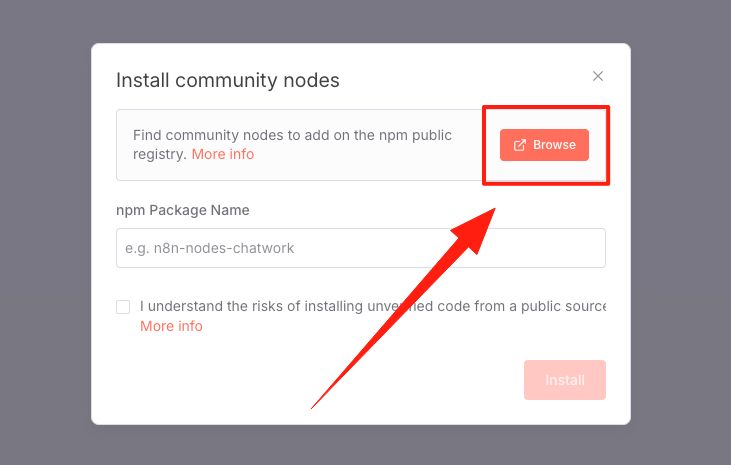
点击Browser
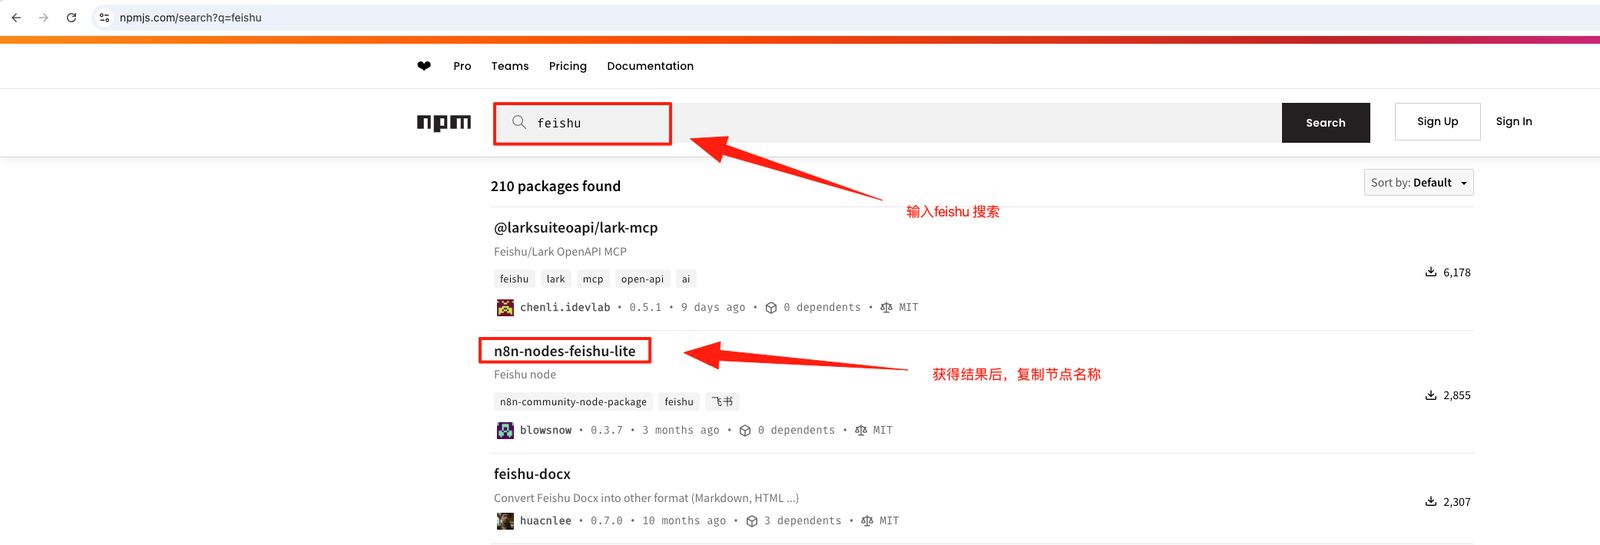
搜索框输入feishu
复制jiedian
填写节点:粘贴刚才复制的节点
同意条款
安装
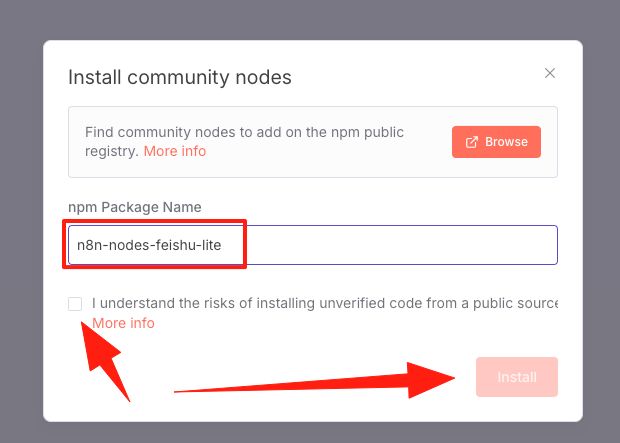
至此n8n就有了飞书节点
添加飞书新增记录节点
把上面的飞书节点安装好之后
再如右图
点击➕号
输入feishu
点击飞书Node
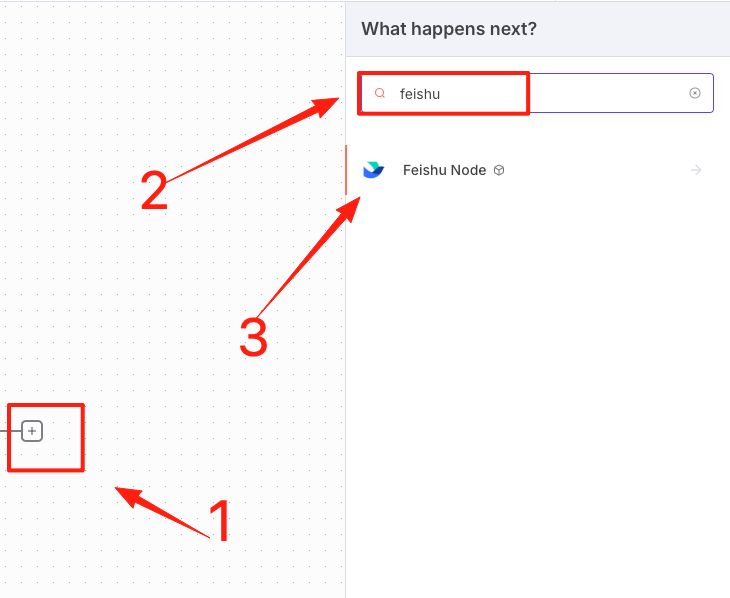
点击新增记录
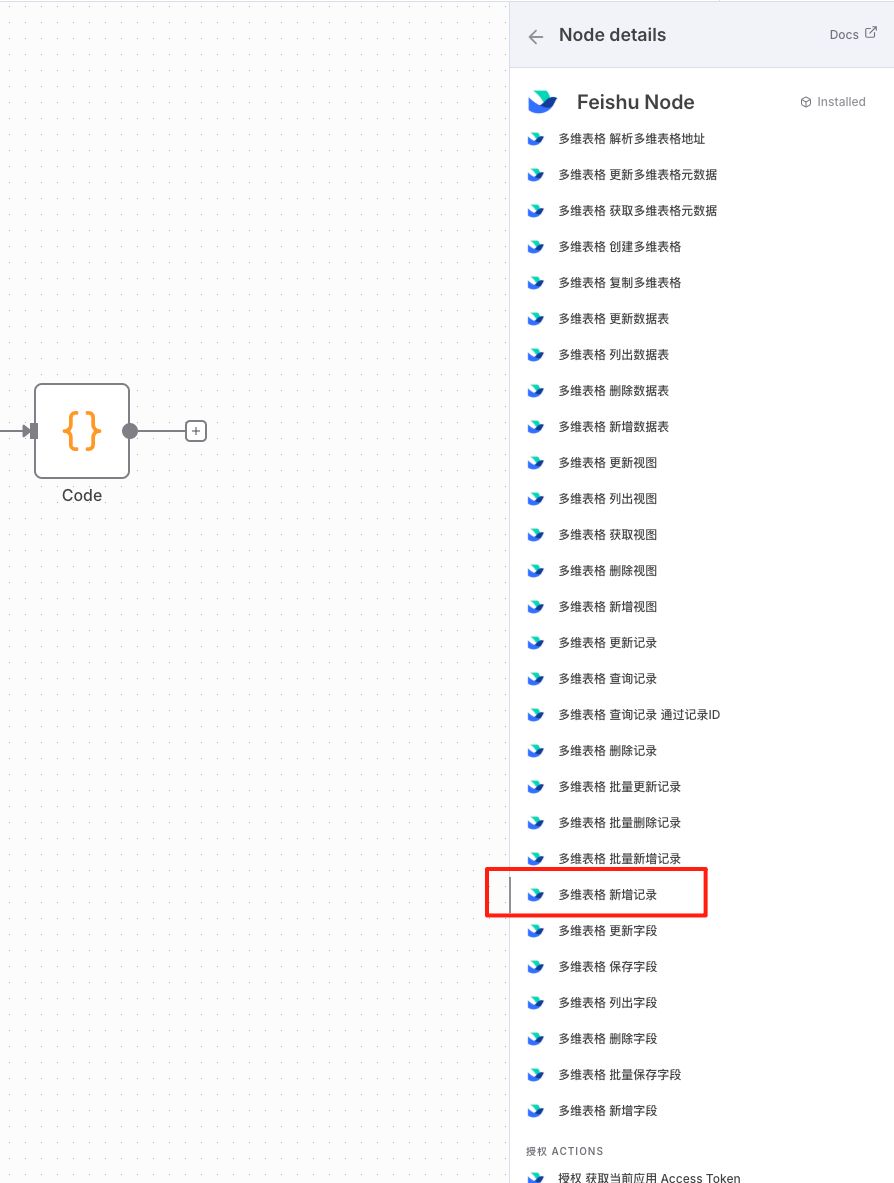
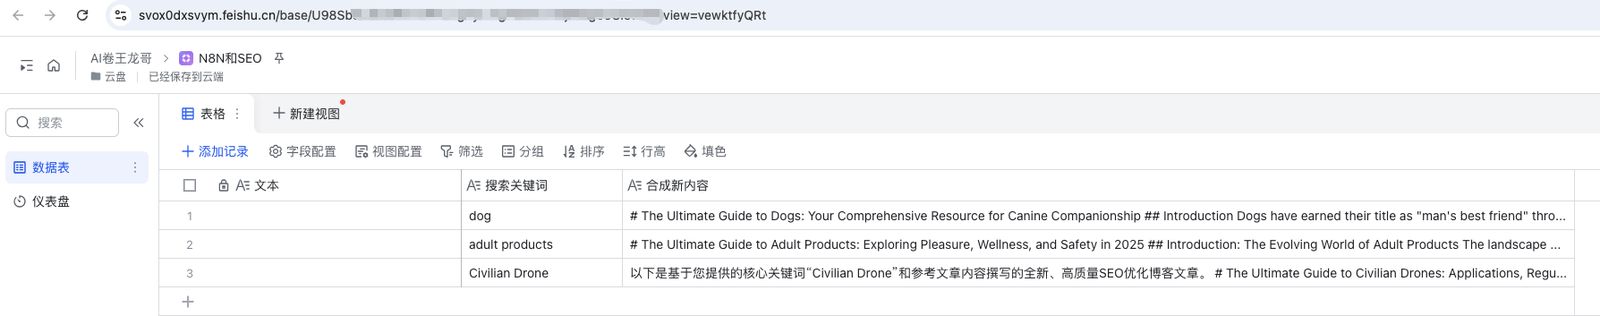
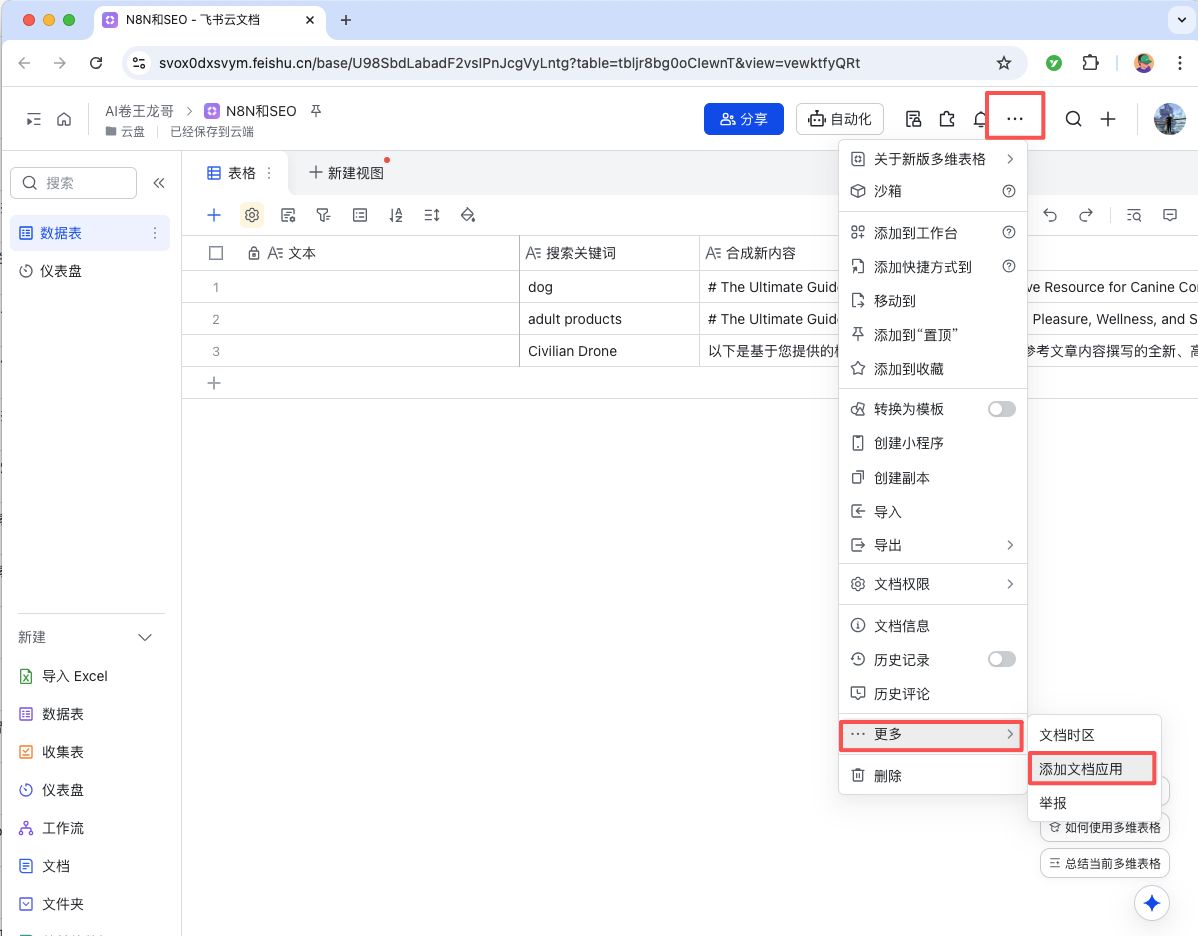
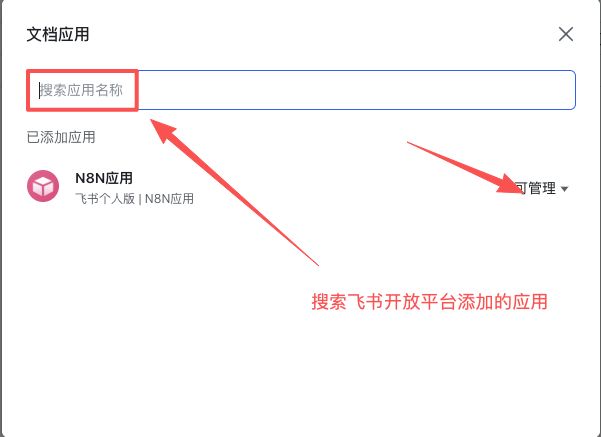
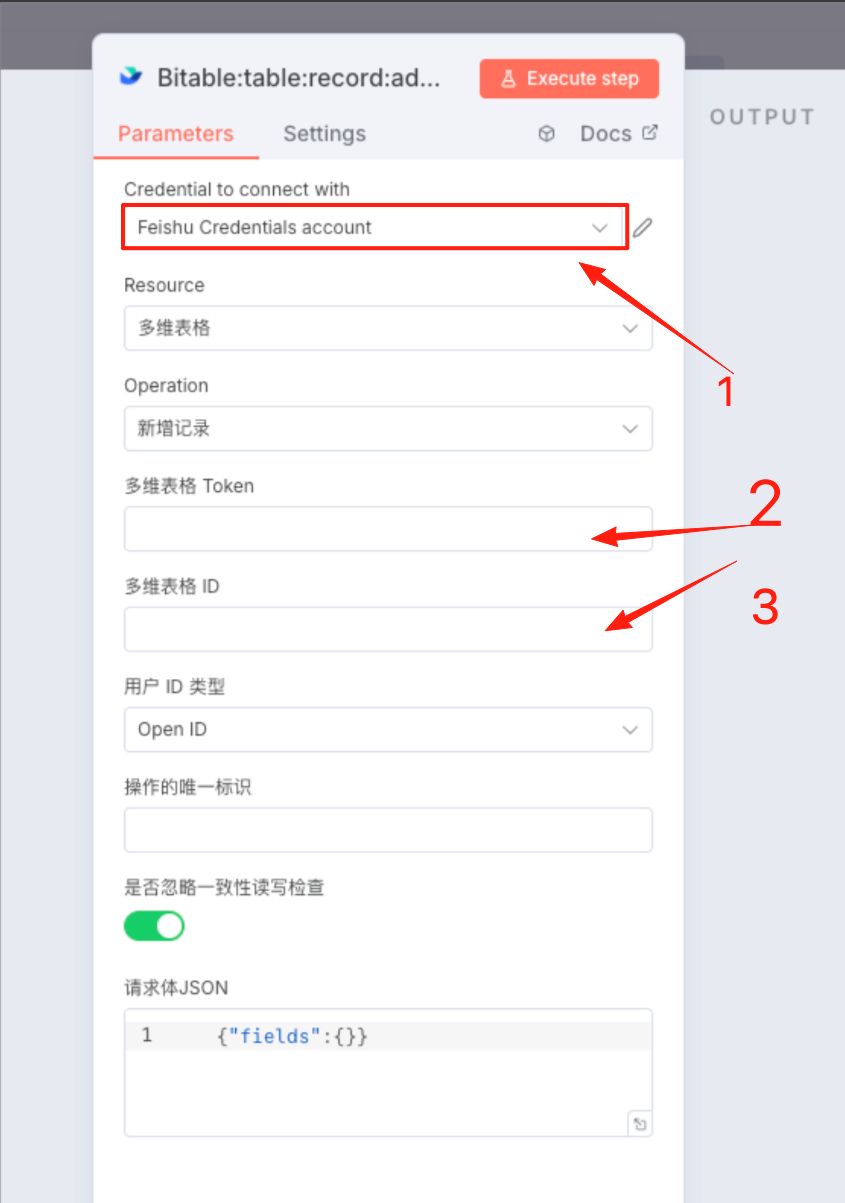
首先创建一个飞书多维表格,记得要在云盘里创建多维表格,然后更多里面关联应用,并添加应用
你可以复制我的多维表格结构
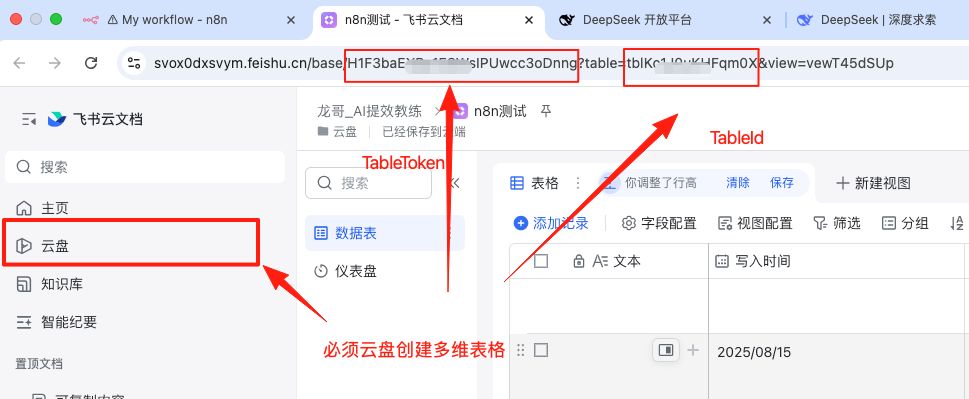
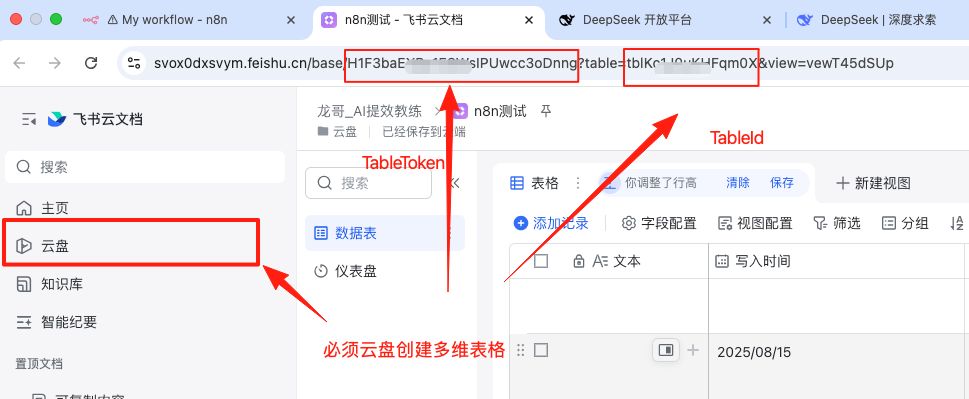
从多维表格浏览器地址中获取多维表格Token和TableId
然后打开链接获取多维表格Token和TableId
进入这个页面
图中的步骤2:
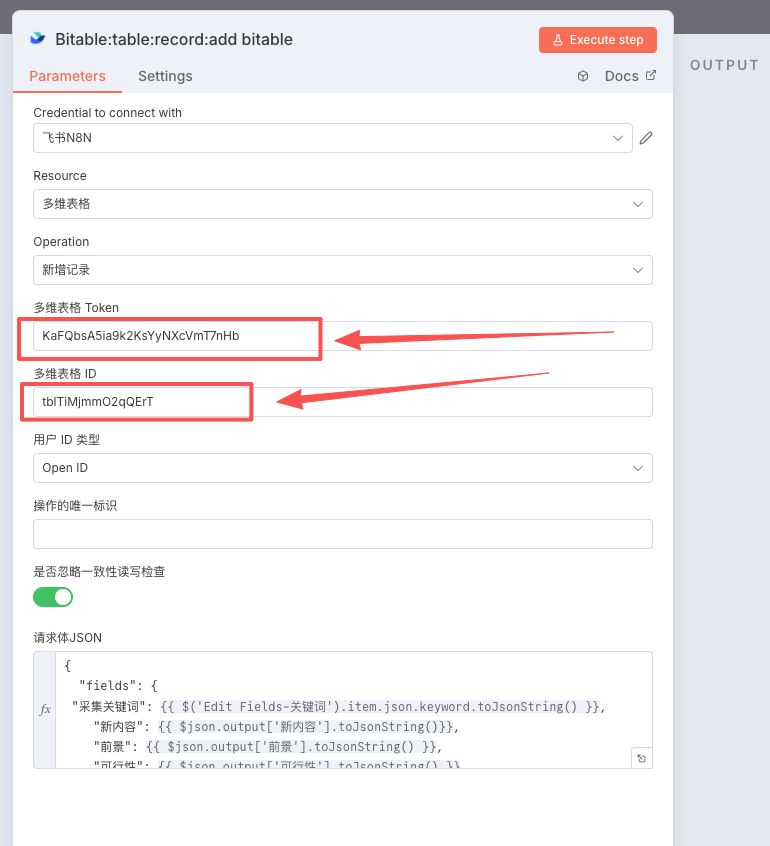
多维表格Token:如右图TableToken
多维表格ID:右图TableId
其余的OPen ID不用管
唯一标识不用管
请求体Json
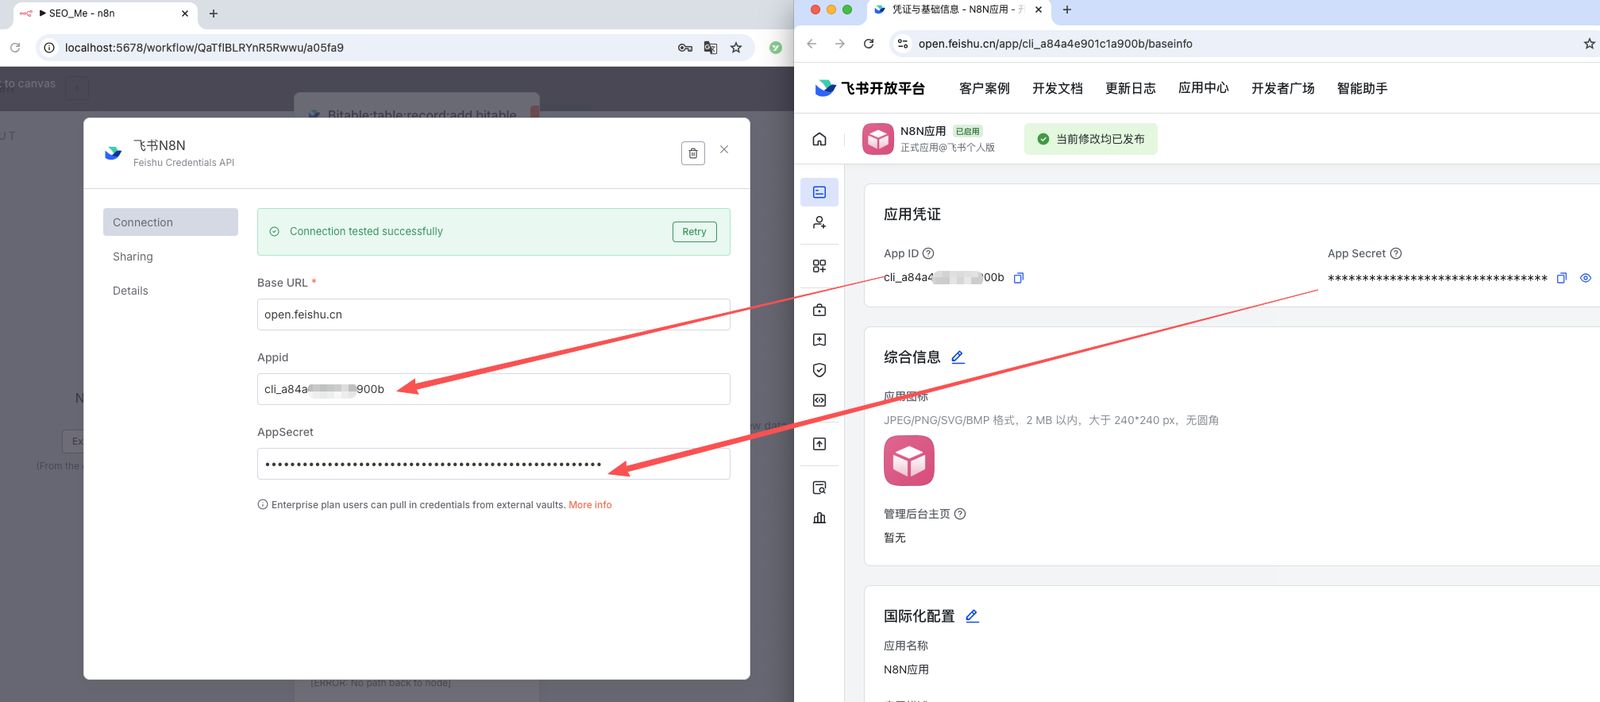
获取飞书AppId和AppSecret教程,
点击:
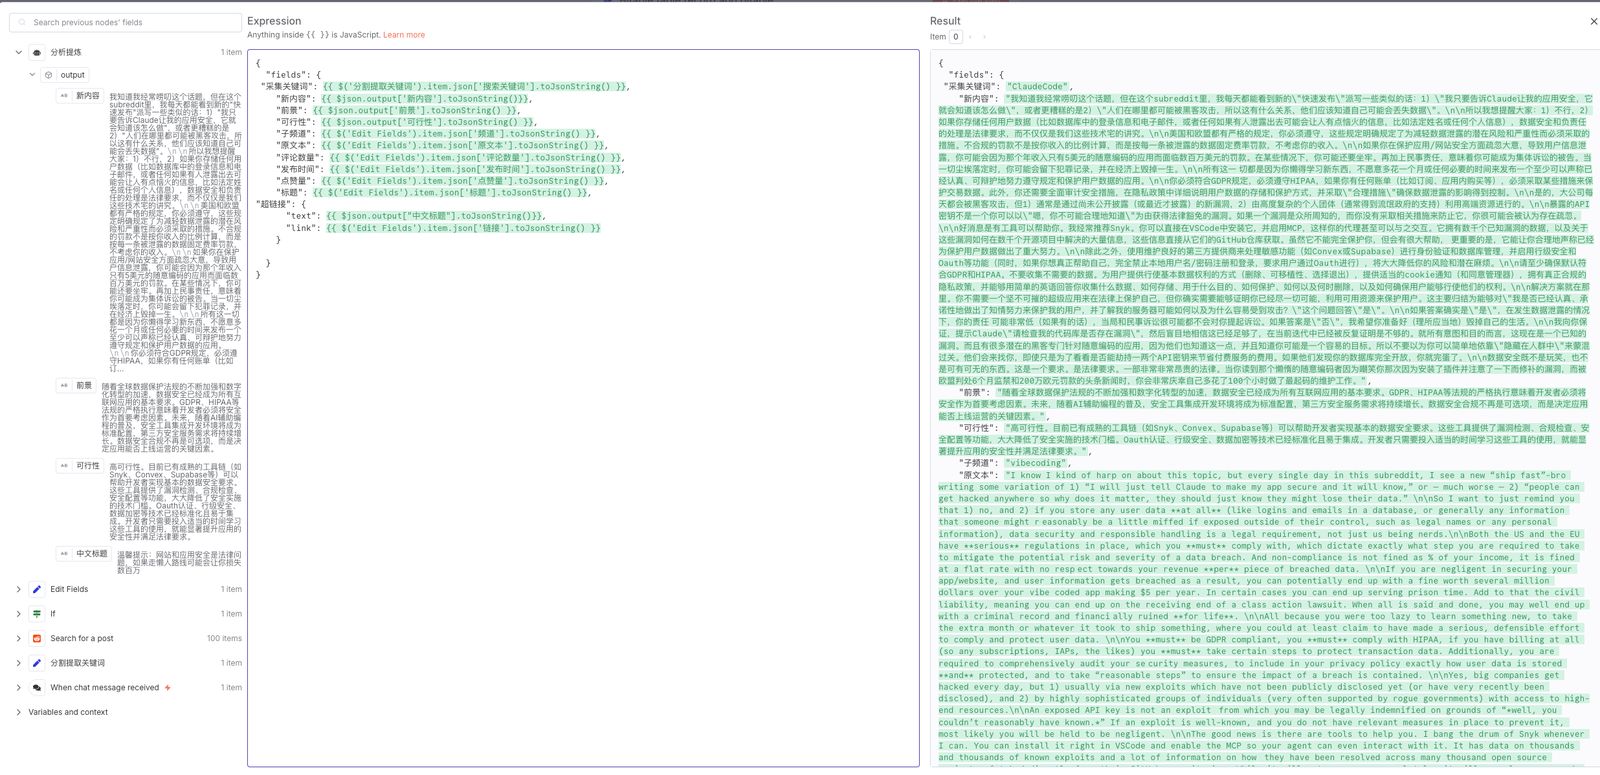
配置节点数据
代码块:
点中关键词,拖拽到代码块中
原文和大模型改写后,这两个字段对应我多维表格的列名
点击红色按钮运行,完美出结果
注意:字段后面需要补上toJsonString()
{
"fields": {
"采集关键词": {{ $(‘分割提取关键词’).item.json[‘搜索关键词’].toJsonString() }},
"新内容": {{ $json.output[‘新内容’].toJsonString()}},
"前景": {{ $json.output[‘前景’].toJsonString() }},
"可行性": {{ $json.output[‘可行性’].toJsonString() }},
"子频道": {{ $(‘Edit Fields’).item.json[‘频道’].toJsonString() }},
"原文本": {{ $(‘Edit Fields’).item.json[‘原文本’].toJsonString() }},
"评论数量": {{ $(‘Edit Fields’).item.json[‘评论数量’].toJsonString() }},
"发布时间": {{ $(‘Edit Fields’).item.json[‘发布时间’].toJsonString() }},
"点赞量": {{ $(‘Edit Fields’).item.json[‘点赞量’].toJsonString() }},
"标题": {{ $(‘Edit Fields’).item.json[‘标题’].toJsonString() }},
"超链接": {
"text": {{ $json.output["中文标题"].toJsonString()}},
"link": {{ $(‘Edit Fields’).item.json[‘链接’].toJsonString() }}
}
}
}
测试环节
输入N8N#Youtube,这样就可以获得N8N子频道下Youtube关键词内容
数据展示
以上测试完毕,你也来试试吧!
 峤咚笔记